Hay muchas formas de generar un modelo, como regresión lineal básica, árboles de decisión, redes neuronales y modelos lineales generalizados. JMP Pro puede ser una gran herramienta para los mineros de datos, aquellos que desean obtener más información de sus datos y construir modelos predictivos más precisos. Incorpora algoritmos tradicionalmente complicados que, en verdad. JMP Moda, incluso un principiante puede aprovechar para construir rápidamente modelos potentes. Los bosques de bootstrap, los árboles reforzados y las redes neuronales reforzadas de múltiples capas son solo una muestra de las poderosas herramientas de JMP Pro. Una cosa que hace de JMP Pro una poderosa herramienta de minería de datos es la capacidad de construir, ajustar y probar su modelo en un solo paso.
Hace un tiempo, este blog presentaba una gran publicación sobre el concepto de Formación, validación y test. Conjuntos para construir tus modelos. Para crear un modelo que no solo sea descriptivo sino también predictivo, validar su modelo y, posteriormente, probarlo es esencial.
El primer paso, como se describe en la entrada del blog, fue dividir primero sus datos en tres grupos: capacitación, validación y partes de prueba. A continuación, construye un modelo basado en la parte de entrenamiento de sus datos que ha capturado el comportamiento de los datos (su sistema) y no solo el ruido. Una vez que haya creado un modelo legítimo, aplique ese modelo al conjunto de validación. Si ha creado un modelo que captura el comportamiento subyacente, debería obtener un comportamiento similar. Si no lo hace, tiene que volver y construir otro modelo; Este proceso puede ir y venir varias veces. Una vez que obtenga un modelo que ofrece un comportamiento similar en la validación construida con el conjunto de entrenamiento, espera que el modelo sea repetible, de modo que aplique el modelo al conjunto de prueba.
JMP Pro es un gran avance en la simplificación del proceso. La primera mejora introducida es una forma mucho más fácil de generar una columna de validación. Desde JMP, elija Cols -> New Column, Initialize Data -> Random -> Random Indicator. La columna Indicador aleatorio se establecerá de forma predeterminada en los valores 0 (Entrenamiento), 1 (Validación) y 2 (Prueba). Ahora puede elegir qué parte de los datos desea utilizar para cada paso.
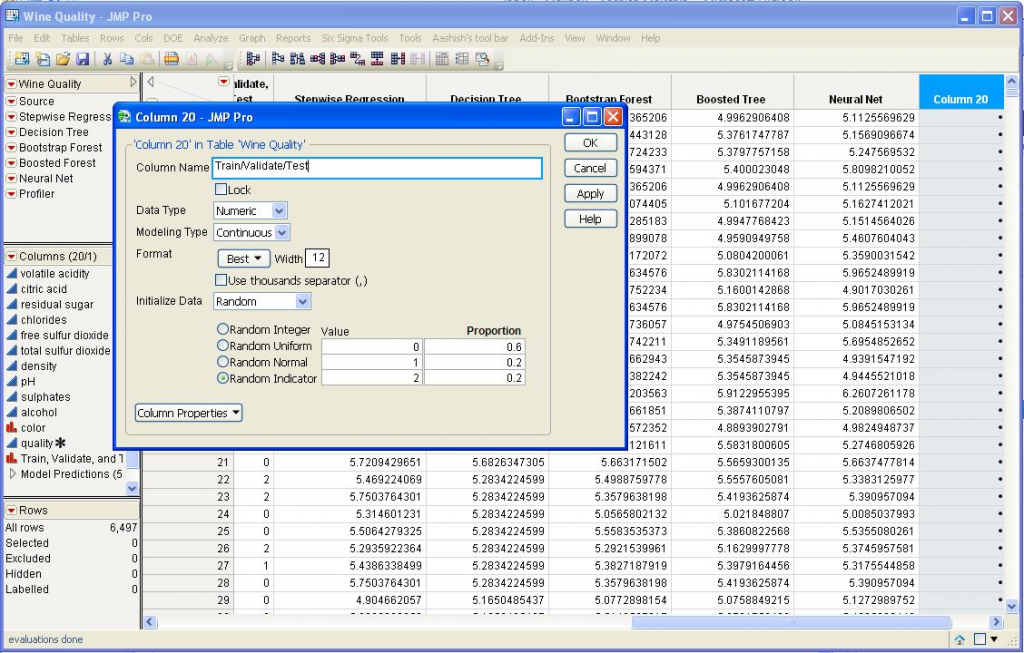
La mayoría de las plataformas de modelado en JMP Pro ahora tienen una opción para ingresar una columna de validación. Esto le permite completar el largo proceso de construcción, ajuste y prueba de sus modelos, como acabo de describir, en un solo paso. A medida que ingresa sus variables, elija su nueva columna como la opción de validación.

Un hecho de las estadísticas es que no todas las técnicas de modelado funcionan bien para todos los conjuntos de datos. Cada técnica tiene sus fortalezas y debilidades; Cada uno puede enseñarte algo diferente acerca de tus datos. Un punto fuerte de JMP Pro es que ofrece múltiples técnicas de modelado bajo un mismo techo. Puede probar cada algoritmo, evaluar su rendimiento e incluso guardar el modelo (fórmula de predicción) en la tabla de datos como una nueva columna. La versión 10 de JMP Pro ahora le permite comparar sus modelos una vez que se han construido.
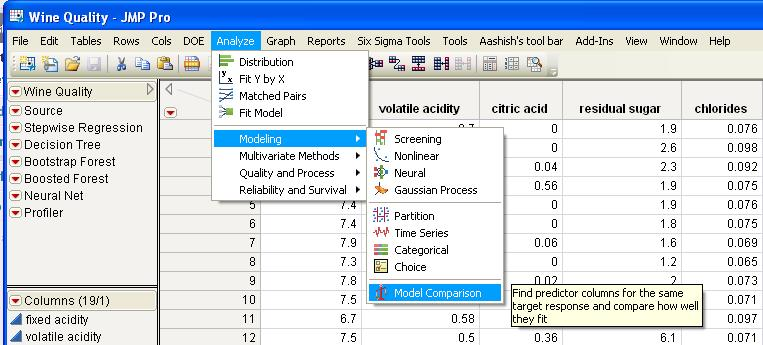
Ejecute la plataforma de comparación de modelos y elija los modelos que desea comparar (o deje que JMP los elija).
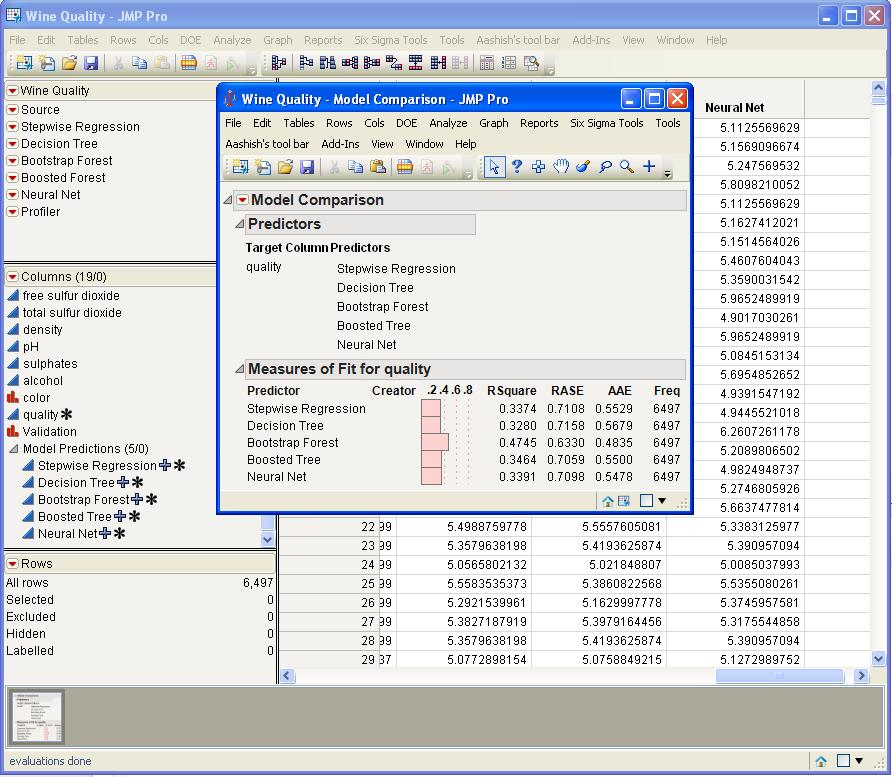
En este ejemplo, Bootstrap Forest parece haber generado el mejor modelo. Si varios modelos tienen estadísticas similares, otro método para ver los modelos es utilizar la plataforma interactiva de perfiles. No solo le permite desarrollar una comprensión intuitiva de cómo funciona el modelo, sino que también muestra cómo las múltiples entradas pueden afectar la salida. Usted puede Descarga los datos que utilicé en este blog. desde el intercambio de archivos JMP y pruébalo tú mismo! (Nota: la descarga requiere un perfil SAS gratuito).
Mrinal escribió:
¿Es posible realizar una validación cruzada en JMP para regresión, red neuronal y modelo de proceso gaussiano?
Mohammad Mirwais escribió:
Estimado señor o Modam, soy un estudiante nuevo y quiero hacer un modelo para el conjunto de datos que tengo ahora. Soy nuevo con JMP. ¿Cómo debería encontrar una manera de enseñarme paso a paso a hacer el modelo para los datos que ¿Yo tengo?
Tu coporación será mucho más apreciada.
Craig Burkhart escribió:
Arka,
Los conjuntos de entrenamiento, validación y prueba normalmente entran en juego para técnicas como las redes neuronales y sus técnicas asociadas. En la regresión de red neuronal estándar, el conjunto de entrenamiento se usa activamente para crear el modelo real. El propósito del conjunto de validación es indicar el paso de construcción del modelo cuándo debe detenerse la capacitación. Normalmente, una métrica de la calidad del modelo, por ejemplo, rms error, se muestrea en el conjunto de validación. Una vez que el error de rms en función del número de iteraciones (o épocas en lenguaje de red neuronal) se aplana para el conjunto de validación, los algoritmos de red neuronal típicos se muestran cuando el error rms comienza levantar. Si el aumento continúa durante la duración de una época determinada, por ejemplo, 5-10 épocas, la optimización se detiene y vuelve al punto justo antes de que ocurriera la subida . Dado que el algoritmo de regresión utilizó el conjunto de validación para detectar este punto final, técnicamente no se puede usar como prueba del valor predictivo del modelo. Ahí es donde entra en juego el set de prueba estándar.
Arka escribió:
Gracias Aashish. Esto parece realmente útil. Le preguntaré por qué necesita un conjunto de datos de validación y luego un conjunto de prueba. Parecen cumplir la misma función. ¿Es cuestión de pasar el modelo a través de 2 filtros para ver su valor predictivo?
