기본 선형 회귀, 의사 결정 트리, 신경망 및 일반화 된 선형 모델과 같은 모델을 생성하는 많은 방법이 있습니다. JMP Pro 데이터 마이너, 데이터에서 더 많은 정보를 얻고 더 정확한 예측 모델을 만들고자하는 사람들에게 훌륭한 도구가 될 수 있습니다. 그것은 전통적으로 복잡한 알고리즘을 포함하고 있습니다. JMP 심지어 초보자도 강력한 모델을 빠르게 만들 수 있습니다. 부트 스트랩 숲, 부양 된 나무 및 다층 강화 신경망은 JMP Pro의 강력한 도구 중 하나입니다. JMP Pro를 강력한 데이터 마이닝 도구로 만드는 한 가지 방법은 모델을 한 단계로 작성, 조정 및 테스트하는 것입니다.
잠시 후,이 블로그는 교육, 검증 및 테스트 모델을 빌드하도록 설정합니다. 설명 적이며 예측적일뿐만 아니라 모델의 유효성을 검증하고 테스트하는 모델을 구축하는 것이 필수적입니다.
첫 번째 단계는 블로그 항목에 설명 된대로 데이터를 먼저 교육, 검증 및 테스트 부분의 세 그룹으로 분리하는 것입니다. 다음으로, 노이즈뿐 아니라 데이터 (시스템)의 동작을 캡처 한 데이터의 교육 부분을 기반으로 모델을 작성합니다. 일단 합법적 인 모델을 찾았 으면 그 모델을 유효성 검증 세트에 적용합니다. 기본 동작을 캡처하는 모델을 만든 경우 비슷한 동작이 발생해야합니다. 그렇지 않으면 돌아가서 다른 모델을 만들어야합니다. 이 과정은 몇 번 앞뒤로 갈 수 있습니다. 교육 세트로 구축 된 유효성 검사에서 유사한 동작을하는 모델을 얻은 후에는 모델을 반복 할 수 있으므로 모델을 테스트 세트에 적용 할 수 있습니다.
JMP Pro는 프로세스를 간소화하는 획기적인 발전입니다. 도입 된 첫 번째 개선 사항은 유효성 검사 열을 생성하는 훨씬 쉬운 방법입니다. JMP에서 Cols -> New Column, Initialize Data -> Random -> Random Indicator를 선택하십시오. 무작위 표시기 열의 값은 기본적으로 0 (교육), 1 (유효성 검사) 및 2 (테스트)입니다. 이제 각 단계에서 사용할 데이터의 부분을 선택할 수 있습니다.
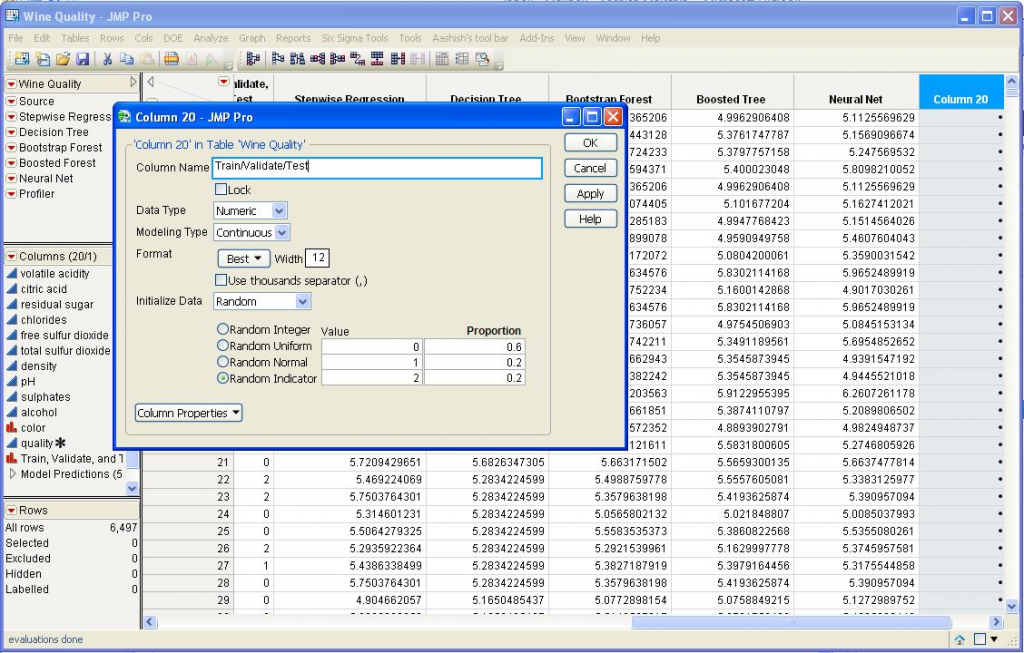
JMP Pro의 대부분의 모델링 플랫폼에는 이제 유효성 검사 열을 입력하는 옵션이 있습니다. 이렇게하면 앞에서 설명한대로 모델 작성, 튜닝 및 테스트의 긴 프로세스를 한 단계만으로 완료 할 수 있습니다. 변수를 입력 할 때 새로 만든 열을 유효성 검사 옵션으로 선택하십시오.

통계의 한 가지 사실은 모든 모델링 기술이 모든 데이터 세트에서 잘 작동하는 것은 아니라는 것입니다. 각 기술에는 장점과 단점이 있습니다. 각자가 여러분의 데이터에 대해 다른 것을 가르쳐 줄 수 있습니다. JMP Pro의 한 가지 강점은 하나의 지붕 아래 여러 모델링 기술을 제공한다는 것입니다. 각 알고리즘을 시험해보고 성능을 평가하고 모델 (예측 수식)을 새 열로 데이터 테이블에 저장할 수도 있습니다. JMP Pro 버전 10을 사용하면 모델을 작성한 후에 모델을 비교할 수 있습니다.
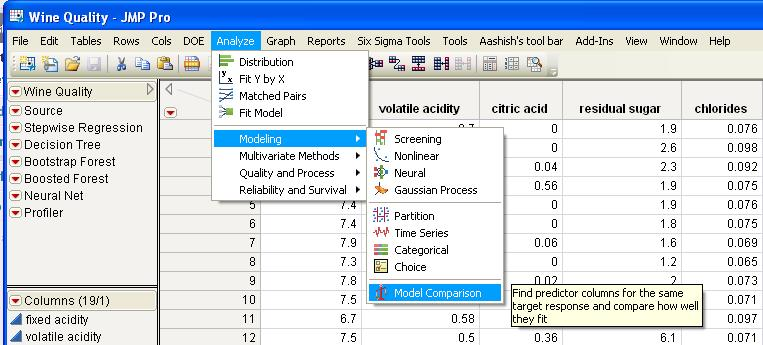
모델 비교 플랫폼을 실행하고 비교할 모델을 선택하십시오 (또는 JMP에서 선택하도록하십시오).
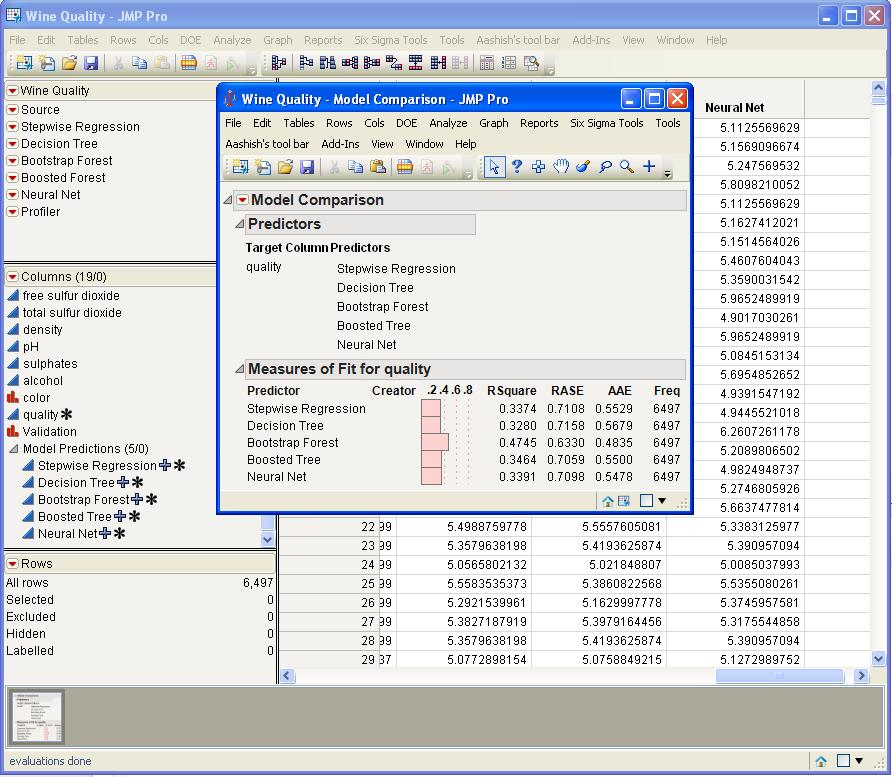
이 예제에서 Bootstrap Forest는 최상의 모델을 생성 한 것 같습니다. 여러 모델의 통계가 비슷한 경우 모델을 보는 또 다른 방법은 대화 형 프로파일 러 플랫폼을 사용하는 것입니다. 모델 작동 방식을 직관적으로 이해할 수있을뿐 아니라 여러 입력을 다양하게 조절할 때 출력에 어떤 영향을 미치는지 보여줍니다. 너는 할 수있다. 이 블로그 게시물에 사용한 데이터를 다운로드하십시오. JMP File Exchange에서 직접 체험 해보십시오! (참고 : 다운로드하려면 무료 SAS 프로파일이 필요합니다.)
주니 널 쓴 :
회귀 분석, 신경 네트워크 및 가우시안 프로세스 모델에 대해 JMP에서 교차 유효성 검사를 수행 할 수 있습니까?
Arati Mejdal 쓴 :
안녕하세요, 모하메드,
건물 모델에 관한이 비디오는 다음과 같은 경우에 도움이 될 수 있습니다. http://www.jmp.com/en_us/events/ondemand/building-better-models.html
행운을 빕니다!
모하마드 미르와 이스 쓴 :
친애하는 각하 또는 Modam, 나는 새로운 학생이고 나가 지금 나는 JMP에 새로운 자료 집합을위한 modle를 만들고 싶다. 나는 가지고있다?
당신의 coporation 훨씬 더 감사하게 될 것입니다.
크레이그 버크 하트 쓴 :
아르카,
교육, 검증 및 테스트 세트는 일반적으로 신경 네트워크 및 관련 기술과 같은 기술에 적용됩니다. 표준 신경망 회귀 분석에서 훈련 세트는 실제 모델을 생성하는 데 적극적으로 사용됩니다. 검증 세트의 목적은 모델 구축 단계에서 교육을 중단 할시기를 알려주는 것입니다. 일반적으로 모델의 품질 메트릭, 즉 rms 오류는 유효성 검사 집합에서 샘플링됩니다. rms 오류가 반복 횟수의 함수 (또는 신기원 신경 네트워크에서 말하기) 유효성 검사 세트를 위해 평평하게 만들 때, 전형적인 신경 네트워크 알고리즘 샘플은 rms 오류 시작하다 일어 나라. 일부 에포크 길이 (예 : 5-10 에포크) 동안 상승이 계속되면 최적화가 중지되고 지점으로 되돌아갑니다 상승이 일어나기 직전 . 회귀 알고리즘은이 끝점을 감지하기 위해 유효성 검사 집합을 사용했기 때문에 기술적으로 모델 예측 값 테스트로 사용할 수 없습니다. 그것이 표준 테스트 세트가 작동하는 곳입니다.
아르카 쓴 :
감사합니다 Aashish. 이것은 정말로 유용합니다. 검증 데이터 세트가 필요한 이유와 테스트 세트가 필요한 이유를 묻습니다. 그들은 동일한 기능을 수행하는 것으로 보입니다. 예측 가치를보기 위해 모델을 2 개의 필터를 통과시키는 문제입니까?
