基本線形回帰、決定木、ニューラルネット、一般化線形モデルなど、モデルを生成する方法はたくさんあります。 JMP Pro データマイナー、データからより多くの情報を得て、より正確な予測モデルを構築したい人にとって、これは優れたツールになります。これは、伝統的に複雑なアルゴリズムを組み込んでいます。 JMP ファッションは、初心者でもすぐに強力なモデルを構築するために利用することができます。ブートストラップフォレスト、ブーストツリー、多層ブーストニューラルネットは、JMP Proの強力なツールのほんの一例です。JMP Proを強力なデータマイニングツールにすることの1つは、モデルを1ステップで構築、調整、およびテストする能力です。
しばらく前に、このブログではの概念に関する素晴らしい記事を掲載しました。トレーニング、検証、テストモデルを構築するために設定します。 記述的であるだけでなく予測的でもあるモデルを構築し、モデルを検証し、その後それをテストすることが不可欠です。
ブログのエントリで説明されているように、最初のステップは、まずデータを3つのグループに分類することでした。トレーニング、検証、テスト部分です。次に、ノイズだけでなく、データ(システム)の動作をキャプチャしたデータのトレーニング部分に基づいてモデルを構築します。正当なモデルを見つけたら、そのモデルを検証セットに適用します。根本的な振る舞いを捉えるモデルを構築したのなら、同様の振る舞いをするはずです。そうでない場合は、戻って別のモデルを構築する必要があります。このプロセスは数回行ったり来たりすることがあります。トレーニングセットで構築された検証で同様の動作をするモデルを取得したら、そのモデルは再現可能であると予想されるので、そのモデルをテストセットに適用します。
JMP Proは、プロセスを簡素化する上で大きな進歩を遂げました。最初に導入された機能強化は、検証列を生成するためのはるかに簡単な方法です。JMPから、「Cols」 - >「New Column」、「Initialize Data」 - >「Random」 - >「Random Indicator」の順に選択します。[Random Indicator]列のデフォルトは0(トレーニング)、1(検証)、2(テスト)です。各ステップでデータのどの部分を使用するのかを選択できます。
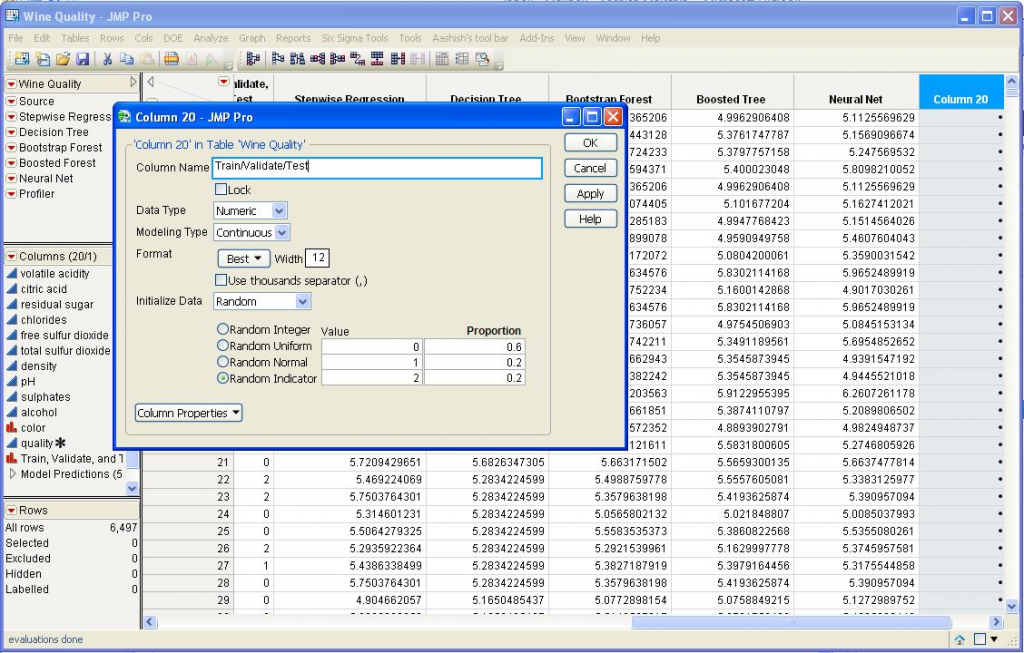
JMP Proのほとんどのモデリングプラットフォームには、検証列を入力するオプションがあります。これにより、上で説明したように、1つの簡単なステップで、モデルの構築、調整、およびテストの長いプロセスを完了することができます。変数を入力しているときに、検証オプションとして新しく作成した列を選択します。

統計の1つの事実は、すべてのモデリング手法がすべてのデータセットに対してうまく機能するわけではないということです。各手法にはそれぞれ長所と短所があります。一人一人があなたのデータについて異なる何かを教えることができます。 JMP Proの1つの強みは、1つの屋根の下で複数のモデリング手法を提供することです。各アルゴリズムを試してその性能を評価し、モデル(予測式)を新しい列としてデータテーブルに保存することもできます。 JMP Proバージョン10では、構築後のモデルを比較できるようになりました。
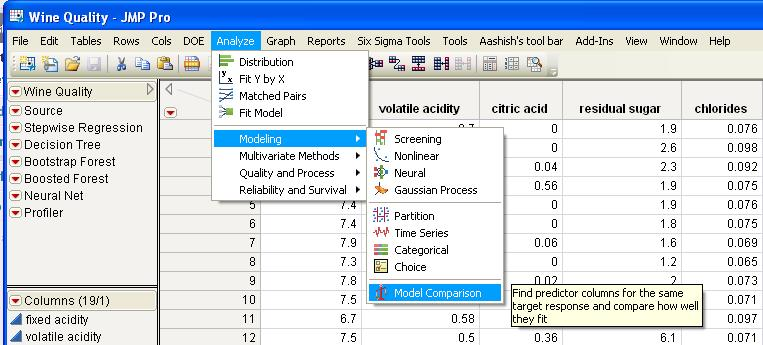
モデル比較プラットフォームを実行して、比較したいモデルを選択します(またはJMPに選択させます)。
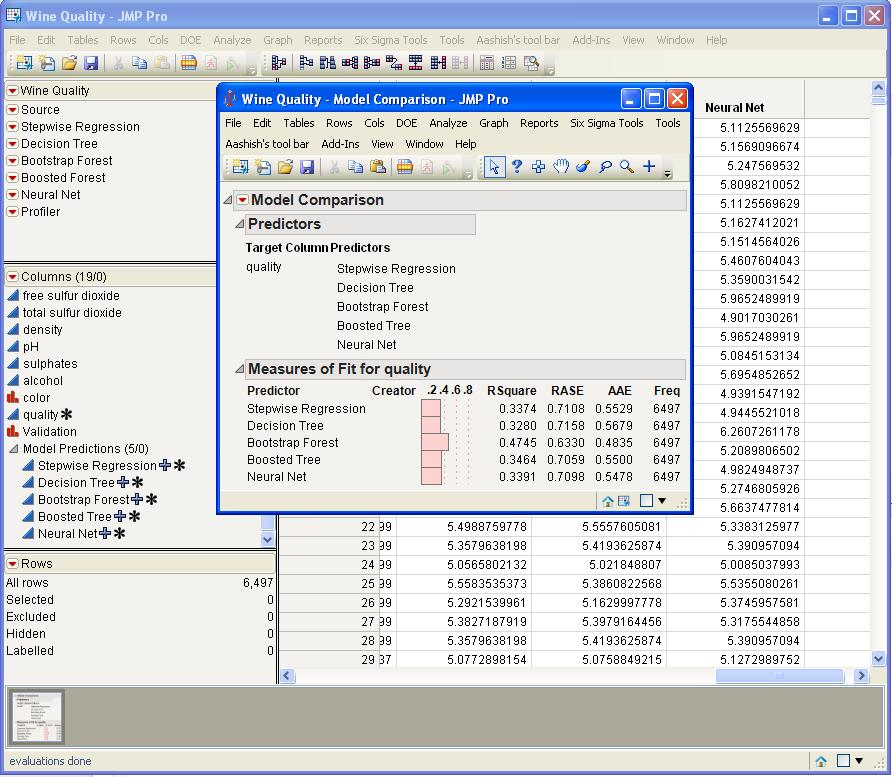
この例では、ブートストラップフォレストが最良のモデルを生成したようです。複数のモデルの統計が似ている場合、モデルを表示するもう1つの方法は対話型プロファイラープラットフォームを使用することです。それはあなたがモデルがどのように働くかについて直観的な理解を発展させることを可能にするだけでなく、それはまたどのように複数の入力が出力に影響を与えることができるかを示します。あなたはできるこのブログ記事で使用したデータをダウンロードする JMPファイル交換から、自分で試してみてください。(注:ダウンロードには無料のSASプロファイルが必要です。)
ミナル書きました:
回帰、ニューラルネットワーク、およびガウス過程モデルについてJMPで相互検証を行うことはできますか?
アラティ・メイダル書きました:
こんにちは、Mohammed、
モデル構築に関するこれらのビデオはあなたを助けるかもしれません: http://www.jmp.com/en_us/events/ondemand/building-better-models.html
がんばろう!
モハマドミルワイス書きました:
親愛なるサーまたはモダム、私は新しい学生です、私は今私が持っているデータセットのためのmodleを作りたいと思います私は持っています?
あなたのcoporationははるかに高く評価されるでしょう。
クレイグ・バークハート書きました:
アルカ、
トレーニング、検証およびテストセットは、通常、ニューラルネットワークやその関連技術などの技術に役立ちます。標準的なニューラルネットワーク回帰では、トレーニングセットは実際のモデルを作成するために積極的に使用されます。検証セットの目的は、トレーニングをいつ停止するかをモデル構築ステップに指示することです。通常、モデルの品質の測定基準(rms errorなど)が検証セットでサンプリングされます。反復回数の関数としてのrmsエラーエポック一般的なニューラルネットワークのアルゴリズムであるrmsエラーは、ニューラルネットワークでは検証セットに対して平坦化されます。始まる上る・昇る。5〜10エポックなど、指定されたエポック長まで上昇が続くと、最適化は中止され、その時点まで戻ります。上昇が発生する直前 。回帰アルゴリズムはこの終点を検知するためにバリデーションセットを使用していたので、技術的にはモデル予測値のテストとして使用することはできません。それが標準テストセットが登場するところです。
アルカ書きました:
Aashishありがとう。これは本当に便利に見えます。検証データセットが必要で、次にテストセットが必要なのはなぜでしょうか。それらは同じ機能を果たすようです。その予測値を見るためにモデルを2つのフィルターに通すのは問題ですか?
