Esistono molti modi per generare un modello come regressione lineare di base, alberi decisionali, reti neurali e modelli lineari generalizzati. JMP Pro può essere un ottimo strumento per i minatori di dati, coloro che desiderano ottenere maggiori informazioni dai loro dati e costruire modelli predittivi più accurati. Incorpora algoritmi tradizionalmente complicati che, in verità JMP moda, anche un novizio può sfruttare per costruire rapidamente modelli potenti. Foreste Bootstrap, alberi potenziati e reti neurali potenziate a più strati sono solo alcuni esempi dei potenti strumenti di JMP Pro. Una cosa che rende JMP Pro un potente strumento di data mining è la capacità di costruire, mettere a punto e testare il tuo modello in un solo passaggio.
Qualche tempo fa, questo blog presentava un ottimo post sul concetto di formazione, validazione e test imposta per costruire i tuoi modelli. Costruire un modello non solo descrittivo ma anche predittivo, convalidare il modello e successivamente testarlo è essenziale.
Il primo passo, come descritto nel post di blog, consisteva nel dividere inizialmente i dati in tre gruppi: formazione, convalida e parti di test. Successivamente, si costruisce un modello basato sulla porzione di addestramento dei dati che ha catturato il comportamento dei dati (il sistema) e non solo il rumore. Una volta creato un modello legittimo, si applica tale modello al set di convalida. Se hai creato un modello che cattura il comportamento sottostante, dovresti ottenere un comportamento simile. Se non lo fai, devi tornare indietro e costruire un altro modello; questo processo può andare avanti e indietro alcune volte. Una volta ottenuto un modello che fornisce un comportamento simile nella convalida costruita con il set di allenamento, ci si aspetta che il modello sia ripetibile in modo da applicare il modello al set di test.
JMP Pro è un'enorme innovazione nella semplificazione del processo. Il primo miglioramento introdotto è un modo molto più semplice di generare una colonna di convalida. Da JMP, selezionare Cols -> Nuova colonna, Inizializza dati -> Casuale -> Indicatore casuale. La colonna Indicatore casuale imposterà i valori 0 (Allenamento), 1 (Convalida) e 2 (Test). Ora puoi scegliere quale parte dei dati desideri utilizzare per ogni passaggio.
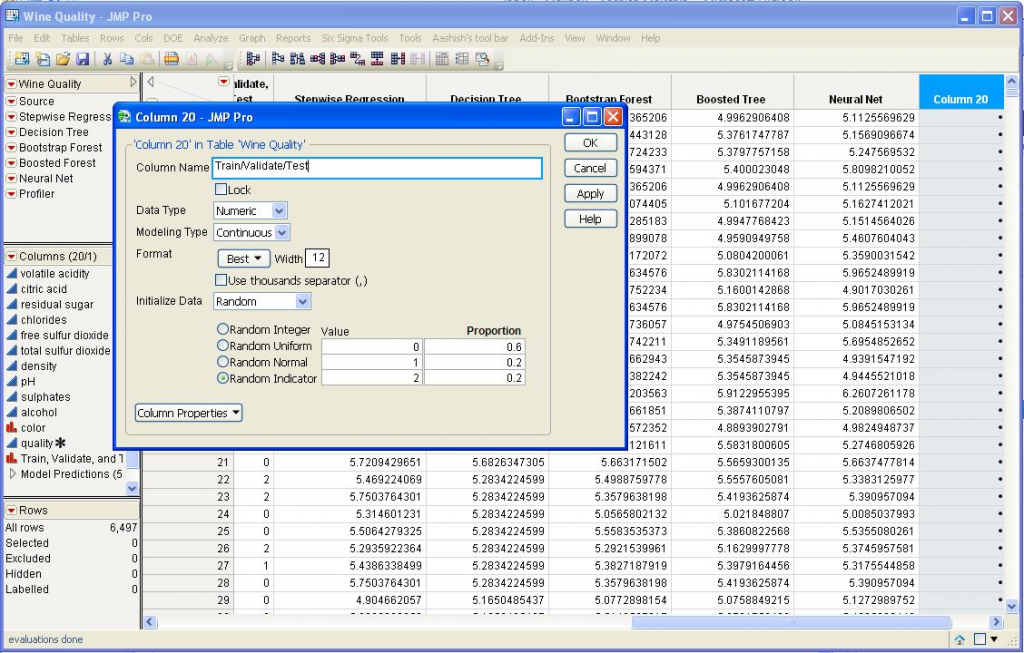
La maggior parte delle piattaforme di modellazione in JMP Pro ora ha un'opzione per inserire una colonna di convalida. Questo ti consente di completare il lungo processo di costruzione, messa a punto e test dei tuoi modelli, come ho appena descritto sopra, con un semplice passaggio. Mentre stai inserendo le tue variabili, scegli la colonna appena creata come opzione di convalida.

Un dato di fatto è che non tutte le tecniche di modellazione funzionano bene per tutti i set di dati. Ogni tecnica ha i suoi punti di forza e di debolezza; ognuno può insegnarti qualcosa di diverso sui tuoi dati. Un punto di forza di JMP Pro è che offre molteplici tecniche di modellazione sotto lo stesso tetto. Puoi provare ogni algoritmo, valutarne le prestazioni e persino salvare il modello (formula di predizione) nella tabella dati come una nuova colonna. La versione 10 di JMP Pro ora ti consente di confrontare i tuoi modelli una volta che sono stati creati.
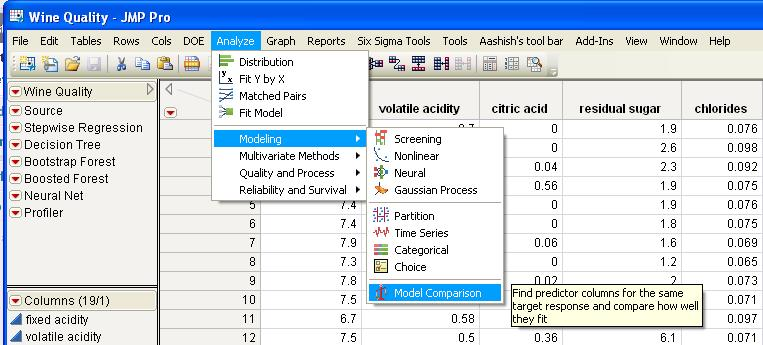
Esegui la piattaforma Confronto modelli e scegli i modelli che vuoi confrontare (o lascia che siano JMP a sceglierli).
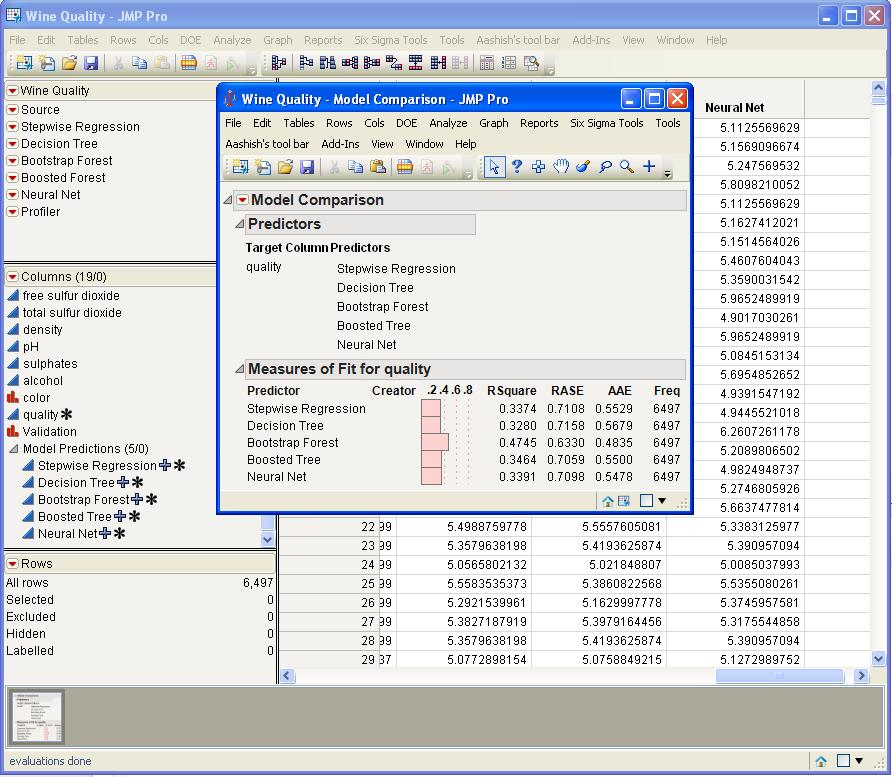
In questo esempio, sembra che la foresta di Bootstrap abbia generato il modello migliore. Se più modelli hanno statistiche simili, un altro metodo per visualizzare i modelli è utilizzare la piattaforma interattiva di Profiler. Non solo consente di sviluppare una comprensione intuitiva di come funziona il modello, ma mostra anche come la variazione di più input possa influire sull'output. Puoi scarica i dati che ho usato in questo post del blog da JMP File Exchange e provalo tu stesso! (Nota: il download richiede un profilo SAS gratuito.)
Mrinal ha scritto:
È possibile eseguire la convalida incrociata in JMP per Regressione, Rete neurale e Modello di processo gaussiano?
Mohammad Mirwais ha scritto:
Gentile Signore o Modam, sono un nuovo studente e voglio fare un modle per il set di dati che ho ora Sono nuovo con JMP come dovrei trovare un modo per insegnarmi passo dopo passo a fare il modle per i dati che Io ho?
La tua coporation sarà molto più apprezzata.
Craig Burkhart ha scritto:
Arka,
I set di allenamento, validazione e test entrano normalmente in gioco per tecniche come le reti neurali e le sue tecniche associate. Nella regressione standard della rete neurale, il set di allenamento viene utilizzato attivamente per creare il modello attuale. Lo scopo del set di validazione è di indicare al punto di costruzione del modello quando interrompere l'allenamento. In genere, una metrica della qualità del modello, ad esempio l'errore rms, viene campionata sul set di convalida. Una volta l'errore rms in funzione del numero di iterazioni (o epoche in rete neurale speak) si appiattisce per il set di validazione, il tipico esempio di algoritmi di rete neurale per quando l'errore rms inizia salire. Se l'aumento continua per una certa lunghezza d'epoca, ad esempio 5-10 epoche, l'ottimizzazione viene interrotta e riportata al punto poco prima che si verificasse l'ascesa . Poiché l'algoritmo di regressione ha utilizzato il set di validazione per rilevare questo endpoint, tecnicamente non può essere utilizzato come test del valore predittivo del modello. È qui che entra in gioco il set di test standard.
Arka ha scritto:
Grazie Aashish. Questo sembra davvero utile. Chiederò perché è necessario un set di dati di convalida e quindi un set di test. Sembrano avere la stessa funzione. Si tratta di passare il modello attraverso 2 filtri per vedere il suo valore predittivo?
