Es gibt viele Möglichkeiten, ein Modell zu generieren, z. B. grundlegende lineare Regression, Entscheidungsbäume, neuronale Netze und verallgemeinerte lineare Modelle. JMP Pro kann ein hervorragendes Werkzeug für Data Miner sein, die mehr Informationen aus ihren Daten herausholen und genauere Vorhersagemodelle erstellen möchten. Es enthält traditionell komplizierte Algorithmen, die wahr sind JMP Mode kann sogar ein Neuling nutzen, um schnell leistungsstarke Modelle zu erstellen. Bootstrap-Wälder, verstärkte Bäume und mehrschichtige verstärkte neuronale Netze sind nur ein Beispiel für die leistungsstarken Tools in JMP Pro. Was JMP Pro zu einem leistungsstarken Data Mining-Tool macht, ist die Möglichkeit, Ihr Modell in einem Schritt zu erstellen, abzustimmen und zu testen.
Vor einiger Zeit bot dieses Blog einen großartigen Beitrag zum Konzept von Schulung, Validierung und Test Sets, um Ihre Modelle zu bauen. Um ein Modell zu erstellen, das nicht nur deskriptiv, sondern auch vorausschauend ist, ist die Validierung und anschließende Prüfung des Modells von wesentlicher Bedeutung.
Der erste Schritt bestand, wie im Blogeintrag beschrieben, darin, Ihre Daten zunächst in drei Gruppen aufzuteilen: Training, Validierung und Testabschnitte. Als Nächstes erstellen Sie ein Modell auf der Grundlage des Trainingsabschnitts Ihrer Daten, der das Verhalten der Daten (Ihres Systems) erfasst hat, und nicht nur das Rauschen. Wenn Sie ein legitimes Modell erstellt haben, wenden Sie dieses Modell auf den Validierungssatz an. Wenn Sie ein Modell erstellt haben, das das zugrunde liegende Verhalten erfasst, sollten Sie ein ähnliches Verhalten erhalten. Wenn Sie dies nicht tun, müssen Sie ein anderes Modell erstellen. Dieser Vorgang kann einige Male hin und her gehen. Sobald Sie ein Modell erhalten, das in der mit dem Trainingssatz erstellten Validierung ein ähnliches Verhalten ergibt, erwarten Sie, dass das Modell wiederholbar ist, sodass Sie das Modell auf den Testsatz anwenden.
JMP Pro ist ein großer Durchbruch bei der Vereinfachung des Prozesses. Die erste eingeführte Erweiterung ist eine wesentlich einfachere Methode zum Generieren einer Validierungsspalte. Wählen Sie in JMP Cols -> New Column, Initialize Data -> Random -> Random Indicator. Die Spalte für Zufallsindikatoren enthält standardmäßig die Werte 0 (Training), 1 (Validierung) und 2 (Test). Sie können jetzt auswählen, welchen Teil der Daten Sie für jeden Schritt verwenden möchten.
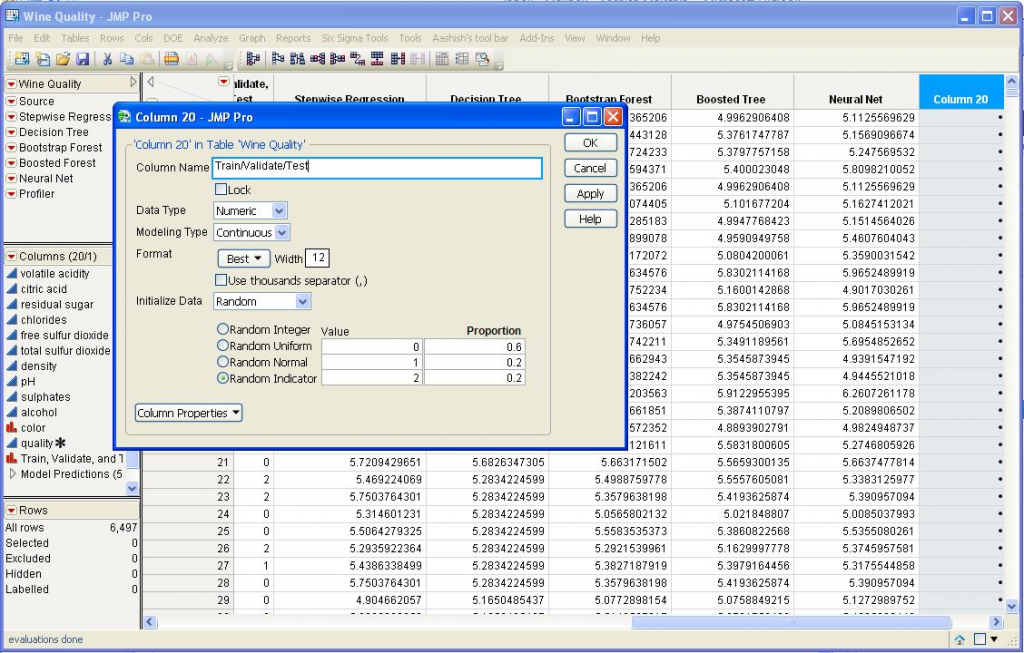
Die meisten Modellierungsplattformen in JMP Pro können jetzt eine Validierungsspalte eingeben. Auf diese Weise können Sie den langen Prozess des Erstellens, Abstimmens und Testens Ihrer Modelle wie oben beschrieben in einem einfachen Schritt abschließen. Wählen Sie bei der Eingabe Ihrer Variablen Ihre neu erstellte Spalte als Validierungsoption aus.

Eine Tatsache der Statistiken ist, dass nicht alle Modellierungstechniken für alle Datensätze gut funktionieren. Jede Technik hat ihre Stärken und Schwächen. Jeder kann Ihnen etwas anderes über Ihre Daten beibringen. Eine Stärke von JMP Pro ist, dass es mehrere Modellierungstechniken unter einem Dach bietet. Sie können jeden Algorithmus ausprobieren, die Leistung bewerten und sogar das Modell (Vorhersageformel) in der Datentabelle als neue Spalte speichern. Mit JMP Pro Version 10 können Sie jetzt Ihre Modelle vergleichen, sobald sie fertiggestellt sind.
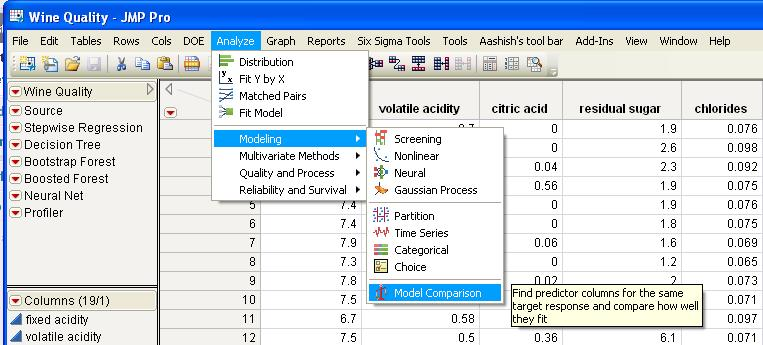
Führen Sie die Modellvergleichsplattform aus und wählen Sie die zu vergleichenden Modelle aus (oder lassen Sie sie von JMP auswählen).
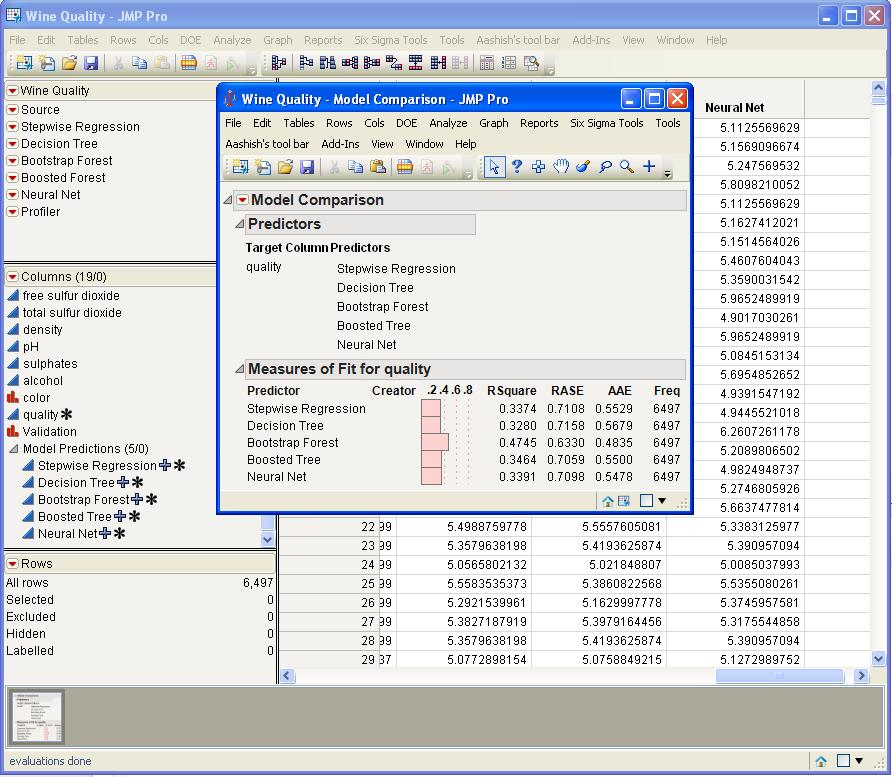
In diesem Beispiel scheint der Bootstrap-Forest das beste Modell generiert zu haben. Wenn mehrere Modelle über ähnliche Statistiken verfügen, können Sie die Modelle auch mithilfe der interaktiven Profiler-Plattform anzeigen. Sie können damit nicht nur ein intuitives Verständnis für die Funktionsweise des Modells entwickeln, sondern auch, wie sich mehrere Eingänge auf die Ausgabe auswirken können. Sie können Laden Sie die Daten herunter, die ich in diesem Blogpost verwendet habe aus dem JMP File Exchange und probieren Sie es selbst aus! (Hinweis: Zum Herunterladen ist ein kostenloses SAS-Profil erforderlich.)
Mrinal schrieb:
Ist eine Kreuzvalidierung in JMP für Regression, neuronales Netzwerk und Gauß'sches Prozessmodell möglich?
Mohammad Mirwais schrieb:
Sehr geehrter Herr oder Modam, ich bin ein neuer Student und möchte ein Modell für den Datensatz erstellen, den ich jetzt habe. Ich bin neu bei JMP. Wie sollte ich einen Weg finden, mir Schritt für Schritt beizubringen, das Modell für die Daten zu erstellen Ich habe?
Ihre Mitarbeit wird viel mehr geschätzt.
Craig Burkhart schrieb:
Arka,
Üblicherweise kommen die Trainings-, Validierungs- und Test-Sets für Techniken wie neuronale Netzwerke und die damit verbundenen Techniken zum Einsatz. Bei der Regression des normalen neuronalen Netzwerks wird der Trainingssatz aktiv verwendet, um das tatsächliche Modell zu erstellen. Der Validierungssatz dient dazu, dem Modellbildungsschritt mitzuteilen, wann das Training abgebrochen werden soll. Typischerweise wird eine Metrik der Modellqualität, beispielsweise ein RMS-Fehler, anhand des Validierungssatzes abgetastet. Sobald der RMS-Fehler als Funktion der Anzahl der Iterationen (oder Epochen in neuronalen Netzen sprechen für den Validierungssatz platt, die typischen Algorithmen für neuronale Netzwerke prüfen, wann der RMS-Fehler auftritt beginnt aufstehen Wenn der Anstieg für eine bestimmte Epochenlänge anhält, beispielsweise 5-10 Epochen, wird die Optimierung angehalten und auf den Punkt zurückgeführt kurz vor dem Aufstieg . Da der Regressionsalgorithmus den Validierungssatz zum Erfassen dieses Endpunkts verwendet hat, kann er technisch nicht als Test des prädiktiven Modellwerts verwendet werden. Hier kommt der Standardtestsatz ins Spiel.
Arka schrieb:
Danke Aashish. Das sieht sehr nützlich aus. Ich werde Sie fragen, warum Sie einen Validierungsdatensatz und dann einen Testsatz benötigen. Sie scheinen dieselbe Funktion zu erfüllen. Ist es eine Frage des Modells durch zwei Filter, um den Vorhersagewert zu sehen?
