有許多方法可以生成模型,如基本線性回歸,決策樹,神經網絡和廣義線性模型。 JMP Pro 對於那些希望從數據中獲取更多信息並構建更準確的預測模型的數據挖掘者來說,它可以成為一個很好的工具。它結合了傳統上複雜的算法 JMP 時尚,即使是新手也可以利用快速構建強大的模型。Bootstrap森林,增強的樹木和多層提升的神經網絡只是JMP Pro中強大工具的一個示例。使JMP Pro成為強大的數據挖掘工具的一件事是能夠一步構建,調整和測試您的模型。
不久前,這個博客上有一篇關於概念的精彩帖子培訓,驗證和測試設置構建您的模型。 要構建一個不僅具有描述性而且具有預測性的模型,驗證模型並隨後對其進行測試至關重要。
如博客條目所述,第一步是首先將數據分為三組:培訓,驗證和測試部分。接下來,您將基於數據的訓練部分構建模型,該模型捕獲了數據(您的系統)的行為,而不僅僅是噪聲。一旦你想出了一個合法的模型,你就可以將該模型應用於驗證集。如果您構建了一個捕獲基礎行為的模型,那麼您應該獲得類似的行為。如果你不這樣做,你必須回去建立另一個模型;這個過程可能會來回幾次。一旦獲得在使用訓練集構建的驗證中提供類似行為的模型,您希望模型可重複,因此您將模型應用於測試集。
JMP Pro是簡化流程的重大突破。引入的第一個增強功能是生成驗證列的一種更簡單的方法。從JMP中,選擇Cols - > New Column,Initialize Data - > Random - > Random Indicator。隨機指標列默認為值0(訓練),1(驗證)和2(測試)。您現在可以選擇要用於每個步驟的數據部分。
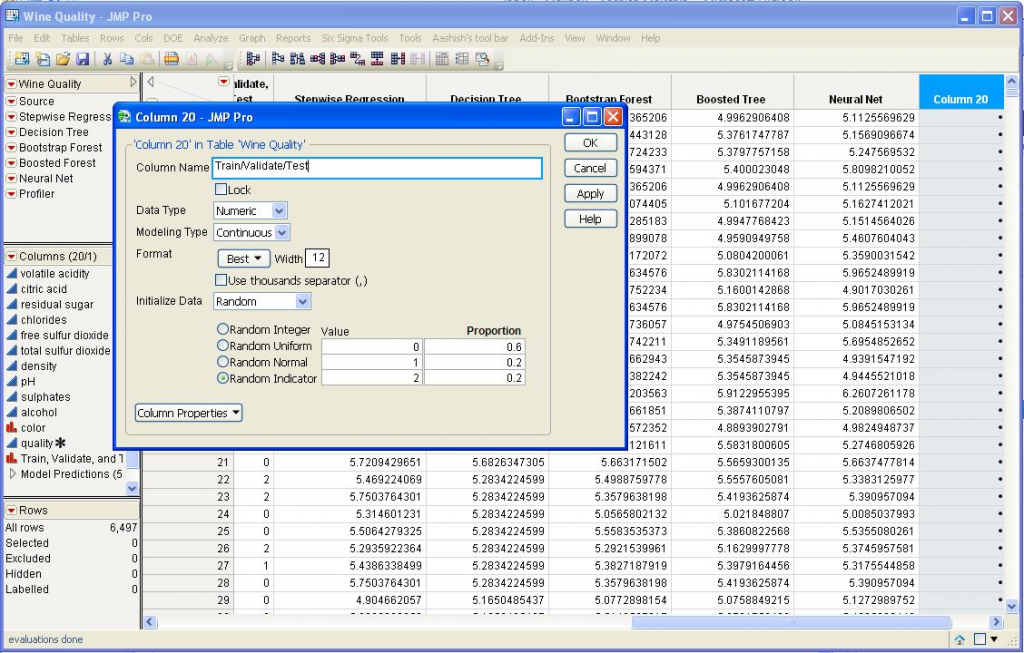
JMP Pro中的大多數建模平台現在都可以選擇輸入驗證列。這使您可以通過一個簡單的步驟完成構建,調整和測試模型的漫長過程,如上所述。在輸入變量時,選擇新製作的列作為驗證選項。

統計學的一個事實是並非所有建模技術都適用於所有數據集。每種技術都有其優點和缺點;每個人都可以教你不同的數據。 JMP Pro的一個優勢是它在同一屋簷下提供多種建模技術。您可以嘗試每種算法,評估其性能,甚至將模型(預測公式)作為新列保存到數據表中。 JMP Pro版本10現在允許您在模型構建後進行比較。
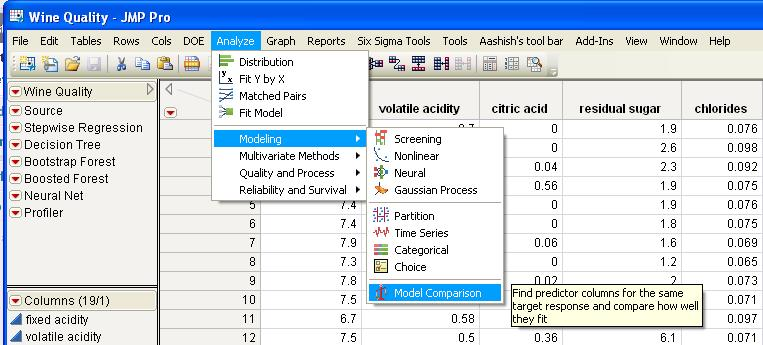
運行模型比較平台並選擇要比較的模型(或讓JMP選擇它們)。
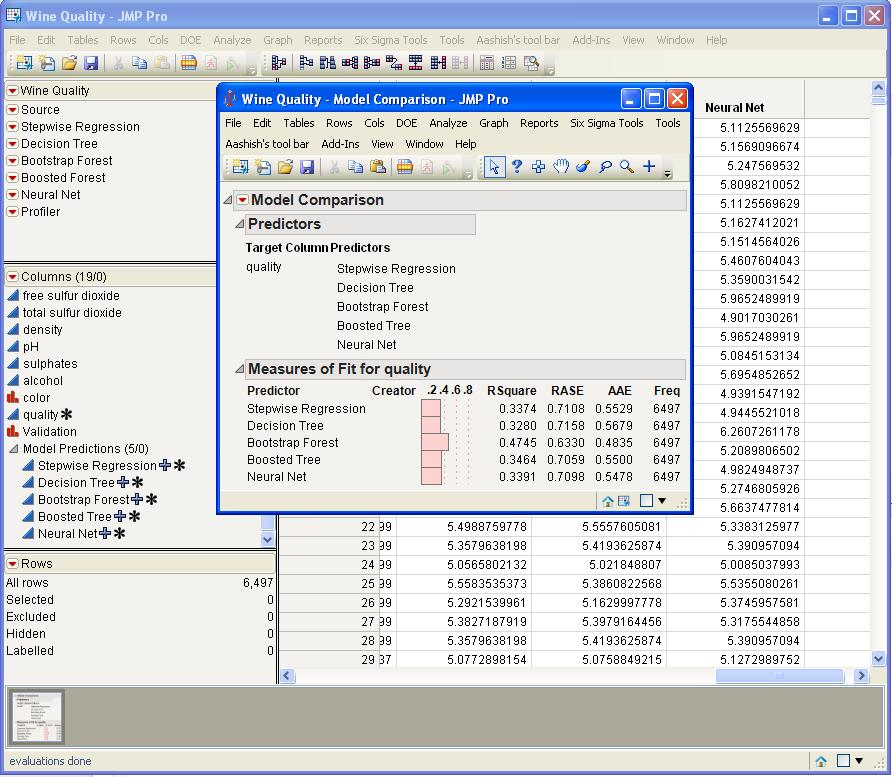
在此示例中,Bootstrap Forest似乎已生成最佳模型。如果多個模型具有相似的統計信息,則查看模型的另一種方法是使用交互式Profiler平台。它不僅可以讓您直觀地了解模型的工作原理,還可以顯示多個輸入的變化如何影響輸出。您可以下載我在這篇博文中使用的數據來自JMP文件交換並親自試用!(注意:下載需要免費的SAS配置文件。)
Mrinal 中寫道:
是否有可能在JMP中進行回歸,神經網絡和高斯過程模型的交叉驗證?
Arati Mejdal 中寫道:
嗨,穆罕默德,
建築模型上的這些視頻可以幫助您: http://www.jmp.com/en_us/events/ondemand/building-better-models.html
祝好運!
穆罕默德米爾韋斯中寫道:
親愛的Sir先生或Modam,我是一名新生,我想為數據集創建一個模型,我現在是JMP的新手,我應該如何找到一些方法來教我逐步製作數據的模型我有?
您的公司將更受歡迎。
克雷格伯克哈特中寫道:
阿爾卡,
訓練,驗證和測試集通常用於神經網絡及其相關技術等技術。在標準神經網絡回歸中,訓練集被主動用於創建實際模型。驗證集的目的是告訴模型構建步驟何時停止訓練。通常,在驗證集上對模型質量的度量(例如rms誤差)進行採樣。一旦rms誤差作為迭代次數的函數(或時代在神經網絡中說)為驗證集平坦化,典型的神經網絡算法在rms誤差時進行採樣開始上升 如果某些規定的紀元長度繼續上升 - 例如,5-10個紀元 - 那麼優化將停止並恢復到某一點就在崛起之前 。由於回歸算法使用驗證集來感知此端點,因此它在技術上不能用作模型預測值的測試。這就是標準測試集發揮作用的地方。
阿爾卡中寫道:
謝謝Aashish。這看起來很有用。我會問為什麼你需要一個驗證數據集然後一個測試集。它們似乎具有相同的功能。是通過2個過濾器傳遞模型以查看其預測值嗎?
