Étant donné que les essais cliniques sont des expériences qui étudient des patients, ils comptent beaucoup sur la recherche du type et du nombre de patients adéquats. Les essais cliniques ne peuvent être menés qu'après que suffisamment d'informations sur les patients ont été collectées et que les groupes de traitement ont été attribués au hasard. Il est donc très important que les chercheurs recrutent suffisamment de personnes dans les délais.
Cependant, au début de l’inscription, on ignore souvent quelle est l’état actuel du recrutement: «Le ferons-nous? Sommes-nous en retard? Sommes-nous en avance sur le calendrier? Où sommes-nous? »Ce type d'incertitude complique la planification et la prise de mesures pour ajuster le taux de recrutement. Compte tenu du nombre actuel de recrues, ne serait-il pas formidable de pouvoir prévoir le temps nécessaire pour recruter les personnes restantes afin de pouvoir réagir sans tarder pour ajouter plus de centres, si nécessaire? Eh bien, nous pouvons avec la modélisation prédictive.
Où en sommes-nous dans le processus de recrutement?
Il existe de nombreux modèles prédictifs développés par des spécialistes pour résoudre ce problème. la plus simple et la plus utilisée est la distribution Poisson-Gamma (Anisimov et Fedorov, 2007). Ce modèle suppose que les patients s'inscrivent en fonction de processus de Poisson indépendants, chacun d'eux étant défini par un paramètre inconnu, non constant, lambda. Lambda est le taux de recrutement (le nombre de patients recrutés pour chaque unité de temps), une mesure qui indique la rapidité du recrutement et appartient à une distribution gamma avec des paramètres alpha et bêta, également inconnus.
Ces deux paramètres, alpha et bêta, pourraient être estimés à l'aide des données de recrutement dont disposent les chercheurs jusqu'à présent. En utilisant les valeurs alpha et bêta estimées et en suivant la distribution gamma, les chercheurs pourraient ensuite simuler différentes valeurs du taux de recrutement (lambda), et donc différentes valeurs des temps restants dérivées des lambdas. La moyenne, 2,5 th Le centile et le 97,5e centile des simulations peuvent être calculés à partir des simulations et servir de prédiction du recrutement restant. Un graphique de ces simulations (Figure 1) donne aux gens une idée directe et visuelle de leur progression dans le processus de recrutement.
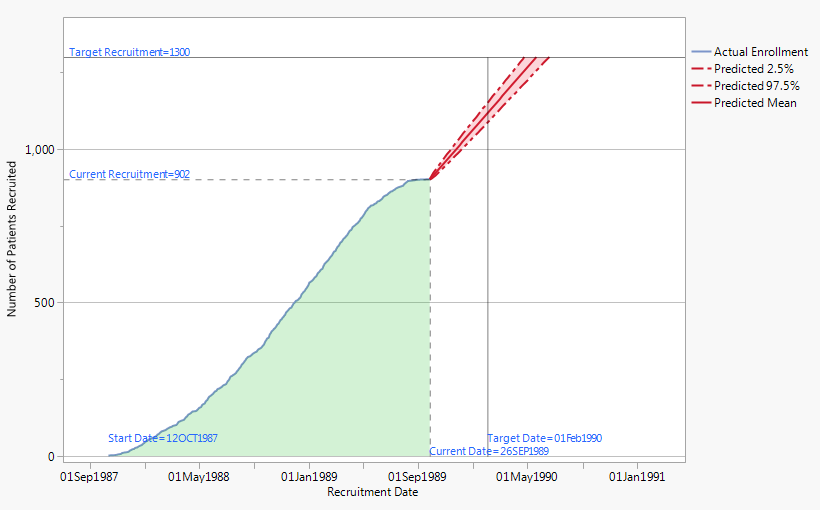
Figure 1
Là, le problème est résolu! Mais attendez....
Comment puis-je savoir si je vais manquer la date limite ou non? Si la moyenne prévue (marquée par la ligne rouge) dépasse la date cible, cela signifie-t-il que je ne pourrai pas recruter suffisamment de patients? Ou devrais-je regarder les centiles? Eh bien, donnez-moi un seuil de probabilité avec lequel vous voulez que votre recrutement respecte l'échéance, et je le comparerai à la probabilité que les temps restants simulés respectent l'échéance. Si la probabilité calculée est supérieure ou égale au seuil, le taux de recrutement actuel est acceptable pour vous. Toutefois, si le taux de recrutement actuel ne permet pas d'atteindre votre seuil, des centres supplémentaires sont nécessaires pour atteindre l'objectif de recrutement avant la date limite.
Ajout de nouveaux centres
OK, comment puis-je savoir combien de nouveaux centres ajouter? Excellente question! Le modèle vous le dira. Si le modèle juge nécessaire d'ajouter des centres, l'ajustement adaptatif est lancé et il utilise la même méthode de simulation pour prévoir le nouveau temps restant en commençant par l'ajout d'un centre. Le nombre initial de nouveaux centres est un par défaut, mais vous pouvez le changer. Le nouveau temps restant inclut le temps restant prévu avec l'ajout des nouveaux centres et le temps passé dans les nouveaux centres pour leur mise en ligne. Ensuite, le modèle a besoin d'une autre probabilité de votre part. Vous lui avez donné la probabilité minimale de respecter l’échéance avec les centres actuels pour que le modèle sache quand commencer à ajouter plus de centres; L'étape suivante consiste à fournir une probabilité minimale de respecter la date limite avec les nouveaux centres afin que le modèle sache quand arrêter d'ajouter d'autres centres.
Le modèle calcule la probabilité que de nouvelles simulations respectent l'échéance avec l'ajout de nouveaux centres et la compare à la deuxième probabilité minimale que vous avez spécifiée. Il continuera d'ajouter un nouveau centre si la première probabilité est inférieure à la dernière, jusqu'à ce qu'elles soient égales ou que la première soit supérieure à la dernière. De cette manière, le modèle a trouvé le plus petit nombre de centres supplémentaires répondant à vos normes minimales afin que vous atteigniez votre objectif d'inscription au même moment. Le tableau et les graphiques ci-dessous illustrent l'ensemble du processus de réglage adaptatif. Notez que les deux probabilités que vous devez spécifier peuvent être identiques (lorsque vous avez les mêmes exigences concernant la probabilité que les simulations atteignent la date cible avec et sans l'ajout de nouveaux centres).

Figure 2

figure 3

Tableau 1
Mission accomplie!
Ce modèle prédictif de recrutement de patients dans des centres multiples est puissant et ajustable. Il vous donne une idée précise de votre recrutement et de son évolution future. De plus, vous pouvez l'adapter aux normes de votre choix en modifiant les options. Vous n'avez besoin que de données sur le recrutement d'un participant dans un essai clinique en cours, ce qui vous permet d'évaluer et d'ajuster les stratégies de recrutement pour que vos essais soient dans les temps.
J'ai créé les graphiques et le tableau avec JMP Clinical (Données démographiques et visites> Recrutement de patients). JMP Clinical propose également un ensemble d'autres outils prédictifs pour vos analyses d'essais cliniques.
Xiaotong Jiang a écrit:
Salut Emil. Merci beaucoup de votre intérêt! En bref, JMPC utilise l’ensemble de la zone verte pour prédire le recrutement futur. Même s'il s'est légèrement stabilisé à la fin du recrutement actuel, le taux de recrutement global reste relativement élevé et les valeurs prédites augmenteront avec ce taux. Si vous utilisez uniquement les données les plus récentes (par exemple les six derniers mois), vous constaterez une pente plus plate car la partie aplatie devient plus influente. S'il vous plaît n'hésitez pas à m'envoyer un email si vous avez plus de questions!
Raj Bandaru a écrit:
très sympa, il serait intéressant de voir comment cela fonctionnait par rapport à de vraies données de recrutement et comment on pourrait inclure des paramètres supplémentaires.
Emil Friedman a écrit:
La figure 1 suggère que le recrutement réel s'est stabilisé. Pourquoi l'extrapolation dit-elle que la pente augmentera?
