De vez en cuando, me encuentro con un gráfico de barras en una escala de registro, y siempre me parece mal. A primera vista, comparo las longitudes de las barras y comienzo a hacer comparaciones. Pero finalmente, me doy cuenta de la escala de registro en el eje y trato de convencer a mi cerebro para que olvide todo lo que acaba de ver y compare las partes superiores de las barras con la escala del eje. En ese sentido, las barras en una escala de registro son un caso especial de barras sin una línea de base significativa .
Este es un ejemplo reciente que vi, que compara velocidades para leer archivos CSV (archivos de texto de valores separados por comas).
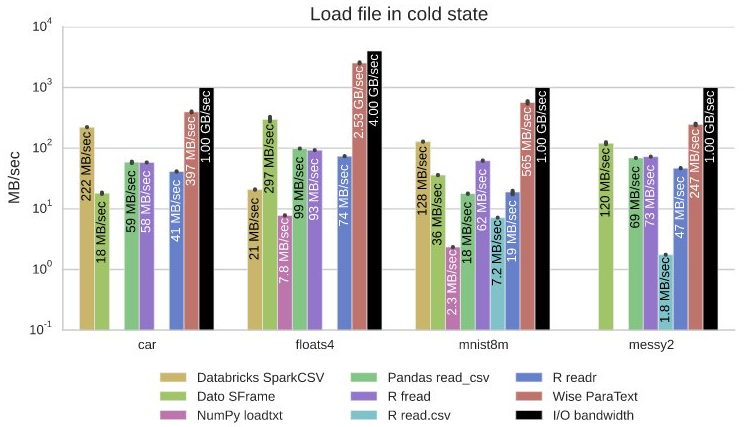
La fuente de la comparación es un documento del proveedor de la herramienta de color coral, ParaTexto de wise.io , mostrando lo rápido que es. A la compañía no se le puede acusar de engaño en la visualización ya que el uso de una escala de registro solo hace que las velocidades de los competidores se vean más cercanas a sus propias velocidades. Es aproximadamente 10 veces más rápido que R readr, pero parece solo 2 veces más rápido. La única ventaja que ParaText obtiene de la escala de registro es que su velocidad se ve muy cerca de la barra negra de ancho de banda de E / S (el límite superior) cuando, de hecho, las velocidades son aproximadamente la mitad del ancho de banda de E / S.
Como cualquier otro esfuerzo no trivial, Visualización de datos A menudo implica restricciones conflictivas que deben ser equilibradas. Sí, el uso de barras en una escala de registro ciertamente interfiere con la comprensión del gráfico, pero es posible que todas las alternativas sean peores. Es por eso que siempre busco alternativas cuando hago evaluaciones de visualizaciones de datos.
Las escalas de registro son más útiles cuando los datos subyacentes están muy sesgados o varían en muchos órdenes de magnitud. Estos datos de velocidad son sesgados y variados, pero no tan terriblemente. La variación máxima es de alrededor de 200: 1, que es solamente Dos órdenes de magnitud. Inmediatamente, podemos probar dos variaciones en este cuadro:
Mantener las barras y cambiar la escala a lineal.Mantener la escala de registro y cambiar las barras.Aquí hay una conversión directa a una escala lineal. Utilizando JMP , He escalado todos los valores para que sean relativos al ancho de banda de E / S, por lo que las barras negras no se muestran ya que todas estarían al 100%.

No he etiquetado las barras con valores. No creo que todas las barras necesiten etiquetado con valores exactos (prefiero tener una tabla de apoyo para eso). Pero si estuviera compartiendo esto en un informe, intentaría etiquetar la barra más alta o dos en cada categoría para alguna conexión a tierra. Encuentro todas las etiquetas giradas en el original para restar valor a la representación visual de los datos y me cuesta mucho leerlos.
La escala lineal no es mala, y ya me gusta más que la original porque retrata las diferencias de velocidad entre los productos directamente. Una debilidad de ambos gráficos es que las etiquetas de los productos están separadas de sus barras. Al rotar las barras, al menos, se colocan las barras y las etiquetas de leyenda en el mismo arreglo.

Una jerarquía de agrupación diferente nos permite etiquetar las barras de productos directamente.

Comparando a través de Las pruebas ahora son menos directas, pero creo que es una comparación menos importante.
Ahora volvamos al principio e intentemos mantener la escala de registro y cambiar los elementos de datos. Aquí hay una vista que usa puntos y líneas en lugar de barras.

Los puntos en sí son suficientes para transportar la información de posición, pero las líneas agregan información de conexión, lo que ayuda a simplificar el etiquetado. En general, los segmentos de línea llevan tres connotaciones:
Interpolación (continua)Conexión (categórica)Reconocimiento de patrones (continuo o categórico)La interpolación no tiene mucho sentido aquí ya que nuestro eje X es categórico, por lo que es una detracción aquí. Pero la conexión es muy valiosa, y el reconocimiento de patrones también es informativo. Por ejemplo, notamos que un par de productos tienen el mismo patrón arriba-abajo-arriba.
Con las líneas etiquetadas en su lugar, el color no es tan necesario. Si bien el color ayuda a distinguir las líneas que se intersecan y las líneas de datos se destacan de las líneas de la cuadrícula, existe una separación suficiente como para tratar de usar el color para el grupo de tecnología (R, Python o especial) en lugar de etiquetas individuales.

Eso hace que el gráfico esté menos ocupado pero mantiene las ventajas del color.
El gráfico se ve bien, pero funciona? Todavía tenemos una escala de registro, que aún requiere más reflexión. Pero al menos ahora los elementos de datos no están en conflicto con la escala, y tenemos más espacio para mostrar líneas de cuadrícula que refuerzan la no linealidad. La escala de registro facilita la comprensión de las diferencias entre los valores en todo el rango. En particular, podemos ver cómo los valores bajos difieren entre sí mejor que nosotros en una escala lineal.
Es interesante para mí que los datos en sí hacen una gran diferencia en la utilidad de cada opción del gráfico. La escala lineal está en su límite de utilidad con diferencias alrededor de 10x. Si las diferencias fueran más como 1000x, una escala lineal sería inútil. Y si los valores fueran demasiado similares en todos los productos, los puntos se oscurecerían entre sí y serían menos útiles.
Habiendo visto algunas posibilidades, ¿cuál es la más efectiva para entender el rendimiento? ¿O algo completamente mejor sería mejor?
Craige escribió:
El gráfico azul es el mejor para entregar la información, pero seguro que se perdió entre todos los colores bonitos en los otros gráficos.
