Ogni tanto mi imbatto in un grafico a barre su una scala di registro e mi sembra sempre sbagliato. A prima vista, confronto le lunghezze delle barre e inizio a fare confronti. Ma alla fine, noto la scala del registro sull'asse e cerco di convincere il mio cervello a dimenticare tutto ciò che ha appena visto e a confrontare le cime delle barre con la scala dell'asse. In questo senso, le barre su una scala di registro sono un caso speciale di barre senza una linea di base significativa .
Ecco un esempio recente che ho visto, confrontando le velocità per la lettura di file CSV (file di testo con valori separati da virgole).
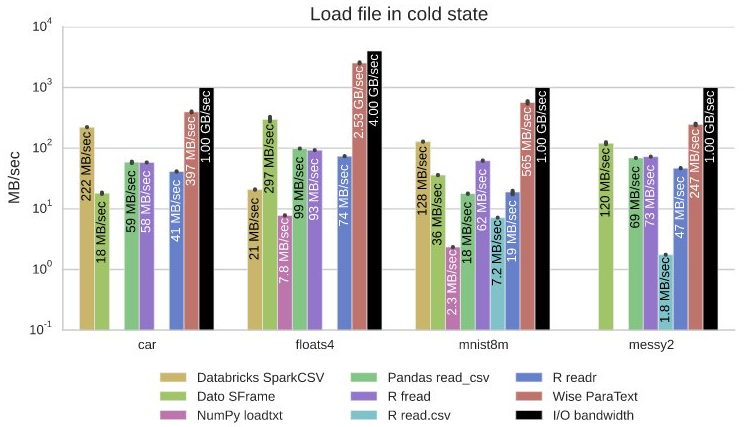
La fonte del confronto è un white paper del venditore per lo strumento color corallo, ParaText da wise.io , mostrando quanto è veloce. L'azienda difficilmente può essere accusata di inganno nella visualizzazione poiché l'uso di una scala di registro rende le velocità della concorrenza solo più vicine alle proprie velocità. È circa 10 volte più veloce di R readr ma sembra solo 2 volte più veloce. L'unico vantaggio che ParaText ricava dalla scala di log è che la sua velocità sembra molto vicina alla barra nera di larghezza di banda I / O (il limite superiore) quando, in realtà, le velocità sono circa la metà della larghezza di banda I / O.
Come ogni altra impresa non banale, visualizzazione dati spesso comporta vincoli conflittuali che devono essere bilanciati. Sì, usare le barre su una scala di registro interferisce certamente con l'acquisizione di informazioni dal grafico, ma è possibile che tutte le alternative siano peggiori. Ecco perché guardo sempre alle alternative quando faccio valutazioni delle visualizzazioni dei dati.
Le scale log sono molto utili quando i dati sottostanti sono molto distorti o variano di molti ordini di grandezza. Questi dati di velocità sono sia distorti che vari, ma non così terribilmente. La variazione massima è di circa 200: 1, che è solo due ordini di grandezza. Immediatamente, possiamo provare due varianti su questo grafico:
Mantieni le barre e modifica la scala in lineare.Mantieni la scala del registro e modifica le barre.Ecco una semplice conversione in scala lineare. utilizzando JMP , Ho ridimensionato tutti i valori relativi alla larghezza di banda I / O, quindi le barre nere non sono mostrate poiché sarebbero tutte al 100%.

Non ho etichettato le barre con valori. Non penso che tutte le barre abbiano bisogno di etichette con valori esatti (preferirei avere una tabella di supporto per questo). Ma se condividessi questo in un rapporto, proverei ad etichettare la barra più alta o due in ogni categoria per alcune basi. Trovo tutte le etichette ruotate nell'originale per sminuire la rappresentazione visiva dei dati e fare troppa fatica per leggere.
La scala lineare non è male, e mi piace già meglio dell'originale in quanto ritrae direttamente le differenze di velocità tra i prodotti. Un punto debole di entrambi i grafici è che le etichette del prodotto sono separate dalle rispettive barre. Ruotando le barre almeno le barre e le etichette della legenda vengono inserite nella stessa disposizione.

Una diversa gerarchia di raggruppamento ci consente di etichettare direttamente le barre del prodotto.

confrontando attraverso i test ora sono meno diretti, ma penso che sia un confronto meno importante.
Ora torniamo all'inizio e proviamo a mantenere la scala del registro e a modificare gli elementi dei dati. Ecco una vista che utilizza punti e linee anziché barre.

I punti stessi sono sufficienti per trasportare le informazioni sulla posizione, ma le linee aggiungono le informazioni di connessione, il che aiuta a semplificare l'etichettatura. In generale, i segmenti di linea hanno tre connotazioni:
Interpolazione (continua)Connessione (categoriale)Riconoscimento di pattern (continuo o categoriale)L'interpolazione non ha molto senso qui dato che il nostro asse x è categorico, quindi qui è una detrazione. Ma la connessione è molto preziosa e anche il riconoscimento dei pattern è informativo. Ad esempio, notiamo che un paio di prodotti hanno lo stesso schema up-down-up.
Con le linee etichettate, il colore non è necessario. Mentre il colore aiuta a distinguere le linee intersecanti e aiuta le linee dati a distinguersi dalle linee della griglia, c'è una separazione sufficiente che possiamo provare ad usare il colore per il gruppo tecnologico (R, Python o specialità) piuttosto che le singole etichette.

Ciò rende il grafico meno occupato ma mantiene i vantaggi del colore.
Il grafico sembra carino, ma funziona? Abbiamo ancora una scala di registro, che richiede ancora più riflessioni. Ma almeno ora gli elementi dei dati non sono in conflitto con la scala, e abbiamo più spazio per mostrare le linee della griglia che rafforzano la non-linearità. La scala di registro semplifica la comprensione delle differenze tra i valori nell'intero intervallo. In particolare, possiamo vedere come i valori bassi differiscono l'uno dall'altro meglio di quanto possiamo su una scala lineare.
È interessante per me che i dati stessi facciano una grande differenza nell'utilità di ciascuna opzione del grafico. La scala lineare è al limite dell'utilità con differenze attorno a 10x. Se le differenze fossero più simili a 1000x, una scala lineare sarebbe inutile. E se i valori fossero troppo simili tra i prodotti, i punti si sarebbero oscurati a vicenda e meno utili.
Dopo aver visto alcune possibilità, che è più efficace per capire le prestazioni? O qualcos'altro sarebbe del tutto migliore?
Craige ha scritto:
il grafico tutto blu è il migliore per fornire le informazioni, ma sicuramente si è perso tra tutti i bei colori negli altri grafici.
