Hin und wieder stoße ich auf einer Balkenskala auf ein Balkendiagramm, und es fühlt sich immer falsch an. Auf den ersten Blick vergleiche ich die Stablängen und beginne mit Vergleichen. Irgendwann stelle ich jedoch die Balkenskala auf der Achse fest und versuche mein Gehirn zu überzeugen, alles, was es gerade gesehen hat, zu vergessen, und die oberen Enden der Balken mit der Achsenskala zu vergleichen. In diesem Sinne sind Balken auf einer Protokollskala ein Sonderfall von Bars ohne sinnvolle Basislinie .
Ich habe ein aktuelles Beispiel gesehen, in dem ich die Geschwindigkeit beim Lesen von CSV-Dateien (Textdateien mit durch Kommas getrennten Werten) vergleicht.
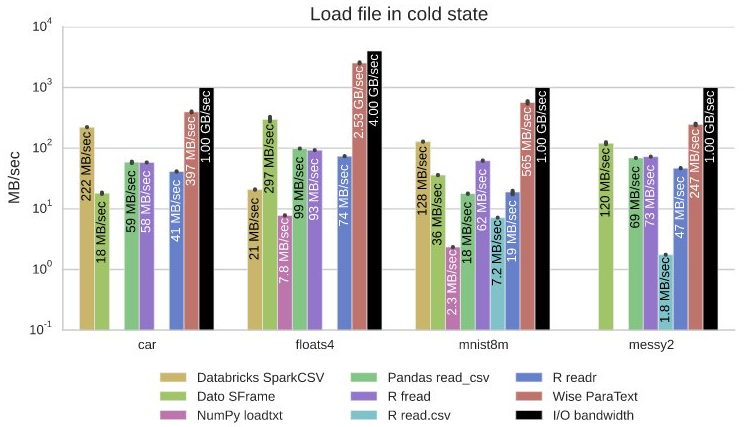
Die Quelle des Vergleichs ist ein Whitepaper des Anbieters für das korallenfarbene Werkzeug. ParaText von wise.io zeigt, wie schnell es ist. Dem Unternehmen kann der Täuschung in der Visualisierung kaum vorgeworfen werden, da die Geschwindigkeit der Wettbewerber nur durch die Verwendung einer Protokollwaage näher an die eigenen Geschwindigkeiten erinnert. Es ist etwa 10x schneller als R readr, sieht aber nur 2x schneller aus. Der einzige Vorteil, den ParaText aus der Protokollskala zieht, besteht darin, dass seine Geschwindigkeit sehr nahe an der schwarzen E / A-Bandbreitenleiste (der oberen Grenze) liegt, wenn die Geschwindigkeiten tatsächlich etwa die Hälfte der E / A-Bandbreite betragen.
Wie jedes andere nicht unbedeutende Unterfangen, Datenvisualisierung oft mit widersprüchlichen Einschränkungen, die ausgeglichen werden müssen. Ja, die Verwendung von Balken in einer Protokollskala wirkt sich sicherlich auf die Gewinnung von Erkenntnissen aus der Grafik aus. Möglicherweise sind jedoch alle Alternativen schlechter. Deshalb schaue ich bei der Bewertung von Datenvisualisierungen immer nach Alternativen.
Protokollskalen sind am nützlichsten, wenn die zugrunde liegenden Daten sehr schief sind oder um viele Größenordnungen variieren. Diese Geschwindigkeitsdaten sind sowohl schief als auch variabel, aber nicht so furchtbar. Die maximale Abweichung beträgt ungefähr 200: 1, was ist nur zwei Größenordnungen. Sofort können wir zwei Variationen dieser Tabelle ausprobieren:
Behalten Sie die Balken bei und ändern Sie die Skala in linear.Behalten Sie die Protokollskala bei und ändern Sie die Balken.Hier ist eine einfache Konvertierung in eine lineare Skala. Verwenden JMP Ich habe alle Werte so skaliert, dass sie relativ zur E / A-Bandbreite sind. Daher werden die schwarzen Balken nicht angezeigt, da sie alle bei 100% liegen würden.

Ich habe die Balken nicht mit Werten beschriftet. Ich denke nicht, dass alle Balken mit exakten Werten beschriftet werden müssen (dafür hätte ich lieber einen unterstützenden Tisch). Aber wenn ich dies in einem Bericht mitteilen würde, würde ich versuchen, die ein oder zwei höchsten Balken in jeder Kategorie für etwas Grundlegendes zu kennzeichnen. Ich finde alle gedrehten Etiketten im Original, um die visuelle Darstellung der Daten zu beeinträchtigen und das Lesen zu viel Mühe zu machen.
Die lineare Skala ist nicht schlecht, und ich mag sie schon besser als das Original, da sie die Geschwindigkeitsunterschiede zwischen den Produkten direkt darstellt. Ein Schwachpunkt beider Diagramme ist, dass die Produktetiketten von ihren Balken getrennt sind. Durch Drehen der Balken werden zumindest die Balken und Legendenbeschriftungen in dieselbe Anordnung gebracht.

Durch eine andere Gruppierungshierarchie können wir die Produktleisten direkt beschriften.

Vergleich über Tests ist jetzt weniger direkt, aber ich denke, das ist ein weniger wichtiger Vergleich.
Gehen wir jetzt zum Anfang zurück und versuchen Sie, die Protokollskala beizubehalten und die Datenelemente zu ändern. Hier ist eine Ansicht, die Punkte und Linien anstelle von Balken verwendet.

Die Punkte selbst reichen aus, um die Positionsinformationen zu tragen, aber die Linien fügen Verbindungsinformationen hinzu, wodurch die Beschriftung vereinfacht wird. Liniensegmente haben im Allgemeinen drei Konnotationen:
Interpolation (kontinuierlich)Verbindung (kategorisch)Mustererkennung (kontinuierlich oder kategorial)Interpolation macht hier nicht viel Sinn, da unsere x-Achse kategorisch ist, was hier eine Ablenkung ist. Die Verbindung ist jedoch sehr wertvoll und auch die Mustererkennung ist informativ. Zum Beispiel stellen wir fest, dass einige Produkte das gleiche Auf / Ab-Muster aufweisen.
Wenn die Linien markiert sind, ist die Farbe nicht so notwendig. Die Farbe hilft zwar dabei, sich überschneidende Linien zu unterscheiden und die Datenlinien von den Rasterlinien abzugrenzen, aber es gibt genug Trennungen, um Farbe für Technologiegruppen (R, Python oder Spezialität) anstelle von einzelnen Beschriftungen verwenden zu können.

Dadurch wird das Diagramm weniger ausgelastet, die Farbvorteile bleiben jedoch erhalten.
Das Diagramm sieht gut aus, aber funktioniert es? Wir haben immer noch eine logarithmische Skala, die noch mehr Nachdenken erfordert. Aber zumindest stehen die Datenelemente jetzt nicht in einem solchen Konflikt mit der Skalierung, und wir haben mehr Platz, um Gitterlinien zu zeigen, die die Nichtlinearität verstärken. Die Protokollskala erleichtert das Verständnis der Unterschiede zwischen den Werten im gesamten Bereich. Insbesondere können wir sehen, wie sich die niedrigen Werte besser unterscheiden als auf einer linearen Skala.
Es ist für mich interessant, dass die Daten selbst einen so großen Unterschied in der Nützlichkeit jeder Diagrammoption bewirken. Die lineare Skala befindet sich an der Grenze ihrer Nützlichkeit mit Unterschieden um das 10-fache. Wenn die Unterschiede mehr als 1000x wären, wäre eine lineare Skala unbrauchbar. Wenn die Werte zwischen den Produkten zu ähnlich wären, würden sich die Punkte gegenseitig verschleiern und wären weniger nützlich.
Nachdem Sie einige Möglichkeiten gesehen haben, was ist am effektivsten, um die Leistung zu verstehen? Oder wäre etwas ganz anderes besser?
