De temps en temps, je croise un graphique à barres sur une échelle logarithmique, et il se sent toujours mal. À première vue, je compare les longueurs des barres et commence à faire des comparaisons. Mais finalement, je remarque l’échelle logarithmique sur l’axe et tente de convaincre mon cerveau d’oublier tout ce qu’il vient de voir et de comparer le sommet des barres à l’échelle de l’axe. En ce sens, les barres sur une échelle logarithmique constituent un cas particulier de barres sans ligne de base significative .
Voici un exemple récent que j'ai vu, comparant les vitesses de lecture de fichiers CSV (fichiers texte de valeurs séparées par des virgules).
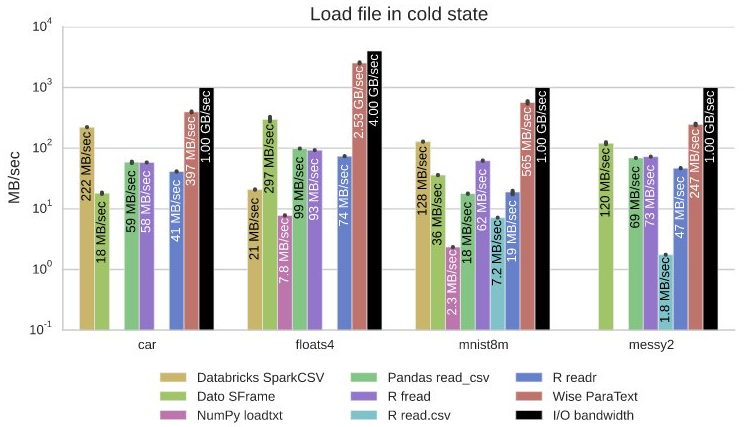
La source de la comparaison est un livre blanc du fournisseur pour l’outil de couleur corail, ParaText de wise.io , montrant à quelle vitesse il est. La société peut difficilement être accusée de tromperie dans la visualisation puisque l’utilisation d’une échelle logarithmique ne fait que rapprocher les vitesses du concurrent de ses propres vitesses. Il est environ 10 fois plus rapide que R readr mais ne semble que 2x plus vite. Le seul avantage que ParaText tire de l'échelle du journal est que sa vitesse est très proche de la barre de bande passante d'E / S noire (limite supérieure) alors qu'en réalité, elle correspond à environ la moitié de la bande passante d'E / S.
Comme toute autre entreprise non triviale, visualisation de données implique souvent des contraintes conflictuelles qui doivent être équilibrées. Oui, utiliser des barres sur une échelle de log entrave certes la compréhension du graphique, mais il est possible que toutes les alternatives soient pires. C'est pourquoi je cherche toujours des alternatives lors de l'évaluation des visualisations de données.
Les échelles de journalisation sont particulièrement utiles lorsque les données sous-jacentes sont très asymétriques ou varient selon plusieurs ordres de grandeur. Ces données de vitesse sont à la fois biaisées et variées, mais pas tellement. La variation maximale est d'environ 200: 1, ce qui correspond à seulement deux ordres de grandeur. Immédiatement, nous pouvons essayer deux variantes de ce graphique:
Gardez les barres et changez l'échelle en linéaire.Gardez l'échelle du journal et changez les barres.Voici une conversion simple en une échelle linéaire. En utilisant JMP , Toutes les valeurs étant relatives à la largeur de bande d’entrée / sortie, les barres noires ne sont pas affichées car elles seraient toutes à 100%.

Je n'ai pas étiqueté les barres avec des valeurs. Je ne pense pas que toutes les barres doivent être étiquetées avec les valeurs exactes (je préférerais un tableau de support pour cela). Mais si je partageais cela dans un rapport, j'essaierais de nommer la barre ou les deux barres les plus hautes de chaque catégorie. Je trouve que toutes les étiquettes pivotées dans l'original détournent de la représentation visuelle des données et prennent trop de temps à lire.
L'échelle linéaire n'est pas mauvaise et je l'aime déjà mieux que l'originale en ce qu'elle représente directement les différences de vitesse entre les produits. Une des faiblesses des deux graphiques est que les étiquettes des produits sont séparées de leurs barres. Faire pivoter les barres au moins place les barres et les étiquettes de légende dans le même arrangement.

Une hiérarchie de regroupement différente nous permet d’étiqueter directement les barres de produits.

Comparant à travers tests est maintenant moins direct, mais je pense que la comparaison est moins importante.
Revenons maintenant au début et essayons de conserver l'échelle du journal et de modifier les éléments de données. Voici une vue utilisant des points et des lignes au lieu de barres.

Les points eux-mêmes sont suffisants pour porter les informations de position, mais les lignes ajoutent des informations de connexion, ce qui simplifie l'étiquetage. En général, les segments de ligne ont trois connotations:
Interpolation (continue)Connexion (catégorique)Reconnaissance de formes (continue ou catégorique)L'interpolation n'a pas beaucoup de sens ici puisque notre axe des x est catégorique, donc c'est une dépréciation ici. Mais la connexion est très utile et la reconnaissance des formes est également informative. Par exemple, nous remarquons que quelques produits ont le même modèle de haut en bas.
Avec les lignes étiquetées en place, la couleur n'est pas aussi nécessaire. Bien que la couleur aide à distinguer les lignes qui se croisent et à faire ressortir les lignes de données des lignes de grille, la séparation est suffisante pour que nous puissions utiliser la couleur pour le groupe de technologies (R, Python ou spécial) plutôt que pour les étiquettes individuelles.

Cela rend le graphique moins occupé mais conserve les avantages de la couleur.
Le graphique a l'air bien, mais ça marche? Nous avons toujours une échelle logarithmique qui nécessite encore plus de réflexion. Mais au moins maintenant, les éléments de données ne sont pas en conflit avec l’échelle et nous avons plus de place pour montrer des lignes de grille qui renforcent la non-linéarité. L'échelle du journal facilite la compréhension des différences entre les valeurs sur l'ensemble de la plage. En particulier, nous pouvons voir comment les valeurs basses diffèrent les unes des autres mieux que sur une échelle linéaire.
Il est intéressant pour moi que les données elles-mêmes fassent une telle différence dans l'utilité de chaque option de graphique. L'échelle linéaire est à la limite de son utilité avec des différences d'environ 10x. Si les différences ressemblaient davantage à 1000x, une échelle linéaire serait inutile. Et si les valeurs étaient trop similaires d’un produit à l’autre, les points s’obscurciraient et seraient moins utiles.
Après avoir vu quelques possibilités, quelle est la plus efficace pour comprendre la performance? Ou est-ce que quelque chose d'autre serait mieux?
Craige a écrit:
le graphique entièrement bleu est le meilleur pour fournir les informations, mais il s’est certainement perdu parmi toutes les jolies couleurs des autres graphiques.
