私たちのほとんどにとって、私たちが分析するデータは JMP リレーショナルデータベース、Excel、CSVファイル、あるいはSASなど、どこか別の場所から始めます。そのようなデータをJMPにシームレスに移動して分析のために準備する必要があるため、私たちは次のことを紹介しました。クエリビルダー JMP 12の機能 クエリビルダー外部データソースから複数のテーブルを選択してそれらを結合するのに役立ちます。その後、対話形式でフィルタ処理(必要に応じてプロンプトフィルタを作成)、インポートしたデータの列名、フォーマット、およびモデリングタイプのサンプリングと設定を行うことができます。
ユーザーから寄せられたフィードバッククエリビルダーあなたはそれが有用だと思っていることを示唆しています。また、修正と機能強化についての提案もあります。クエリビルダーデータアクセスのその他の側面 JMP 13では、このような修正と機能強化を盛り込んでいます。13のそのような最も重要な修正と機能強化は以下に詳述されています。
フィルタリング
最初の4つの機能強化はすべて、データのフィルタリングに関するものです。
 注意してください、私のデータは巨大かもしれません - カテゴリカル列のフィルタを作成すると、クエリービルダーはリストに表示する値を取得します。大きなテーブルでは、これには長い時間がかかります。JMP 12では、値の取得は無条件であり、それを取り消すことはできませんでした。JMP 13では、長時間待機しないようにいくつかの変更を加えました。
- キャンセル可能な値の取得 - JMP 13はプログレスバーをキャンセルカテゴリカル列の値を取得するときのボタン。これは、JMPがWindows上で動作しているときにテストしたすべてのODBCドライバでサポートされています。SASに接続しているとき、またはMacintoshで利用可能なほとんどのODBCドライバではサポートされていません。
 試みるには大きすぎる - テーブルに1,000,000を超える行がある場合、JMPは一意の列値を取得することすら試みません。100万の値は設定によって変更できます。
- より簡単なリスト - JMP 12では、チェックボックス一覧値の一覧から選択するために使用できる唯一の種類のフィルタです。JMP 13では、プレーンを追加しましたリストボックスフィルタータイプ。のリストボックスフィルタは以下よりもリソース集約的です。チェックボックス一覧フィルタ。これはより大きなリストに適しています。カテゴリカル列のデフォルトのフィルタタイプは、リストボックス JMP 13で。
 新しいフィルタータイプ - 新しい、シンプルなものに加えてリストボックスフィルタタイプ。JMP13のカテゴリカル列に、さらに2つのフィルタタイプが追加されました。
- 含む filter - テキストを入力すると、JMPはそのテキストを含むすべての行に一致します。また、一致する行に一致するように依頼することもできます。ではないテキストを含みます。
 マニュアル一覧 filter - 値の検索が不要になるように、選択リストを自分で作成できます。
 リストフィルタは反転可能になりました - すべてのリスト型フィルタ( リストボックス、マニュアルリスト、チェックボックスリストそして列値の一致 )今リストにないチェックボックス これにより、いくつかの項目を選択して、一致するすべての行を取得できます。ではない選択した値と一致させてください。たとえば、このフィルタは、定格以外の映画をすべて返します。 “ G” :

 リストフィルタを条件付きにすることができる - これはちょっとしたことです。 リスト型フィルタの赤い三角メニューを使用して、フィルタを次のように設定できます。条件付き 条件付きフィルターは、リスト内で先行する他のフィルターと一致する値のみを表示します。以下は映画を使った例です。評価と映画ジャンル 。この例では、私はジャンル条件付きフィルタ 選択したとき G のリストに評価 、ジャンル少なくとも1つのG定格映画を含むジャンルのみをリスト表示するようにフィルタを変更します。


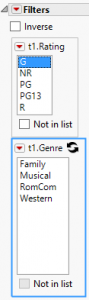
 この記号は、フィルタが条件付きであることを示します。列のフィルタのみ同じテーブルから条件付きフィルターに表示される値に影響します。
JMPクエリービルダー
 クエリービルダーを使用した後、何人かのユーザーが私たちに尋ねるでしょう。JMP 13では、答えは驚くべきものです。 "はい!" あるいは、ODBC Query Builder、Text Import、またはExcel Import Wizardを使用して複数のテーブルをインポートすることもできます。結果を結合するためにQuery Builderを使用できると便利です。JMP 13では、それが可能です。
JMPデータテーブルでQuery Builderを使用するには、まずテーブルを開き、次に[Select]を選択します。 JMPクエリービルダーからテーブルメニュー。

たとえば、JMPには2つのサンプルデータテーブルがあります。 SATByYear.jmp そして CrimeData.jmp、両方とも状態そして年列 別のサンプル表 US Demographics.jmp 、があります状態カラム。これら3つのテーブルをJMP Query Builderで簡単に結合できます。
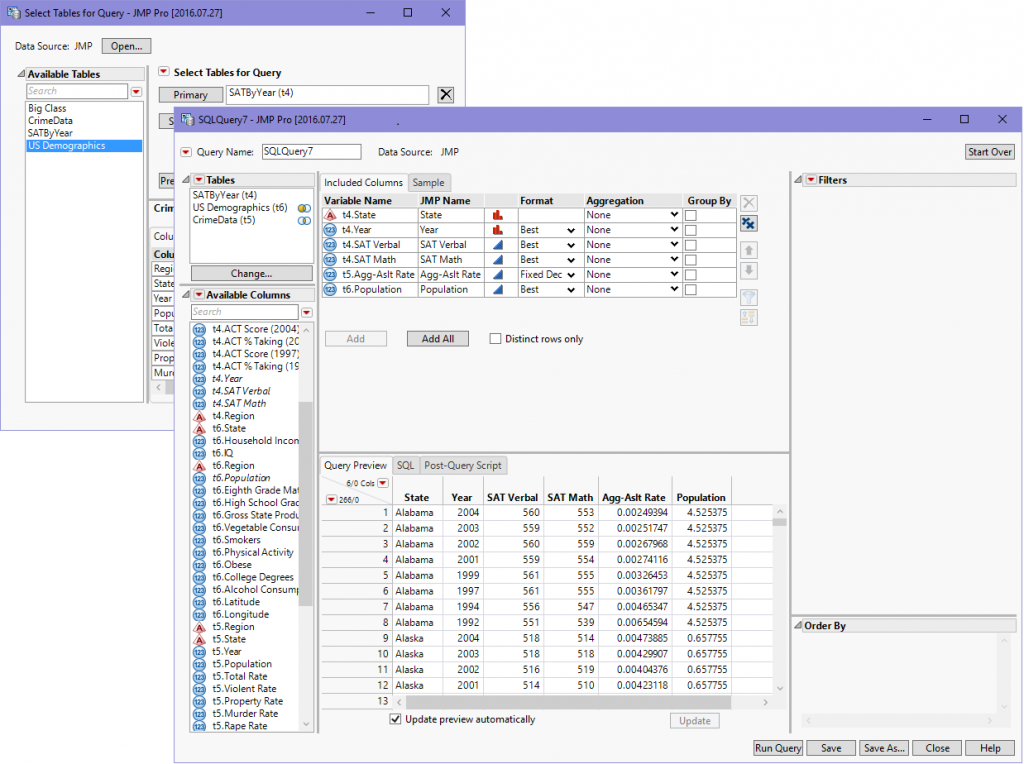 JMP Query Builderは最大 64 結合されるテーブル そのような多数のテーブルを1つのクエリにまとめた場合は、スクリーンショットを送ってください。
の他のすべての機能クエリビルダーフィルタやプロンプトなど、 JMPクエリービルダー。
Query()JSL関数
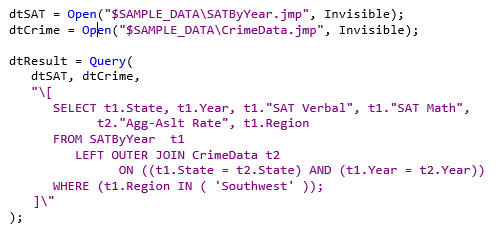
 Query BuilderがJMPデータ表を処理できるように、JMPにSQLエンジンを組み込みました。新しいJSL関数クエリ() 、そのSQLエンジンに直接アクセスできます。あなたが使用することができますクエリ() SQL文を使ってJMPデータテーブルを操作する関数。これが使用例です。土曜日そして CrimeData サンプルデータテーブル:
オープン時に実行
 JMP 13では、クエリを次のように設定できます。 [クエリビルダー]ウィンドウを開く代わりに、開くとすぐに実行されます。単にチェックしてくださいオープン時に実行 Query Builderウィンドウ上部の赤い三角メニューのオプション:
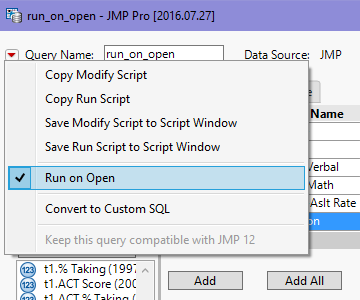 これは、フィルタを要求するクエリに特に役立ちます。これらのクエリを他のユーザに送信する(またはJMPアドインに組み込む)ことができます。他のユーザがクエリを開くと、フィルタプロンプトが表示されるだけです。これにより、クエリービルダーの複雑さに煩わされることなくフィルターを選択できます。
クエリがに設定されている場合オープン時に実行しかし、変更を加えるにはQuery Builderで開く必要がありますが、いくつかの選択肢があります。あなたが押した場合 Ctrl クエリを開くときにキーを押すと、クエリビルダーウィンドウが開きます。代わりに、クエリファイルを右クリックすることもできます。 JMPホームウィンドウそして選択クエリを編集 。
JMP 12で機能する照会の作成
 これらすべての優れたJMP 13 Query Builderの新機能に対する1つの注意点 - これらの機能を使用するクエリーを作成した場合、それらをJMP 12で開くことはできません。同時に、他の新機能を試すことができるように、同僚より早くJMP 13を入手することができます。
このシナリオを支援するために、作成した照会が依然としてJMP 12と互換性があるように、Query Builderのすべての新しいJMP 13機能を非表示にする設定をJMP 13に追加しました。好みは 「クエリービルダー設定」ページ :
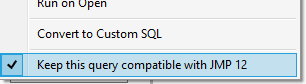
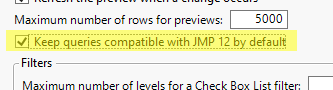 この設定を設定した後に作成したODBCまたはSASクエリは、JMP 12と互換性のある機能のみを許可します。特定の照会についてその規則を緩和したい場合は、Query Builderの赤い三角形のメニューにその照会のJMP 13機能を許可するためのチェックを外すことができるオプションがあります。
テーブルパネルの新機能
 のテーブル JMP 12のQuery Builderウィンドウのパネルには、クエリ内のテーブルのリストを表示する以外の機能はあまりありませんでした。 JMP 13では、そのパネルにはいくつかの機能が追加されました。
- で1つ以上のテーブルを選択するテーブルパネルは、リストに表示される列を制限します。利用可能な列選択されたテーブルからの列だけをパネル表示し、列を見つけやすくします。
- のテーブルパネルに各テーブルの結合タイプに対応するベン図アイコンが表示され、結合を編集したり、テーブルの別名を変更したり、コンテキストメニューのクエリからテーブルを削除したりできます。
- JMPデータテーブルを照会するときは、JMPデータテーブルのテーブルをダブルクリックします。テーブルパネルを使用すると、テーブルが表示されて前面に表示されます(または見るコンテキストメニューの項目)
「最初のN行」サンプリング
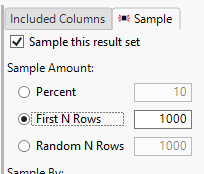
 データベースから大規模な表を照会するとき、時間とリソースを使ってすべてのデータを取得する前に、最初の1000行程度のデータを取得して実験することが役に立つ場合があります。
JMP 12では、最初のN行サンプリングはオラクルそして SQLサーバーデータベース。JMP 13では、次のような他のほとんどのデータベースに対するサポートが追加されました。 PostgreSQL 、 MySQL 、マイクロソフトアクセス 、 SQLite 、アパッチハイブ 、そしてクルデラインパラ 。
Hadoopとテキストファイルのサポートの向上
 最近、ますます多くのデータが「ビッグデータ」データベースに保存されています。JMP 13では、Apache Hive、Cloudera Impala、HortonWorksなどのソースに対する日付サポートが改善されています。また、でテーブルを保存するファイル>データベース>テーブルを保存これらのデータソースの一部ではうまく機能しませんでした。JMP 13では、ODBCを使用してHadoopベースのデータソースにデータを保存することは、データを効率的に取得する方法ではないという警告があり、改善されています。
あなたがCSVファイルで多くのことをするならば、マイクロソフトテキストファイル ODBCドライバはJMP 13で改良されました。
JMPデータをデータベースに保存する方がはるかに速いです
 データベースにデータを保存することで、必要な人にアクセスできるようになります。多くのリリースで、JMPはJMPデータテーブルをデータベースに保存することをサポートしています。ファイル>データベース>テーブルを保存特徴。しかし、データサイズがますます大きくなるにつれて、JMPテーブルをデータベースに保存するのにかかる時間が予想以上に長くなっているという報告がありました。JMP 13では、JMPテーブルをデータベースに保存するパフォーマンスが大幅に向上したこと、場合によっては劇的に向上したことを報告しています。この機能をもう一度お試しになり、あなたが経験したことをお知らせください。
バーチャルジョイン
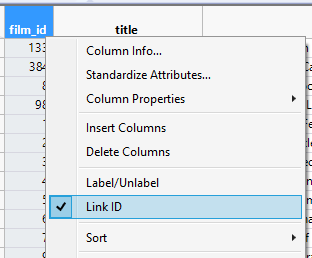
 JMPでは、分析しているすべてのデータがメモリに収まる必要があります。JMPデータテーブルを次のいずれかで結合するとテーブル>結合または新しい JMPクエリービルダーデータは、小さい「ルックアップ」テーブルから大きい結合結果に複製される傾向があります。この重複を防ぐために、バーチャルジョイン機能はJMP 13で追加されました。たとえば、DVDストアには在庫すべてのDVDがどこにあるかを知っているテーブルと膜各タイトルの詳細を含む表。の中に膜テーブル、私は設定することができます film_id になる列リンクID テーブル用:
それから、在庫テーブル、設定可能 film_id になるリンク参照に膜表。このアクションは、以下に基づいて2つのテーブルを効果的に結合します。 film_id カラム。
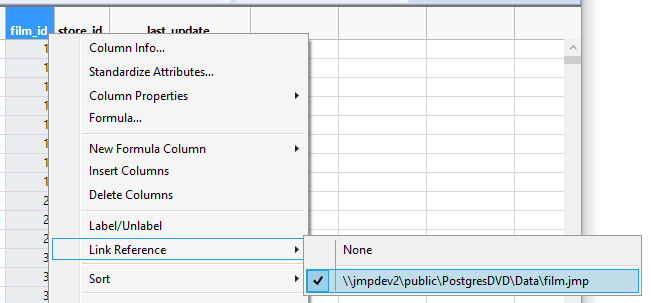
セットアップしたら、膜テーブルがの列リストに表示されます。在庫 彼らは「指定されています参照された列 "と"は最初は非表示です。どの列に表示したいかを表示することができます。在庫この場合はテーブルタイトル[film_id] :
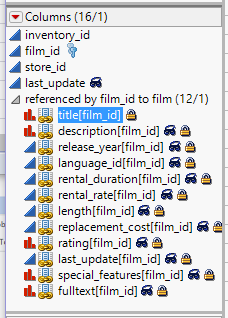
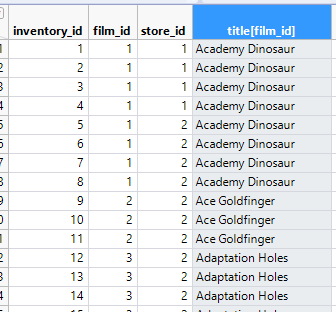 バーチャルジョインからの値を見ることができます膜の表在庫表。しかし、それらは物理的にコピーされていません。必要に応じて検索されるため、メモリを節約できます。
これはちょうど表面を傷付けるバーチャルジョインこれは、ブログ投稿にふさわしいものです。
それで、あなたはそれを持っています - JMP 13でデータにアクセスして操作するための多くの機能強化を見てください。どの機能がお気に入りですか?あなたはそれが言及されていないことを確認したいと思っていたどんな機能ですか?コメント欄で教えてください。
JMPデータテーブルにQuery Builderを使用する方法の詳細については、次のWebサイトを参照してください。ディスカバリーサミットポスター発表の中に JMPユーザーコミュニティ 。そこにいる間に、私のDiscovery Summitチュートリアルのスライドも見ることができます。 JMP 13のクエリービルダーですべてのデータをまとめよう "

