Análisis de componentes principales (PCA) Es un método tradicional en el análisis de datos y, más específicamente, en el análisis multivariado. PCA fue desarrollado por Karl Pearson en 1901.
El objetivo de la PCA es reducir la dimensionalidad en un conjunto de variables correlacionadas en un conjunto más pequeño de variables no correlacionadas que explican la mayoría de la variación en las variables originales. Es una técnica útil cuando se explora la estructura de correlación en un conjunto de variables predictoras y en modelos predictivos o Regresión de componentes principales (PCR) donde los componentes principales se utilizan como predictores en modelos de regresión.
Aquí hay un ejemplo simple: Consideremos este conjunto de datos sobre autos de Probabilités, Analyze de données et Statistique .
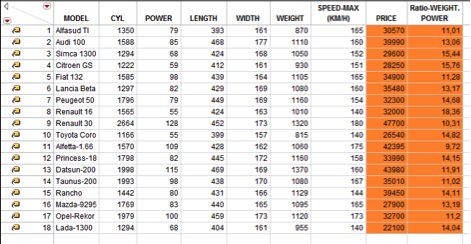
El conjunto de datos tiene 18 filas con ocho columnas numéricas. Podríamos investigar las relaciones entre pares de variables. Por ejemplo, la velocidad máxima está correlacionada con la potencia.
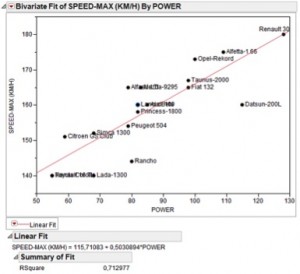
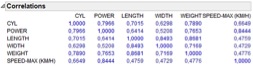
Pero con un gran número de variables, es más conveniente resumir las relaciones de pares con una matriz de correlación, y observamos un gran número de correlaciones positivas. También vemos que la velocidad máxima está más fuertemente correlacionada con el cilindro y la potencia.
Debido a la estructura de correlación en este conjunto de variables, podemos esperar reducir el número de dimensiones utilizando PCA.

Vemos que tenemos dos grupos distintos con respecto al segundo componente. Un grupo está relacionado con las características de tamaño del automóvil (longitud, anchura, peso) y el segundo grupo está relacionado con las características del motor (potencia, velocidad máxima, cilindro).
Variables ilustrativas
Las variables ilustrativas no tienen impacto en la construcción de los nuevos componentes. Se utilizan para ayudar a interpretar los componentes y relacionarlos con otras variables (en este caso, relación precio / peso a potencia).
Puedes descargar el Complemento JMP para PCA con variables ilustrativas desde el intercambio de archivos JMP. (La descarga requiere un perfil SAS gratuito.)
Este complemento le permitirá agregar variables ilustrativas a un PCA.
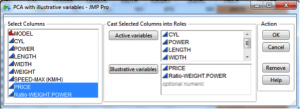
Utilizando nuestro ejemplo anterior, la PCA con variables ilustrativas nos permite visualizar la relación entre el precio y la relación peso / potencia (variable naranja en el conjunto de datos anterior) y los componentes principales sin usar estas variables adicionales para desarrollar la PCA.

Podemos ver que el precio está claramente correlacionado con todas las variables y se agrupa con el número de cilindros, la potencia y la velocidad máxima. Entonces, un auto caro es un auto grande o poderoso.
La segunda variable ilustrativa, la relación peso / potencia, se correlaciona negativamente con la potencia del automóvil con respecto a los dos componentes y se correlaciona negativamente con el peso con respecto al primer componente. Es claramente debido al hecho de que el peso puede tener un impacto negativo en la potencia de un automóvil.
Referencias
G. SAPORTA, «Probabilités, Analyze de données et Statistique», TECHNIP, 2006 (en francés).
Dan Obermiller escribió:
Joel,
Probablemente la mejor respuesta a su pregunta es usar agrupamiento de variables ( http://blogs.sas.com/content/jmp/2013/03/13/variable-clustering-in-jmp/ ). Sin embargo, esa es una característica de JMP Pro.
Con un poco de esfuerzo y opiniones subjetivas, puede usar la gráfica de cargas (la gráfica con un rayo que representa cada variable) de PCA para reducir la cantidad de variables que mide. Todos los rayos que apuntan en aproximadamente la misma dirección están altamente correlacionados entre sí. Por lo tanto, solo podría uno de los "conjuntos" para representar todas las variables en ese conjunto. Esta evaluación debería ayudarlo a reducir la cantidad de pruebas que necesita realizar.
Anish nair escribió:
Señora, ¿sabe cómo encontrar la proporción de responsabilidad de los componentes principales?
Mike Clayton escribió:
Muchas gracias. Quizás pueda encontrar más ideas, incluidos algunos conjuntos de datos de esfuerzos anteriores de software en este importante campo. La gente de Chemometrics and Control Systems tradicionalmente utiliza Matlab y existe un kit de herramientas para Matlab PLS que trabaja con PCA para tratar muchos problemas multivariados más complejos. El equipo de Eigenvector Research enseñó los métodos de VM en Sematech hace muchos años, y en ese momento las únicas herramientas en JMP eran el Spin Plot y sus subrutinas. Utilizaron algunos de sus conjuntos de datos de cantera para mostrarnos cómo usar esa función en JMP, tan limitado como estaba. Otro líder de monitoreo multivariado durante muchos años fue Svante Wold, quien fundó Umetrics. La PCA cuando se combina con PLS (puede significar mínimos cuadrados parciales o Estructuras latentes del proyecto) se puede usar para el monitoreo de SPC de MV según me dicen (sin embargo, no hay experiencia personal al hacerlo).
Joel Dobson escribió:
Supongamos que tengo un programa de prueba de semiconductores con 1000 registros de datos. Cada registro de datos es una medida eléctrica en un chip IC y es una variable continua. Cada registro de datos puede ser una resistencia, una corriente, una capacitancia, una inductancia o un voltaje, por ejemplo, entre otras cosas.
Uno podría tener muchos voltajes del mismo tipo medidos en cada chip, correspondientes a transistores de diseño similar pero de diferente tamaño, por ejemplo. Estas múltiples lecturas a menudo pueden tener una extensa multicolinealidad entre ellas. Por ejemplo, los voltajes de umbral están relacionados inherentemente con las corrientes de excitación y las corrientes de excitación con las corrientes de fuga.
Mi objetivo es ver si puedo reducir el tiempo de prueba midiendo solo los pocos parámetros de registro de datos que explican la mayor parte de la variación, y dejar de medir los que son altamente multicolineales con los que sigo leyendo.
Pensé en usar PCA para reducir la dimensionalidad como sugieres, pero cada vector propio de PC es una combinación lineal de todos los parámetros del registro de datos. Por lo tanto, aunque pasar a las primeras PC reduce la dimensionalidad del problema, pero no reduce el tiempo de prueba. ¿Puede ayudarme a averiguar cómo hacer lo que estoy tratando de hacer con JMP 10? (No tengo JMP Pro.)
Un saludo, Joel Dobson
