주성분 분석 (PCA) 데이터 분석, 특히 다변량 분석의 전통적인 방법입니다. PCA는 1901 년 Karl Pearson에 의해 개발되었습니다.
PCA의 목표는 상관 관계가있는 변수 세트의 차원을 원래 변수의 대다수를 설명하는 더 적은 비 상관 변수 집합으로 줄이는 것입니다. 이는 예측 변수 집합과 예측 모델링 또는 주요 구성 요소가 회귀 모델의 예측 변수로 사용되는 주 구성 요소 회귀 분석 (PCR)의 상관 관계 구조를 탐색 할 때 유용한 기술입니다.
다음은 간단한 예입니다. 자동차에 대한이 데이터 세트를 조사 분석, 분석 및 통계 .
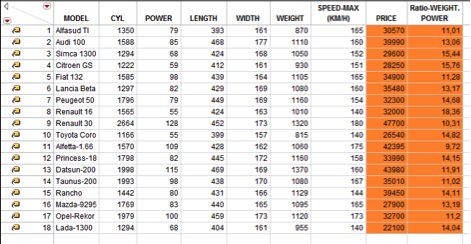
데이터 세트에는 8 개의 숫자 열이있는 18 개의 행이 있습니다. 변수 쌍들 사이의 관계를 조사 할 수 있습니다. 예를 들어 최대 속도는 전력과 관련이 있습니다.
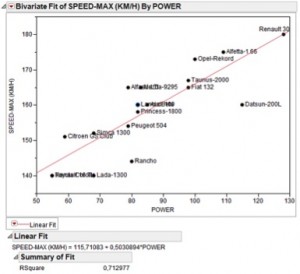
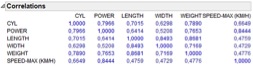
그러나 많은 수의 변수를 사용하면 상관 관계 행렬을 사용하여 쌍 방향 관계를 요약하는 것이 더 편리하며 다수의 양의 상관 관계를 관찰합니다. 최대 속도는 실린더 및 동력과 가장 밀접한 상관 관계가 있음을 알 수 있습니다.
이 변수 세트의 상관 구조 때문에 PCA를 사용하여 차원 수를 줄일 수 있습니다.

우리는 두 번째 구성 요소에 관해 두 개의 별개의 그룹이 있음을 알 수 있습니다. 하나의 그룹은 자동차의 크기 특성 (길이, 폭, 무게)과 관련이 있으며, 두 번째 그룹은 모터 특성 (동력, 최대 속도, 실린더)과 관련이 있습니다.
변수 예
변수의 예는 새로운 구성 요소의 구성에 영향을 미치지 않습니다. 이들은 구성 요소를 해석하고 다른 변수 (이 경우 가격 및 중량 대비 전력 비율)와 관련시키는 데 사용됩니다.
다운로드 할 수 있습니다. 설명 변수가있는 PCA 용 JMP 애드 인 JMP 파일 교환에서. (다운로드하려면 무료 SAS 프로파일이 필요합니다.)
이 추가 기능을 사용하면 설명 변수를 PCA에 추가 할 수 있습니다.
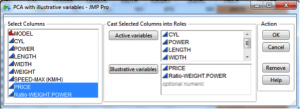
이전 예제를 사용하여 PCA를 설명 변수로 사용하여 PCA를 구축하기 위해 이러한 추가 변수를 사용하지 않고 무게 대비 가격 (이전 데이터 세트의 주황색 변수)과 주 구성 요소 간의 가격과 비례 관계를 시각화 할 수 있습니다.

우리는 가격이 모든 변수와 명확하게 상관 관계가 있으며 실린더, 동력 및 속도의 수와 함께 그룹화 된 것을 볼 수 있습니다. 따라서 비싼 차는 큰 차 또는 강력한 차입니다.
제 2의 예시적인 변수 인 가중 대 전력비는 2 개의 구성 요소에 관한 카의 파워와 음의 상관 관계가 있고, 제 1의 구성 요소에 관한 중량과 음의 상관 관계가있다. 무게가 자동차의 힘에 부정적인 영향을 줄 수 있다는 사실이 분명합니다.
참고 문헌
G. SAPORTA,«기술 분석, 통계 및 분석», TECHNIP, 2006 (프랑스어).
댄 오 버밀러 쓴 :
조엘,
아마도 귀하의 질문에 대한 최선의 대답은 변수 클러스터링 ( http://blogs.sas.com/content/jmp/2013/03/13/variable-clustering-in-jmp/ ). 그러나 JMP Pro 기능입니다.
약간의 노력과 주관적인 견해로, PCA의로드 플롯 (각 변수를 나타내는 광선이있는 플롯)을 사용하여 측정하는 변수의 수를 줄일 수 있습니다. 거의 같은 방향을 가리키는 모든 광선은 서로 상호 관련성이 높습니다. 따라서 "집합"중 하나만 사용하여 해당 집합의 모든 변수를 나타낼 수 있습니다. 이 appraoch는 당신이 perfrom에 필요한 테스트의 수를 줄이는 데 도움이됩니다.
아니 쉬 나이 르 쓴 :
마담은 어떻게 주된 구성 요소로부터 책임 성 비율을 찾는 지 알고 있나요 ???
마이크 클레이튼 쓴 :
매우 감사합니다. 이 중요한 분야의 이전 소프트웨어 노력에서 나온 일부 데이터 세트를 포함하여 더 많은 아이디어를 찾을 수 있습니다. Chemometrics and Control Systems 사람들은 전통적으로 Matlab을 사용하고 더 복잡한 다중 변수 문제를 다루기 위해 PCA와 함께 작동하는 Matlab PLS 용 툴킷이 있습니다. Eigenvector Research 팀은 수년 전 Sematech에서 MV 방법을 가르쳤으며 그 당시 JMP의 유일한 도구는 스핀 플롯과 그 서브 루틴이었습니다. 그들은 채석장 데이터 세트 중 일부를 사용하여 JMP에서 해당 기능을 사용하는 방법을 제한적으로 보여주었습니다. 수년 동안 또 다른 다 변수 모니터링 리더는 Umetrics를 설립 한 Svante Wold입니다. Partial Least Squares 또는 Project Latent Structures와 같은 PLS와 결합 된 PCA는 MV SPC 모니터링에 사용될 수 있습니다 (단, 개인적인 경험으로는이를 수행하지 않습니다).
조엘 돕슨 쓴 :
1000 개의 데이터 로그가있는 반도체 테스트 프로그램이 있다고 가정합니다. 각 데이터 로그는 IC 칩의 일부 전기적 측정 값이며 연속 변수입니다. 각 데이터 로그는 저항, 전류, 커패시턴스, 인덕턴스 또는 전압이 될 수 있습니다.
유사한 칩이지만 크기가 다른 트랜지스터에 해당하는 각 칩에서 동일한 유형의 많은 전압을 측정 할 수 있습니다. 이러한 여러 판독 값은 종종 여러 개의 다중 선명도를 가질 수 있습니다. 예를 들어, 임계 전압은 본질적으로 구동 전류 및 누설 전류로의 구동 전류와 관련이 있습니다.
필자의 목표는 대부분의 변형을 설명하는 몇 가지 데이터 로그 매개 변수 만 측정하여 테스트 시간을 단축 할 수 있는지 확인하고, 계속 읽고있는 것들과 함께 매우 다중 선상 인 것들을 측정하는 것을 중단하는 것입니다.
PCA를 사용하여 치수를 줄이는 방법을 생각했지만 각각의 PC 고유 벡터는 모든 데이터 로그 매개 변수의 선형 조합입니다. 따라서 처음 몇 대의 PC로 이동해도 문제의 차원이 줄어들지 만 테스트 시간은 줄어들지 않습니다. JMP 10을 사용하여 수행하려는 작업을 수행하는 방법을 이해할 수 있습니까? (나는 JMP Pro가 없다.)
안부, 조엘 돕슨
