主成分分析(PCA) はデータ分析、より具体的には多変量解析における伝統的な方法です。PCAは1901年にKarl Pearsonによって開発されました。
PCAの目的は、元の変数の変動の大部分を説明する、一連の相関変数の次元を、より小さな一連の非相関変数に減らすことです。これは、一連の予測変数、および回帰モデルで主成分が予測子として使用される予測モデリングまたは主成分回帰分析(PCR)で相関構造を調べるときに役立ちます。
これは簡単な例です。 Probabilités、Analyse dedonnéeset Statistique 。
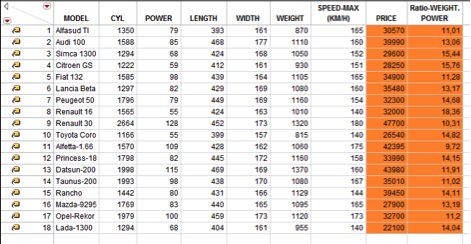
データセットには、18行と8つの数値列があります。変数のペア間の関係を調べることができます。たとえば、最高速度は電力と相関しています。
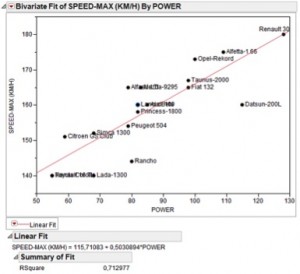
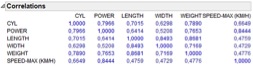
しかし、変数の数が多いと、相関行列を使用してペアの関係を要約するほうが便利であり、多数の正の相関が観察されます。また、最高速度はシリンダーとパワーと最も強く相関していることがわかります。
この一連の変数には相関構造があるため、PCAを使用して次元数を減らすことができます。

2番目の要素に関して、2つの異なるグループがあることがわかります。1つのグループは車のサイズ特性(長さ、幅、重量)に関連し、2つ目のグループはモーター特性(パワー、最高速度、シリンダー)に関連しています。
例示的な変数
例示的な変数は、新しいコンポーネントの構築に影響を与えません。それらは、構成要素の解釈を助け、それらを他の変数(この場合は、価格と重量対電力比)に関連付けるのに役立ちます。
あなたはダウンロードすることができます説明変数を含むPCA用のJMPアドイン JMPファイル交換から。(ダウンロードには無料のSASプロファイルが必要です。)
このアドインを使用すると、PCAに例示的な変数を追加できます。
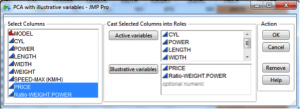
前の例では、説明変数を使用したPCAを使用すると、PCAを構築するためにこれらの追加の変数を使用しなくても、価格と重量比(前のデータセットのオレンジ変数)と主成分の関係を視覚化できます。

価格はすべての変数と明確に相関しており、気筒数、出力、および最高速度でグループ化されていることがわかります。だから高価な車は大きな車や強力な車です。
第2の例示的変数、すなわち重量対出力比は、2つの構成要素に関して自動車の出力と負の相関があり、第1の構成要素に関して重量と負の相関がある。それは明らかにその重さが車のパワーに悪影響を及ぼす可能性があるという事実によるものです。
参考文献
G. SAPORTA、«Probabilités、Analyze dedonnéeset Statistique»、TECHNIP、2006年(フランス語)。
ダン・オバーミラー書きました:
ジョエル、
おそらくあなたの質問に対する最良の答えは変数クラスタリングを使うことです( http://blogs.sas.com/content/jmp/2013/03/13/variable-clustering-in-jmp/ ) しかし、それはJMP Proの機能です。
多少の努力と主観的な意見があれば、PCAからの負荷量プロット(各変数を表す光線を含むプロット)を使用して、測定する変数の数を減らすことができます。ほぼ同じ方向を向いているすべての光線は互いに高度に相関しています。したがって、そのセット内のすべての変数を表すには、「セット」の1つだけを使用できます。この方法は、実行する必要があるテストの数を減らすのに役立ちます。
アニッシュネイル書きました:
マダムはどのように主成分から説明責任の割合を見つけるのか知っていますか?
マイク・クレイトン書きました:
どうもありがとう。あなたはおそらく、この重要な分野における初期のソフトウェアの取り組みから得られたいくつかのデータセットを含む、より多くのアイデアを見つけることができます。ケモメトリックスおよび制御システムの人々は伝統的にMatlabを使用しており、PCAと連携してより複雑な多変量問題を処理するためのMatlab PLS用のツールキットがあります。Eigenvector Researchチームは何年も前にSematechでMV法を教えていました、そしてその時JMPの唯一のツールはスピンプロットとそのサブルーチンでした。彼らはいくつかの採石場データセットを使って、JMPでその機能をどのように使うべきかを示しました。長年のもう1つの多変量モニタリングリーダーは、Smete Woldで、Umetricsを設立しました。PCSをPLS(Partial Least Squares、またはProject Latent Structures)と組み合わせると、MV SPCモニタリングに使用できます(ただし、個人的な経験はありません)。
ジョエルドブソン書きました:
1000個のデータログを含む半導体テストプログラムがあるとします。各データログはICチップ上の電気的測定値であり、連続変数です。各データログは、とりわけ、例えば、抵抗、電流、キャパシタンス、インダクタンス、または電圧であり得る。
例えば、設計は似ているがサイズが異なるトランジスタに対応して、各チップで測定された同じタイプの多数の電圧を有することがある。これらの複数の読みは、それらの間で広範囲の多線形性を持つことがよくあります。例えば、閾値電圧は本質的に駆動電流に関係し、駆動電流は漏れ電流に関係する。
私の目標は、変動の大部分を説明する少数のデータログパラメータを測定するだけでテスト時間を短縮できるかどうかを確認することです。
私はあなたが示唆するように次元を減らすためにPCAを使うことを考えていました、しかし各PC固有ベクトルはすべてのデータログパラメータの線形結合です。そのため、最初の数台のPCに移行しても問題の規模は減りますが、テスト時間は減りません。JMP 10を使用して私がやろうとしていることを実行する方法を見つけ出すのを手伝ってもらえますか?(私はJMP Proを持っていません。)
よろしく、ジョエルドブソン
