Principal Component Analysis (PCA) è un metodo tradizionale nell'analisi dei dati e, più specificamente, nell'analisi multivariata. PCA è stato sviluppato da Karl Pearson nel 1901.
L'obiettivo di PCA è ridurre la dimensionalità in un insieme di variabili correlate in un insieme più piccolo di variabili non correlate che spiegano la maggior parte della variazione nelle variabili originali. È una tecnica utile quando si esplora la struttura di correlazione in un insieme di variabili predittive e in modellizzazione predittiva o PCR (Principal Component Regression) in cui i componenti principali vengono utilizzati come predittori nei modelli di regressione.
Ecco un semplice esempio: consideriamo questo set di dati sulle auto da Probabilités, Analyze de données et Statistique .
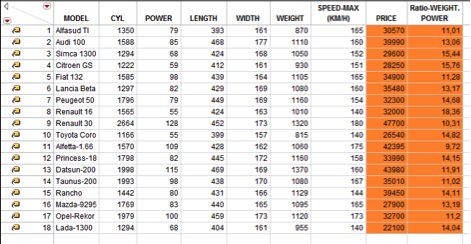
Il set di dati ha 18 righe con otto colonne numeriche. Potremmo studiare le relazioni tra coppie di variabili. Ad esempio, la velocità massima è correlata alla potenza.
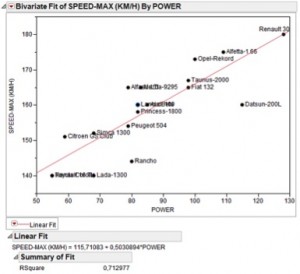
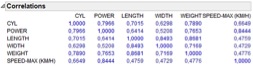
Ma con un gran numero di variabili, è più conveniente riassumere le relazioni a coppie con una matrice di correlazione e osserviamo un gran numero di correlazioni positive. Vediamo anche che la massima velocità è fortemente correlata al cilindro e alla potenza.
A causa della struttura di correlazione in questo set di variabili, possiamo aspettarci di ridurre il numero di dimensioni utilizzando PCA.

Vediamo che abbiamo due gruppi distinti rispetto al secondo componente. Un gruppo è correlato alle caratteristiche dimensionali della vettura (lunghezza, larghezza, peso) e il secondo gruppo è correlato alle caratteristiche del motore (potenza, velocità massima, cilindro).
Variabili illustrative
Le variabili illustrative non hanno alcun impatto sulla costruzione dei nuovi componenti. Sono usati per aiutare a interpretare i componenti e metterli in relazione con altre variabili (in questo caso, rapporto prezzo / peso / potenza).
Puoi scaricare il Componente aggiuntivo JMP per PCA con variabili illustrative da JMP File Exchange. (Il download richiede un profilo SAS gratuito.)
Questo componente aggiuntivo ti consentirà di aggiungere variabili illustrative a un PCA.
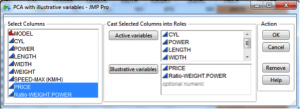
Utilizzando il nostro esempio precedente, PCA con variabili illustrative ci consente di visualizzare la relazione tra il prezzo e il rapporto tra peso e potenza (variabile arancione nel set di dati precedente) e le componenti principali senza utilizzare queste variabili aggiuntive per costruire l'APC.

Possiamo vedere che il prezzo è chiaramente correlato con tutte le variabili e raggruppato con il numero di cilindri, potenza e velocità-max. Quindi una macchina costosa è una macchina grande o una macchina potente.
La seconda variabile illustrativa, il rapporto peso / potenza, è negativamente correlata alla potenza della macchina rispetto ai due componenti ed è negativamente correlata al peso relativo al primo componente. È chiaramente dovuto al fatto che il peso può avere un impatto negativo sulla potenza di un'auto.
Riferimenti
G. SAPORTA, «Probabilités, Analyze de données et Statistique», TECHNIP, 2006 (in francese).
Dan Obermiller ha scritto:
Gioele,
Probabilmente la migliore risposta alla tua domanda è usare il clustering variabile ( http://blogs.sas.com/content/jmp/2013/03/13/variable-clustering-in-jmp/ ). Tuttavia, questa è una funzione di JMP Pro.
Con alcuni sforzi e opinioni soggettive, è possibile utilizzare il grafico dei caricamenti (la trama con un raggio che rappresenta ciascuna variabile) da PCA per ridurre il numero di variabili misurate. Tutti i raggi che puntano approssimativamente nella stessa direzione sono altamente correlati l'uno con l'altro. Pertanto, si potrebbe solo uno dei "set" per rappresentare tutte le variabili in quel set. Questo appraoch dovrebbe aiutarti a ridurre il numero di test che devi perfrontare.
Anish Nair ha scritto:
Signora, sai come trovare la proporzione di responsabilità dai componenti principali ???
Mike Clayton ha scritto:
Grazie mille. È possibile trovare forse più idee tra cui alcuni set di dati da precedenti sforzi del software in questo campo importante. I dipendenti di Chemometrics e Control Systems utilizzano tradizionalmente Matlab e esiste un toolkit per Matlab PLS che funziona con PCA per gestire molti problemi multivariati più complessi. Il team di ricerca di Eigenvector ha insegnato metodi MV presso la Sematech molti anni fa, e in quel momento gli unici strumenti in JMP erano lo Spin Plot e le sue subroutine. Hanno usato alcuni dei loro set di dati della cava per mostrarci come utilizzare quella funzionalità in JMP, per quanto limitata. Un altro leader di monitoraggio multivariato per molti anni fu Svante Wold, che fondò Umetrics. PCA quando combinato con PLS (può significare Minimi quadrati parziali, o strutture Latenti del progetto) può essere usato per il monitoraggio MV SPC che mi viene detto (nessuna esperienza personale che lo faccia, comunque).
Joel Dobson ha scritto:
Supponiamo di avere un programma di test con semiconduttori con 1000 datalog. Ogni datalog è una misura elettrica su un chip IC ed è una variabile continua. Ogni datalog potrebbe essere una resistenza, una corrente, una capacità, un'induttanza o una tensione, ad esempio, tra le altre cose.
Uno potrebbe avere molte tensioni dello stesso tipo misurate su ciascun chip, corrispondenti a transistor di design simile ma di dimensioni diverse ad esempio. Queste letture multiple possono spesso avere un'ampia multicolinearità tra di loro. Ad esempio, le tensioni di soglia sono intrinsecamente correlate alle correnti del convertitore di frequenza e alle correnti di pilotaggio alle correnti di dispersione.
Il mio obiettivo è vedere se riesco a ridurre il tempo di test misurando solo i pochi parametri di datalog che spiegano la maggior parte della variazione, e smetto di misurare quelli che sono altamente multicolinulari con quelli che continuo a leggere.
Avevo pensato di utilizzare PCA per ridurre la dimensionalità come suggerito, ma ogni autopilota del PC è una combinazione lineare di tutti i parametri del registro dati. Quindi, anche se passare ai primi PC riduce la dimensionalità del problema, ma non riduce il mio tempo di test. Puoi aiutarmi a capire come fare ciò che sto cercando di fare usando JMP 10? (Non ho JMP Pro.)
Saluti, Joel Dobson
