Add-In für PCA und illustrative Variablen für JMP Hauptkomponentenanalyse (PCA) ist eine traditionelle Methode in der Datenanalyse und insbesondere in der multivariaten Analyse. PCA wurde 1901 von Karl Pearson entwickelt.
Das Ziel von PCA besteht darin, die Dimensionalität eines Satzes korrelierter Variablen in einen kleineren Satz unkorrelierter Variablen zu reduzieren, die die Mehrheit der Variationen in den ursprünglichen Variablen erklären. Dies ist eine hilfreiche Technik, wenn die Korrelationsstruktur in einem Satz von Prädiktorvariablen untersucht wird und bei der prädiktiven Modellierung oder der Hauptkomponentenregression (PCR), bei der die Hauptkomponenten als Prädiktoren in Regressionsmodellen verwendet werden.
Hier ein einfaches Beispiel: Betrachten wir diese Daten über Autos von Probabilités, Analyse der Ereignisse und Statistiken .
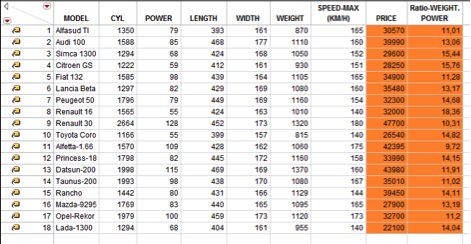
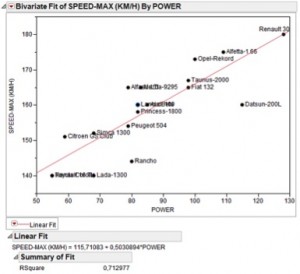
Der Datensatz hat 18 Zeilen mit acht numerischen Spalten. Wir könnten Beziehungen zwischen Variablenpaaren untersuchen. Zum Beispiel hängt die maximale Geschwindigkeit mit der Leistung zusammen.
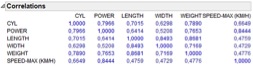
Bei einer großen Anzahl von Variablen ist es jedoch günstiger, die paarweisen Beziehungen mit einer Korrelationsmatrix zusammenzufassen, und wir beobachten eine Vielzahl positiver Korrelationen. Wir sehen auch, dass die maximale Geschwindigkeit am stärksten mit dem Zylinder und der Leistung zusammenhängt.
Aufgrund der Korrelationsstruktur in dieser Menge von Variablen können wir erwarten, dass die Anzahl der Dimensionen mithilfe von PCA reduziert wird.

Wir sehen, dass wir bezüglich der zweiten Komponente zwei unterschiedliche Gruppen haben. Eine Gruppe bezieht sich auf Größenmerkmale des Autos (Länge, Breite, Gewicht) und die zweite Gruppe bezieht sich auf Motoreigenschaften (Leistung, maximale Geschwindigkeit, Zylinder).
Illustrative Variablen
Illustrative Variablen haben keinen Einfluss auf die Konstruktion der neuen Komponenten. Sie werden verwendet, um die Komponenten zu interpretieren und sie mit anderen Variablen zu verknüpfen (in diesem Fall Preis und Gewichtsverhältnis).
Sie können das herunterladen JMP-Add-In für PCA mit illustrativen Variablen aus dem JMP File Exchange. (Für den Download ist ein kostenloses SAS-Profil erforderlich.)
Mit diesem Add-In können Sie einem PCA illustrative Variablen hinzufügen.
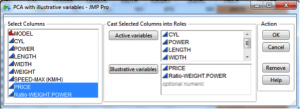
Mit unserem vorherigen Beispiel, PCA mit illustrativen Variablen, können wir die Beziehung zwischen Preis und Verhältnis von Gewicht zu Leistung (orangefarbene Variable im vorherigen Datensatz) und den Hauptkomponenten visualisieren, ohne diese zusätzlichen Variablen zur Erstellung der PCA zu verwenden.

Wir können sehen, dass der Preis eindeutig mit allen Variablen korreliert ist und mit der Anzahl der Zylinder, der Leistung und der Drehzahl-max zusammengefasst ist. Ein teures Auto ist also ein großes Auto oder ein kraftvolles Auto.
Die zweite veranschaulichende Variable, das Verhältnis von Gewicht zu Leistung, ist bezüglich der zwei Komponenten negativ mit der Leistung des Fahrzeugs und mit der ersten Komponente negativ mit dem Gewicht korreliert. Dies ist eindeutig darauf zurückzuführen, dass das Gewicht die Kraft eines Autos negativ beeinflussen kann.
Verweise
G. SAPORTA, «Probabilités, Analyse von Données et Statistique», TECHNIP, 2006 (auf Französisch).
Dan Obermiller hat geschrieben: Joel, wahrscheinlich die beste Antwort auf ... Dan Obermiller schrieb:
Joel,
Wahrscheinlich ist die beste Antwort auf Ihre Frage die Verwendung von variablem Clustering ( http://blogs.sas.com/content/jmp/2013/03/13/variable-clustering-in-jmp/ ). Dies ist jedoch eine JMP Pro-Funktion.
Mit etwas Aufwand und subjektiven Meinungen können Sie die Belastungsdarstellung (die Darstellung mit einem Strahl, die jede Variable darstellt) von PCA verwenden, um die Anzahl der gemessenen Variablen zu reduzieren. Alle Strahlen, die ungefähr in dieselbe Richtung zeigen, sind stark miteinander korreliert. Daher können Sie nur eine der "Mengen" verwenden, um alle Variablen in dieser Gruppe darzustellen. Dieser Ansatz soll Ihnen helfen, die Anzahl der Tests, die Sie durchführen müssen, zu reduzieren.
Anish Nair hat geschrieben: Frau wissen Sie, wie Sie das Konto finden ... Anish Nair schrieb:
Frau wissen Sie, wie Sie den Verantwortlichkeitsanteil aus den Hauptkomponenten finden?
Mike Clayton hat geschrieben: Vielen Dank. Sie können Perhap finden ... Mike Clayton schrieb:
Vielen Dank. In diesem wichtigen Bereich finden Sie möglicherweise weitere Ideen, einschließlich einiger Datensätze aus früheren Softwarebemühungen. Die Leute von Chemometrics and Control Systems verwenden traditionell Matlab und es gibt ein Toolkit für Matlab PLS, das mit PCA zusammenarbeitet, um viele komplexere multivariate Probleme zu lösen. Das Team von Eigenvector Research lehrte vor vielen Jahren MV-Methoden bei Sematech. Zu dieser Zeit waren die einzigen Werkzeuge in JMP der Spin Plot und seine Subroutinen. Sie verwendeten einige ihrer Steinbruch-Datasets, um uns zu zeigen, wie diese Funktion in JMP verwendet werden kann, so beschränkt sie auch war. Ein weiterer multivariater Überwachungsführer für viele Jahre war Svante Wold, der Umetrics gründete. Wenn PCA mit PLS kombiniert wird (kann "Partial Least Squares" oder "Project Latent Structures" bedeuten), kann dies für die MV-SPC-Überwachung verwendet werden (es wird jedoch keine persönliche Erfahrung gemacht).
Joel Dobson hat geschrieben: Angenommen, ich habe einen Halbleitertest ... Joel Dobson schrieb:
Angenommen, ich habe ein Halbleitertestprogramm mit 1000 Datenprotokollen. Jedes Datenprotokoll ist eine elektrische Messung auf einem IC-Chip und ist eine stetige Variable. Jedes Datenprotokoll kann unter anderem ein Widerstand, ein Strom, eine Kapazität, eine Induktivität oder eine Spannung sein.
Auf jedem Chip können viele Spannungen desselben Typs gemessen werden, die beispielsweise Transistoren ähnlicher Bauart, jedoch unterschiedlicher Größe entsprechen. Diese Mehrfachablesungen können oft umfangreiche Multicolinearität aufweisen. Zum Beispiel sind Schwellenspannungen inhärent mit Ansteuerströmen und Ansteuerströmen zu Leckströmen verbunden.
Mein Ziel ist es, zu sehen, ob ich die Testzeit reduzieren kann, indem ich nur die wenigen Datenprotokollparameter misst, die den größten Teil der Abweichung erklären, und die Messung derjenigen, die hoch multicolinear sind, mit denen, die ich gerade lese, aufhört.
Ich hatte an PCA gedacht, um die Dimensionalität zu reduzieren, wie Sie vorschlagen, aber jeder PC-Eigenvektor ist eine lineare Kombination aller Datenprotokollparameter. Obwohl die Umstellung auf die ersten PCs zwar die Dimensionalität des Problems reduziert, meine Testzeit jedoch nicht verkürzt. Können Sie mir helfen, herauszufinden, wie ich mit JMP 10 arbeiten kann? (Ich habe kein JMP Pro.)
Viele Grüße, Joel Dobson
