Analyse en composantes principales (ACP) est une méthode traditionnelle en analyse de données et, plus spécifiquement, en analyse multivariée. PCA a été développé par Karl Pearson en 1901.
L’ACP a pour objectif de réduire la dimensionnalité d’un ensemble de variables corrélées en un ensemble plus petit de variables non corrélées qui explique la majeure partie de la variation des variables initiales. C'est une technique utile pour explorer la structure de corrélation dans un ensemble de variables prédictives et dans la modélisation prédictive ou la régression en composantes principales (PCR), où les composantes principales sont utilisées comme prédicteurs dans les modèles de régression.
Voici un exemple simple: Considérons cet ensemble de données sur les voitures de Probabilités, Analysis of Data and Statistics .
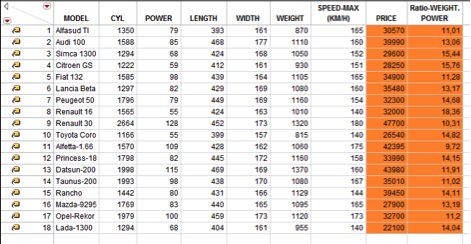
L'ensemble de données comprend 18 lignes avec huit colonnes numériques. Nous pourrions étudier les relations entre des paires de variables. Par exemple, la vitesse maximale est corrélée à la puissance.
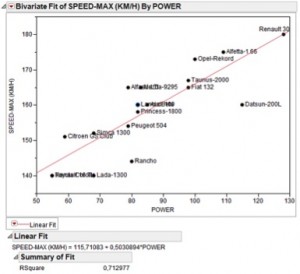
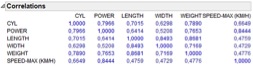
Mais avec un grand nombre de variables, il est plus pratique de résumer les relations par paires avec une matrice de corrélation et nous observons un grand nombre de corrélations positives. Nous constatons également que la vitesse maximale est étroitement liée au cylindre et à la puissance.
En raison de la structure de corrélation de cet ensemble de variables, nous pouvons nous attendre à réduire le nombre de dimensions à l'aide de PCA.

Nous voyons que nous avons deux groupes distincts concernant le deuxième composant. Un groupe est lié aux caractéristiques de taille de la voiture (longueur, largeur, poids) et le second groupe est associé à des caractéristiques du moteur (puissance, vitesse maximale, cylindres).
Variables illustratives
Les variables illustratives n’ont aucune incidence sur la construction des nouveaux composants. Ils sont utilisés pour aider à interpréter les composants et les relier à d'autres variables (dans ce cas, le prix et le rapport poids / puissance).
Vous pouvez télécharger le Complément JMP pour PCA avec variables illustratives de l'échange de fichiers JMP. (Le téléchargement nécessite un profil SAS gratuit.)
Ce complément vous permettra d'ajouter des variables illustratives à une ACP.
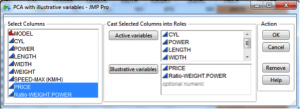
En utilisant notre exemple précédent, PCA avec des variables illustratives nous permet de visualiser la relation entre le prix et le rapport poids / puissance (variable orange dans le jeu de données précédent) et les composantes principales sans utiliser ces variables supplémentaires pour construire la PCA.

Nous pouvons voir que le prix est clairement corrélé avec toutes les variables et groupé avec le nombre de cylindres, la puissance et la vitesse maximale. Donc, une voiture chère est une grosse voiture ou une voiture puissante.
La deuxième variable illustrative, le rapport poids / puissance, est négativement corrélée à la puissance de la voiture en ce qui concerne les deux composants et est négativement corrélée au poids en ce qui concerne le premier composant. C'est clairement dû au fait que le poids peut avoir un impact négatif sur la puissance d'une voiture.
Références
G. SAPORTA, «Probabilités, Analyse de données et statistiques», TECHNIP, 2006 (en français).
Dan Obermiller a écrit:
Joel,
La meilleure réponse à votre question est probablement d’utiliser le clustering variable ( http://blogs.sas.com/content/jmp/2013/03/13/variable-clustering-in-jmp/ ). Cependant, il s’agit d’une fonctionnalité de JMP Pro.
Avec quelques efforts et des opinions subjectives, vous pouvez utiliser le tracé des chargements (le tracé avec un rayon représentant chaque variable) de PCA pour réduire le nombre de variables que vous mesurez. Tous les rayons qui se dirigent approximativement dans la même direction sont fortement corrélés les uns aux autres. Par conséquent, vous ne pouvez utiliser que l'un des "ensembles" pour représenter toutes les variables de cet ensemble. Cette approche devrait vous aider à réduire le nombre de tests que vous devez effectuer.
Anish Nair a écrit:
Madame savez-vous comment trouver la proportion de responsabilité des principaux composants ???
Mike Clayton a écrit:
Merci beaucoup. Vous pouvez trouver peut-être plus d'idées, notamment des jeux de données issus des efforts logiciels antérieurs de ce domaine important. Matlab est traditionnellement utilisé par les spécialistes de la chimiométrie et des systèmes de contrôle. Il existe une boîte à outils pour Matlab PLS qui fonctionne avec PCA pour traiter de nombreux problèmes multivariés plus complexes. L'équipe de recherche Eigenvector Research a enseigné les méthodes MV à Sematech il y a de nombreuses années. À cette époque, les seuls outils de JMP étaient le Spin Plot et ses sous-programmes. Ils ont utilisé certains de leurs jeux de données de carrière pour nous montrer comment utiliser cette fonctionnalité dans JMP, aussi limitée soit-elle. Svante Wold, qui a fondé Umetrics, a été un autre responsable de la surveillance multivariée pendant de nombreuses années. PCA, lorsqu'elle est associée à PLS (peut signifier les moindres carrés partiels, ou les structures latentes du projet) peut être utilisée pour la surveillance du CSP MV, me dit-on (aucune expérience personnelle dans ce domaine, toutefois).
Joel Dobson a écrit:
Supposons que j’ai un programme de test de semi-conducteurs avec 1000 enregistrements de données. Chaque journal de données est une mesure électrique sur une puce de circuit intégré et est une variable continue. Chaque journal de données peut être une résistance, un courant, une capacité, une inductance ou une tension, par exemple.
On pourrait avoir plusieurs tensions du même type mesurées sur chaque puce, correspondant à des transistors de conception similaire mais de taille différente par exemple. Ces lectures multiples peuvent souvent avoir une multicolinéarité étendue parmi elles. Par exemple, les tensions de seuil sont intrinsèquement liées aux courants de commande et aux courants de commande aux courants de fuite.
Mon objectif est de voir si je peux réduire le temps de test en mesurant uniquement les quelques paramètres d’enregistrement de données qui expliquent la majeure partie de la variation, et d’arrêter de mesurer ceux qui sont très multicolinéaires avec ceux que je lis toujours.
J'avais pensé utiliser PCA pour réduire la dimensionnalité, comme vous le suggérez, mais chaque vecteur propre PC est une combinaison linéaire de tous les paramètres d'enregistrement de données. Ainsi, bien que le passage aux premiers PC réduise la dimensionnalité du problème, mais ne réduit pas mon temps de test. Pouvez-vous m'aider à comprendre comment faire ce que j'essaie de faire avec JMP 10? (Je n'ai pas JMP Pro.)
Cordialement, Joel Dobson
