主成分分析(PCA) 是一種傳統的數據分析方法,更具體地說,是多變量分析。PCA由Karl Pearson於1901年開發。
PCA的目標是將一組相關變量中的維數減少為一組較小的不相關變量,這些變量解釋了原始變量的大部分變化。在探索一組預測變量和預測建模或主成分回歸(PCR)中的相關結構時,這是一種有用的技術,其中主成分用作回歸模型中的預測變量。
這是一個簡單的例子:讓我們考慮這個關於汽車的數據集 Probabilités,AnalyzededonnéesetStatistique 。
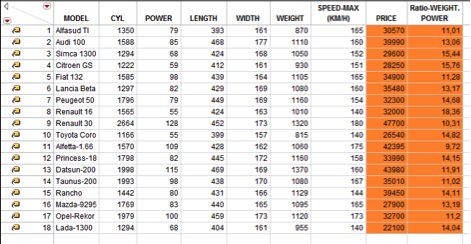
該數據集有18行,有8個數字列。我們可以調查變量對之間的關係。例如,最大速度與功率相關。
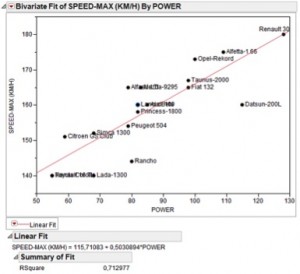
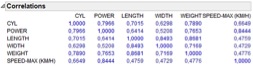
但是有了大量的變量,用相關矩陣來總結成對關係會更方便,我們觀察到大量的正相關。我們還看到最大速度與氣缸和功率最密切相關。
由於這組變量中的相關結構,我們可以期望使用PCA減少維數。

我們看到我們有關於第二個組件的兩個不同的組。一組與汽車的尺寸特徵(長度,寬度,重量)有關,第二組與電機特性(功率,最大速度,汽缸)有關。
說明性變量
說明性變量對新組件的構造沒有影響。它們用於幫助解釋組件並將它們與其他變量相關聯(在這種情況下,價格和權重與功率比)。
你可以下載具有說明性變量的PCA的JMP加載項來自JMP文件交換。(下載需要免費的SAS配置文件。)
此加載項允許您將說明性變量添加到PCA。
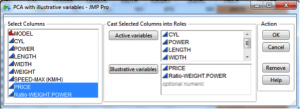
使用我們之前的示例,具有說明性變量的PCA允許我們可視化價格與權重與權力的比率(先前數據集中的橙色變量)與主要組件之間的關係,而不使用這些額外變量來構建PCA。

我們可以看到價格與所有變量明顯相關,並與氣缸數,功率和速度 - 最大值分組。因此,昂貴的汽車是一輛大汽車或一輛強大的汽車。
第二說明性變量(重量與功率比)與關於兩個部件的汽車的功率負相關,並且與關於第一部件的重量負相關。顯然,由於重量會對汽車的動力產生負面影響。
參考
G. SAPORTA,«Probabilités,AnalyzededonnéesetStatistique»,TECHNIP,2006(法文)。
Dan Obermiller 中寫道:
喬爾,
您的問題的最佳答案可能是使用變量聚類( http://blogs.sas.com/content/jmp/2013/03/13/variable-clustering-in-jmp/ )。但是,這是JMP Pro功能。
通過一些努力和主觀意見,您可以使用來自PCA的載荷圖(帶有代表每個變量的光線的圖)來減少您測量的變量數量。指向大致相同方向的所有光線彼此高度相關。因此,您可以只使用“set”中的一個來表示該集合中的所有變量。此appraoch應該可以幫助您減少需要執行的測試數量。
邁克克萊頓中寫道:
非常感謝。您可以找到更多的想法,包括來自早期軟件工作的一些數據集這一重要領域。化學計量學和控制系統人員傳統上使用Matlab,並且有一個Matlab PLS工具包,它與PCA一起處理許多更複雜的多變量問題。多年前,Eigenvector Research團隊在Sematech教授MV方法,當時JMP中唯一的工具是Spin Plot及其子程序。他們使用了一些採石場數據集向我們展示瞭如何在JMP中使用該功能,儘管它有限。多年來另一位多元監控領導者是創立Umetrics的Svante Wold。PCA與PLS(可能意味著偏最小二乘或項目潛在結構)相結合可以用於MV SPC監控我被告知(但是沒有個人經驗)。
喬爾多布森中寫道:
假設我有一個包含1000個數據記錄的半導體測試程序。每個數據記錄都是IC芯片上的一些電氣測量,是一個連續變量。例如,每個數據記錄可以是電阻,電流,電容,電感或電壓。
可以在每個芯片上測量許多相同類型的電壓,對應於類似設計但尺寸不同的晶體管。這些多個讀數通常可能具有廣泛的多重性。例如,閾值電壓固有地與驅動電流和驅動漏電流的電流相關。
我的目標是看看我是否可以通過僅測量解釋大部分變化的少數數據目錄參數來減少測試時間,並停止測量那些與我一直閱讀的高度多線性的參數。
我曾考慮使用PCA來降低維度,但每個PC特徵向量都是所有數據記錄參數的線性組合。因此,雖然轉移到前幾台PC確實減少了問題的維數,但並沒有減少我的測試時間。你能幫我弄清楚如何使用JMP 10做我想做的事嗎?(我沒有JMP Pro。)
此致,喬爾多布森
