Sur le prochain parlant analytiquement , nous entendrons Xan Gregg, JMP Directeur de la R & D et créateur du Graph Builder par glisser-déposer. Voici un aperçu de ce dont il va discuter. Accordez le mercredi 16 mars à 13 heures HE pour entendre le reste.
Q: Parlez-nous de l’importance des graphiques et de la visualisation des données.
A: Plus tôt dans ma carrière, je pouvais voir à quel point visualisation de données C'était, mais je ne comprenais pas vraiment pourquoi avant que je commence à étudier la perception et le fonctionnement de l'esprit. Une grande partie de l’esprit vient tout juste de se consacrer au traitement visuel, ce qui en fait un moyen très efficace d’obtenir des informations dans notre esprit.
Il y a un exemple célèbre, le quatuor d'Anscombe. Il contient quatre ensembles de données différents, et si vous regardez uniquement les chiffres d'un tableau, ils se ressemblent. Et si vous regardez les statistiques récapitulatives, elles sont les mêmes. Mais quand vous voyez les points eux-mêmes sur le diagramme de dispersion, vous pouvez immédiatement voir qu'ils sont tous différents.
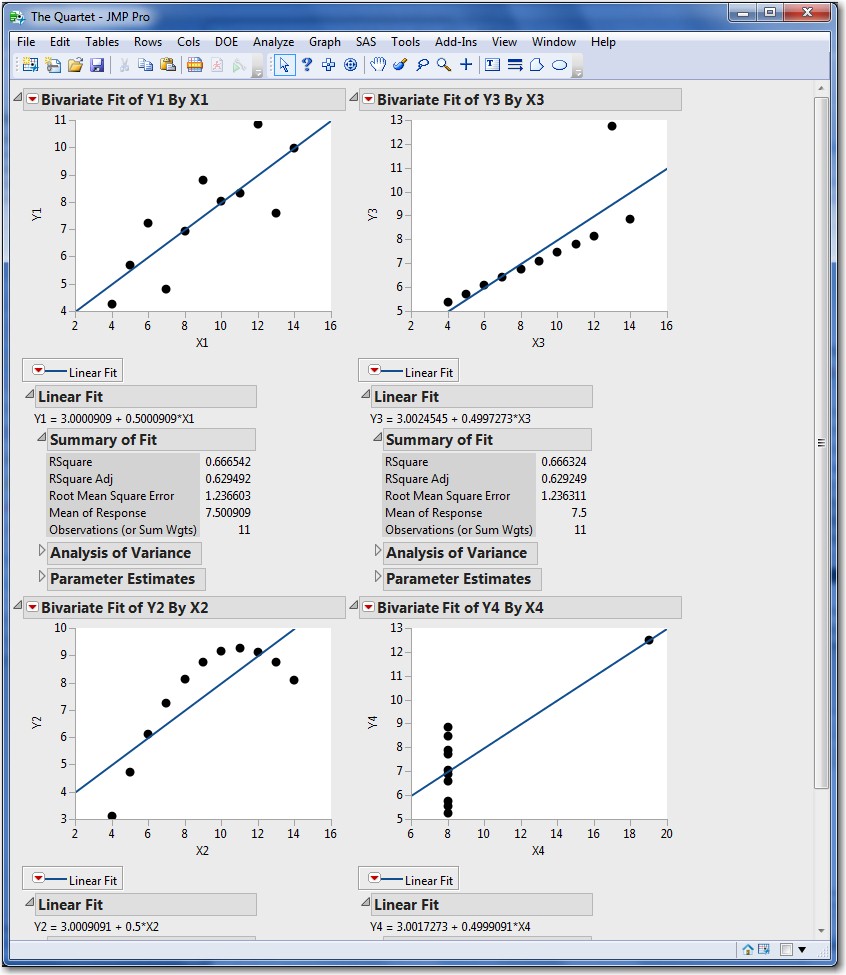
Anscombe's Quartet: Lorsque vous voyez les points eux-mêmes sur le diagramme de dispersion, vous pouvez voir immédiatement que les quatre ensembles de données sont tous différents.
C'est le pouvoir de la visualisation, juste dans cet exemple simple. Il s'étend également aux graphiques plus élaborés que nous avons aujourd'hui.
Q: Quel est votre point de vue sur la terminologie utilisée pour la visualisation des données?
R: La terminologie est parfois floue. Par exemple, «visualisation de données» par rapport à «visualisation d'informations» ou «descriptif» par rapport à «analytique» dépend de votre point de vue. Mais je pense que les termes désignent un éventail d’objectifs de visualisation de données. Parfois, nous examinons les données brutes, en particulier lorsque nous utilisons JMP pour l'exploration et la découverte. Nous voulons simplement voir le contenu des données et en obtenir une description. Mais d'autres fois, lorsque nous avons trouvé quelque chose et que nous voulons faire valoir un point; c'est à ce moment-là que nous utilisons une visualisation d'informations pour communiquer les résultats de l'analyse.
Et même avec les mêmes données, vous avez le choix de la façon dont vous les visualisez, ce qui modifie les informations. Si vous avez une série de points de données et que vous la considérez sous forme de barres, alors l'information que vous communiquez est qu'il s'agit de valeurs discrètes. Mais si vous le considérez comme une ligne connectée, vous indiquez qu'il s'agit d'une séquence et que vous vous concentrez sur le changement. Tandis que si vous utilisez un lisseur à la place, vous vous concentrez sur la tendance à long terme.
Ainsi, même avec les mêmes données, il est possible de communiquer différentes informations en fonction de la façon dont vous les visualisez. Nous avons un choix de visualisations. Cela ne veut pas dire qu'on a raison et qu'on a tort. Ils communiquent chacun un message différent.
Q: Pourquoi certains graphiques sont-ils moins utiles que d'autres?
R: Ils peuvent être moins utiles car nous pouvons mettre trop de choses dans le graphique. Nous ajoutons des étiquettes, des graduations, des couleurs, des dimensions et celles-ci peuvent ne pas figurer dans les données. Ou même s’ils figurent dans les données, ils détournent parfois les informations que nous souhaitons communiquer.
Et l’autre moyen de les rendre moins utiles est de ne pas être en phase avec nos sens. Il y a certaines choses que nous pouvons percevoir avec plus de précision que d'autres. Il y a certaines choses que nous percevons catégoriquement plutôt que continuellement. Nous devons donc nous assurer d’aligner la perception visuelle catégorique sur les données catégorielles et la même chose pour la perception continue.
Jessica a écrit:
Merci pour votre commentaire. Les coefficients de corrélation sont tous d'environ 0,816. L'image montre la valeur RSquare, qui est le carré du coefficient de corrélation, pour les deux premiers ensembles de données. J'espère que cela pourra aider!
Michael Clayton a écrit:
Version abrégée de mon plaidoyer: les études de cas et les blogs devraient comporter davantage d'exemples de parcelles de variabilité qui, à mon avis, ne sont PAS des études comparatives. Ramirez est bon. Besoin de beaucoup plus et comparez-les avec des méthodes multivariées. Multi-Vari est toujours OFAT mais imbriqué ou croisé visuellement, et non multivarié.
Mais très utile comme premier regard sur les données brutes avec de nombreux facteurs à mon avis.
Michael Clayton a écrit:
JMP a réellement gâché la puissance du graphe de variabilité ou de variabilité sur les études de jauge uniquement.
J'adorerais un GRAPH BUILDER pouvant imbriquer ou croiser 4 ou 5 facteurs de la même manière graphique que le fameux graphe de variabllity USED HEAVILY dans l'industrie des semi-conducteurs pour SITE WITHIN WAFER DANS BEAUCOUP DANS UN PRODUIT DANS UNE FOND ... ...
Et nous aimons les nouveaux choix de Composants Variance plus récents, qui incluent REML et BAYES, ainsi que les anciennes mathématiques asymétriques anova.
S'il vous plaît débloquer la puissance de ce graphique de type Multi-Vari.
Il s’agit du PREMIER CHOIX pour la vérification des données de résultats DOE avant d’exécuter des régressions.
Il est également choisi pour l’EDA sur l’impact des outils et des recettes sur la métrologie ou les données de test.
Et commencez par regarder GRR avant d’utiliser EMP.
J'adore les nouveaux profileurs..et simulateurs.
Vous ne savez pas encore si JMP PRO est nécessaire pour la plupart des travaux en usine.
Peut utiliser certains exemples d’usine où JMP Pro vaut le coût le plus élevé.
Nous souhaitons également davantage de moyens de déplacer les profileurs vers Excel, etc. pour les gestionnaires autres que JMP.
Ed a écrit:
Il serait intéressant de voir les coefficients de corrélation correspondant au Quatuor d’Anscombe
