Per il calcio universitario, la stagione regolare sta volgendo al termine e in pochi giorni sapremo quali squadre stanno andando a giocare a bowl di fine stagione. Sebbene alcune assegnazioni di bowl siano determinate dalla formula, ogni bowl ha spesso la possibilità di scegliere tra diverse squadre da invitare al loro gioco. Alcune squadre hanno la reputazione di "viaggiare bene", nel senso che hanno una base di fan che può aumentare la partecipazione a partite lontane o per attirare un vasto pubblico televisivo. Ad esempio, considera questo post del blog commento per quanto riguarda Ohio State:
La nazione Buckeye che viaggia bene è un eufemismo. Siamo i migliori tifosi di football universitari itineranti della nazione.
Mi chiedevo se i numeri supportassero la reputazione e si proponessero di raccogliere dati sulle presenze e sui voti televisivi. Ho raccolto 11 anni di dati sui giochi di bocce, principalmente da bcsfootball.org con alcuni fori riempiti dai singoli siti Web delle bocce. Come spesso accade, la pulizia dei dati è stata un'impresa importante. Ho usato la funzione Recode in JMP per standardizzare i nomi delle squadre ("Connecticut" o "UConn") e i nomi delle bocce. I nomi delle scodelle sono particolarmente difficili in quanto i nomi attuali cambiano a volte nel corso degli anni, ea volte lo stesso nome è stato utilizzato per diverse ciotole (" Meineke Car Care Bowl "È un esempio). Ho usato il componente aggiuntivo Geocoder JMP per determinare le posizioni per calcolare le distanze di viaggio.
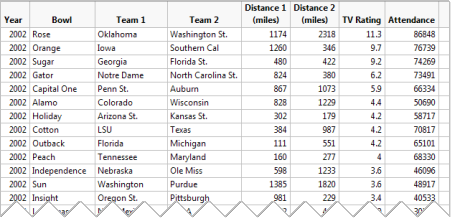
Più variabili sarebbero sicuramente utili, anche se spero che il contenitore stesso funga da proxy per variabili come classifica della squadra (dal momento che ogni ciotola si trova in una fessura abbastanza stabile nell'ordine di beccata della ciotola). Guardando i modelli che includono Anno , Ciotola , Anno * Bowl , Squadra e Distanza , risulta che le presenze e le valutazioni televisive si comportano in modo abbastanza diverso. Quasi tutto il Ciotola e Anno * Bowl le interazioni sono fortemente correlate con partecipazione , ma solo alcuni di essi sono correlati con Valutazione TV . Apparentemente, le valutazioni TV sono più probabilmente influenzate dalle squadre che stanno giocando. Distanza è un fattore relativamente debole nel complesso e non ci sono dati sufficienti per vedere come si applica ai singoli team.
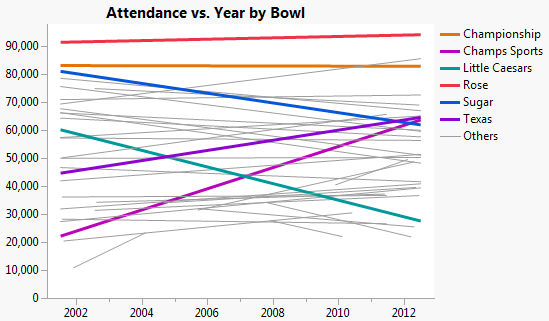
Le tendenze di presenza delle ciotole variano in base alla ciotola, con alcune scodelle che sono stabili, alcune di tendenza e alcune di tendenza verso il basso. Il grafico seguente mostra le linee di tendenza, con due di ogni categoria evidenziate.
Passando alle squadre, una complicazione di questi dati è che ce ne sono due Squadra colonne e quindi due valori di squadra per riga. L'impilamento delle colonne del team è possibile, ma si traduce in righe da un anno in più (riducendo artificialmente i loro valori p) e, soprattutto, dissocia i due gruppi avversari, quindi non possiamo più modellare la responsabilità condivisa per i risultati. Un approccio migliore consiste nel creare colonne di indicatori, una per squadra, in modo che esattamente due delle colonne non siano zero per ogni gioco. Ho trovato Tabella> Riepilogo con Squadra come sottogruppo per essere un modo conveniente per generare le colonne dell'indicatore.
Comprese le colonne degli indicatori con il Anno e Ciotola le colonne ci permettono di vedere l'effetto di ogni squadra dopo aver tenuto conto dell'effetto del Anno e Ciotola . Come accennato sopra, la partecipazione è modellata molto bene dalla combinazione di queste due variabili, e forse per questo motivo ci sono poche squadre con effetti di modello significativi. Qui ci sono quelli con i p-value più piccoli, ordinati in base al valore stimato. Le Hawaii sono una circostanza particolare dal momento che quella scuola spesso gioca nella Hawaii Bowl, e in generale la partecipazione alla Hawaii Bowl è molto più alta quando le Hawaii ci giocano.
|
| Termine |
|---|
| Stima |
|---|
| Prob> | t | |
|---|
|
| Hawaii |
| 10507 |
| 0,0148 |
|
| Ole Miss |
| 8445 |
| 0,0427 |
|
| Texas A & M |
| 6932 |
| 0,0405 |
|
| Alabama |
| 5803 |
| 0,0884 |
|
| Texas |
| 5308 |
| 0,0637 |
|
| Virginia dell'ovest |
| 5219 |
| 0,0758 |
|
| Florida St. |
| 4870 |
| 0,0904 |
|
| Georgia Tech |
| -5707 |
| 0,0752 |
|
| Pittsburgh |
| -5982 |
| 0,0896 |
|
| Florida del sud |
| -6770 |
| 0,0737 |
|
| Minnesota |
| -7393 |
| 0,0401 |
|
| Bowling Green |
| -8117 |
| 0,0716 |
|
| Toledo |
| -11.831 |
| 0,0302 |
Lo stesso modello per il Valutazione TV la risposta mostra risultati significativi per diverse scuole. I risultati migliori sono i seguenti. Tra le scuole con effetti negativi, nessuno ha un valore p significativo.
|
| Termine |
|---|
| Stima |
|---|
| Prob> | t | |
|---|
|
| Texas |
| 2.30 |
| <.0001 |
|
| Cal Sud |
| 1.83 |
| 0,0017 |
|
| Penn St. |
| 1.91 |
| 0,0021 |
|
| Oregon |
| 1.65 |
| 0,0046 |
|
| Ohio St. |
| 1.55 |
| 0.0073 |
|
| Michigan |
| 1.47 |
| 0,0074 |
|
| Florida St. |
| 1.37 |
| 0,0126 |
|
| Florida |
| 1.51 |
| 0,0130 |
|
| Notre Dame |
| 1.35 |
| 0,0164 |
|
| Nebraska |
| 1.32 |
| 0,0273 |
|
| Michigan St. |
| 1.30 |
| 0,0362 |
|
| Wisconsin |
| 1.23 |
| 0,0371 |
Ho salvato i report dei modelli completi come pagine HTML interattive nel caso in cui desideri esplorare i modelli o semplicemente vedere come la tua squadra ha segnato. Dai un'occhiata al partecipazione e Valutazione TV rapporti.
Un dettaglio che non ho menzionato è che ho escluso bocce e scuole con meno di quattro giochi (Sorry, Duke) per evitare singolarità nel modello, che ho trovato solo quando il modello non si adattava. Ulteriori esclusioni potrebbero anche migliorare il modello poiché la maggior parte dei termini ha avuto così poco significato ma le loro stime continuano a partecipare al modello finale. Le funzionalità di modellazione avanzate in JMP Pro possono eseguire automaticamente tale potatura, ed è questo lo sviluppatore statistico di JMP Clay Barker fatto quando ha analizzato questi dati. Ha usato regressione generalizzata , che cerca iterativamente termini da rimuovere in modo che i termini reali possano adattarsi a più dati. Clay ha anche combinato il partecipazione e Valutazione TV in un rapporto 1: 4 per produrre un singolo punteggio combinato. Di seguito sono le sue scuole superiori e inferiori. Un punteggio pari a zero significa che la squadra non ha partecipato al modello finale.
|
| Squadra |
|---|
| tv |
|---|
Punto| partecipazione |
|---|
Punto| Complessivamente |
|---|
Punto|
| Florida St. |
| 0.73 |
| 0.60 |
| 0,70 |
|
| Cal Sud |
| 0,78 |
| 0.00 |
| 0.63 |
|
| Texas |
| 0.71 |
| 0.00 |
| 0.57 |
|
| Ohio St. |
| 0.60 |
| 0,11 |
| 0.50 |
|
| Penn St. |
| 0.47 |
| 0,08 |
| 0.39 |
|
| Michigan |
| 0.40 |
| 0.16 |
| 0.35 |
|
| Notre Dame |
| 0,36 |
| 0.30 |
| 0.35 |
|
| Georgia |
| 0.42 |
| 0.00 |
| 0,34 |
|
| Florida |
| 0,27 |
| 0.00 |
| 0.22 |
|
| Miami (Fla.) |
| 0.20 |
| 0.00 |
| 0.16 |
|
| Virginia dell'ovest |
| 0.00 |
| 0.53 |
| 0,11 |
|
| Texas A & M |
| 0.00 |
| 0,33 |
| 0,07 |
|
| Iowa |
| 0.00 |
| 0.23 |
| 0.05 |
|
| Louisiana Lafayette |
| 0.00 |
| 0.23 |
| 0.05 |
|
| Tennessee |
| 0.00 |
| 0,19 |
| 0.04 |
|
| Carolina del Nord |
| 0.00 |
| 0,19 |
| 0.04 |
|
| Ole Miss |
| 0.00 |
| 0,17 |
| 0.03 |
|
| Florida International |
| 0.00 |
| -0.15 |
| -0.03 |
|
| Wyoming |
| 0.00 |
| -0.16 |
| -0.03 |
|
| Miss del Sud |
| 0.00 |
| -0.18 |
| -0.04 |
|
| Marshall |
| 0.00 |
| -0.21 |
| -0.04 |
|
| Colorado |
| 0.00 |
| -0.28 |
| -0.06 |
|
| Michigan occidentale |
| -0.08 |
| 0.00 |
| -0.07 |
|
| Siracusa |
| 0.00 |
| -0.34 |
| -0.07 |
|
| Kentucky occidentale |
| 0.00 |
| -0.40 |
| -0.08 |
|
| Illinois settentrionale |
| -0.22 |
| -0.11 |
| -0.20 |
Almeno, i fan dell'Ohio State dovrebbero essere meno arrabbiati con me, ora. 
Se vuoi esaminare i dettagli o provare un modello diverso, il file di dati è nello scambio di file JMP. (Il download richiede un profilo SAS gratuito.)
Paul Prew ha scritto:
Grazie, Xan, la conversione dei punteggi in vincita / perdita renderebbe questa analisi un modello standard di Bradley-Terry. Probabilmente andrò su quella strada. saluti, Paul
Xan Gregg ha scritto:
Ciao Paul, una differenza è che la frequenza è un punteggio aggiuntivo e la tua valutazione è una sottrattiva (basata sulla differenza dei due). Non sono uno statistico, quindi offrirò solo un paio di idee per le indagini. Potresti provare il metodo dell'indicatore con la fragranza vincente con 1 e la fragranza perdente con -1. Dovresti studiare i modelli di valutazioni sportive che valutano le squadre in base alla differenza di punteggio invece che alla frequenza. Naturalmente, è ancora necessario capire come convertire la bilancia in un numero continuo, altrimenti il trattamento è ordinario.
Paul Prew ha scritto:
Xan, in superficie, sembra che questa analisi possa contenere alcune risposte per un test sensoriale sulle fragranze con cui sto combattendo, perché entrambe implicano incontri diretti per determinare le valutazioni complessive di diversi livelli di fattore.
Lo studio sensoriale ha coinvolto 6 fragranze, per identificare se fossero state significativamente preferite. 40: alcuni panelisti hanno annusato un numero 1, quindi un profumo n. 2 (in cieco) e hanno assegnato una valutazione al processo.
9-pt. scala Likert
1: preferenza estrema per # 1 <== 5: nessuna preferenza ==> 9: preferenza estrema per # 2
Ha risuonato con me quando hai scritto che l'impilamento dei risultati 'dissocia le due squadre avversarie in modo che non possiamo più modellare la responsabilità condivisa per i risultati'. Qui è dove sono bloccato.
Le analogie che vedo sono
* panelist / anno
* fragranza # 1 vs # 2 / squadra # 1 vs # 2
* valutazione / partecipazione
La scala Likert usata per la valutazione delle preferenze pone l'ulteriore complicazione che mi impedisce di applicare direttamente la struttura variabile dell'indicatore.
Hai qualche suggerimento in cui l'analisi può essere inserita in JMP?
grazie, Paul
E l'analisi del tuo gioco di bocce mi sembra accurata e accurata. Le ciotole affiliate a Big Ten spesso scelgono altre squadre di Big Ten con record peggiori rispetto alla mia alma mater, l'Università del Minnesota, perché abbiamo una reputazione per essere viaggiatori poveri.
