Como analistas de datos, todos tratamos de hacer lo correcto. Cuando hay una opción de distribuciones estadísticas que se utilizarán para una aplicación determinada, es una inclinación natural tratar de encontrar la "mejor".
Pero cuidado...
La pesca para la mejor distribución puede llevarlo a una trampa. Solo porque una opción parece ser la mejor, ¡eso no significa que sea correcta! Por ejemplo, considere este conjunto de datos:
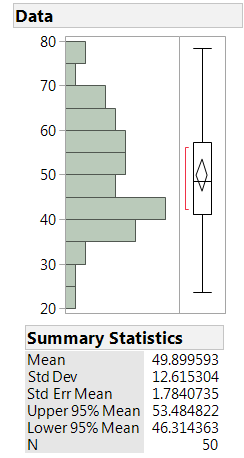 ¿Cuál es la mejor distribución que podemos usar para describir estos datos? JMP Puede ayudarnos a responder esta pregunta. Desde la plataforma de Distribución, podemos optar por ajustar una serie de distribuciones comunes a los datos: Normal, Weibull, Gamma, Exponential y otros. Para ajustar todas las distribuciones continuas posibles a estos datos en JMP, diríjase a la zona activa del triángulo rojo para esta variable en el informe de Distribución, y elija "Ajuste continuo> Todos". Aquí está el resultado:
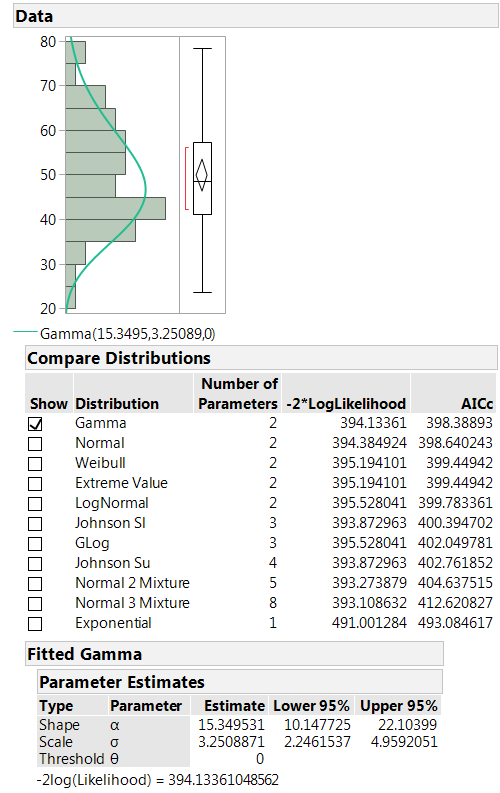 JMP ha comparado 11 distribuciones potenciales para estos datos y las clasificó de mejor (Gamma) a peor (Exponencial). La métrica utilizada para realizar el ranking es la corregida. Criterio de información de Akaike (AICc). Los valores más bajos de AICc indican un mejor ajuste, por lo que la distribución Gamma es la ganadora aquí.
Aquí está la trampa
Este conjunto de datos se generó extrayendo una muestra aleatoria de tamaño 50 de una población que normalmente se distribuye con una media de 50 y una desviación estándar de 10. La distribución normal es la respuesta correcta por definición, pero nuestra expedición de pesca nos dio un resultado engañoso.
¿Con qué frecuencia hay un desajuste como este? Una forma en que podemos abordar esta cuestión es a través de la simulación. Escribí un pequeño script JMP para extraer muestras de varios tamaños de una población distribuida normalmente. Investigué tamaños de muestra de 5, 10, 20, 30, 50, 75, 100, 250 y 500 observaciones; para cada uno de estos, dibujé 1,000 muestras independientes y tuve JMP que calculó el ajuste para todas las posibles distribuciones continuas. Por último, para cada muestra anoté el nombre de la distribución que mejor se ajusta, según lo medido por AICc. ( Script de JSL disponible en el intercambio de archivos JMP).
¡Los resultados fueron bastante sorprendentes!
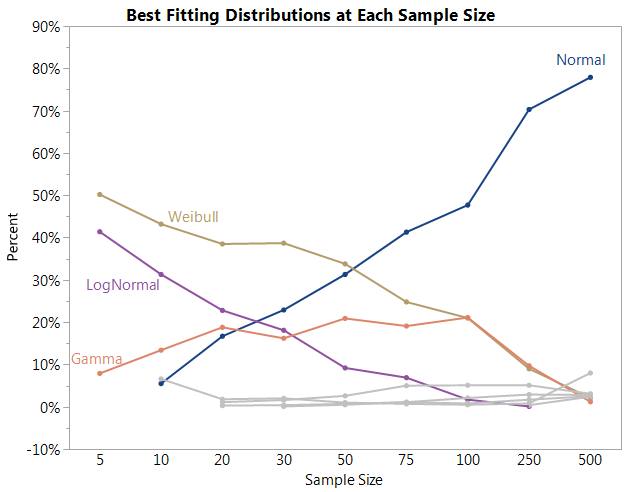
- Recuerde, la respuesta correcta en cada caso es "Normal". Si nuestra expedición de pesca estaba dando buenos resultados en todos los ámbitos, la línea para la distribución Normal debería ser alta y plana, flotando cerca del 100%.
- En cambio, la distribución incorrecta fue elegida con una frecuencia perturbadora. Para tamaños de muestra menores de 50, la distribución Normal ni siquiera fue la más comúnmente elegida. Ese honor pertenece a la distribución de Weibull.
- Para un tamaño de muestra de 5 observaciones de una distribución normal, la identificación correcta no se realizó una sola vez de 1,000 muestras.
- Si desea tener al menos un 50% de probabilidad de identificar correctamente los datos distribuidos normalmente con este método, ¡necesitará más de 100 observaciones!
- Incluso con un tamaño de muestra de 500 observaciones, la probabilidad de que la distribución normal se llame correctamente la mejor es de solo un 80%.
La moraleja de la historia
Al comparar el ajuste de diferentes distribuciones a un conjunto de datos, no asuma que la distribución con el AICc más pequeño es la correcta. Relativo Lo que cuenta son las magnitudes de las estadísticas AICc. Una regla de oro (utilizada en otras partes de JMP) es que los modelos cuyos valores de AICc están dentro de las 10 unidades de la "mejor" son aproximadamente equivalentes. * En nuestro primer ejemplo anterior, la distribución Gamma es nominalmente la mejor, pero su AICc es solo .2 unidades inferior a la de la distribución normal. No hay buena evidencia estadística para elegir el Gamma sobre el Normal.
En términos más generales, como práctica recomendada, es aconsejable considerar solo las distribuciones que tengan sentido en el contexto del problema. Su propio conocimiento y experiencia suelen ser las mejores guías. No elija una distribución exótica que tenga un mejor ajuste sobre una que tenga sentido y tenga un historial comprobado en su campo de trabajo.
* Esta regla se usa para comparar modelos creados en la personalidad de regresión generalizada de la plataforma Fit Model en JMP Pro. Ver Burnham, KP y anderson, dr (2002), Selección de modelo e inferencia multimodelo: un enfoque teórico de la información práctica . Springer, Nueva York.
Barry escribió:
IIRC, tanto los archivos PDF de Weibull como los de Gamma pueden ajustarse a una distribución normal con la elección correcta de los valores de los parámetros. Sin embargo, ambos también pueden acomodar el sesgo en el conjunto de datos, ya sea que la población tenga sesgo o no. Esto significa que los archivos PDF de Gamma y Weibull deberían ajustarse mejor a un conjunto de datos extraídos de una distribución normal mejor que la normal, hasta que el tamaño de la muestra sea tan grande que (a) el sesgo de la muestra sea insignificante y (b) (creo) que La curtosis se vuelve importante.
Jordan hiller escribió:
Gracias por tu comentario Rick. Estoy de acuerdo: la experiencia y la experiencia en la materia deberían conducir a una mejor respuesta que el dragado de distribución.
Rick Wicklin escribió:
Este es un cuento muy importante. Siempre aconsejo a los profesionales que consideren procesos plausibles de generación de datos antes de modelar, en lugar de adoptar un "enfoque de escopeta" en el que la computadora se adapta a muchos modelos y usted elige ciegamente el mejor AICC. Los datos casi normales son especialmente problemáticos porque la distribución normal es una distribución limitante para muchas distribuciones. Por ejemplo, dibuje una muestra aleatoria de una distribución Gamma (30); ¡Se ve normal!

