데이터 분석가로서, 우리 모두는 올바른 일을하려고합니다. 특정 애플리케이션에 사용할 통계 분포를 선택할 수있는 경우 "최상의"통계를 찾는 것이 좋습니다.
그러나 조심 ...
최고의 배급을 위해 낚시를하면 함정에 빠질 수 있습니다. 하나의 옵션이 가장 좋은 것으로 보이는 것만 큼 - 그것이 올바른 것을 의미하지는 않습니다! 예를 들어 다음 데이터 세트를 고려하십시오.
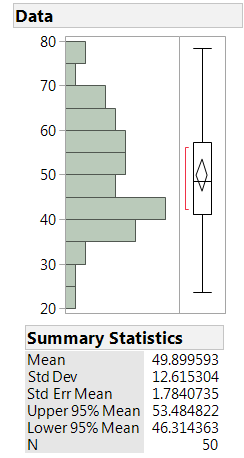 이 데이터를 설명하는 데 사용할 수있는 최상의 배포는 무엇입니까? JMP 이 질문에 대답하는 데 도움이 될 수 있습니다. 배포 플랫폼에서 일반 배포, Weibull, Gamma, Exponential 및 기타와 같은 일반적인 배포를 데이터에 맞게 선택할 수 있습니다. 가능한 모든 연속 분포를 JMP에서이 데이터에 맞추려면 분포 보고서에서이 변수의 빨간색 삼각형 핫스팟으로 이동하여 "연속 맞춤> 모두"를 선택하십시오. 결과는 다음과 같습니다.
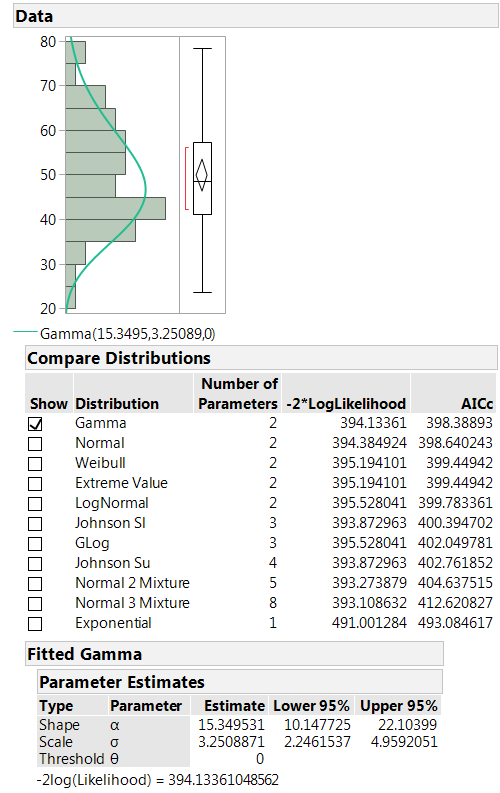 JMP는이 데이터에 대해 11 개의 잠재적 분포를 비교하고 최고 (감마)에서 최악 (지수)까지 평가했습니다. 순위를 수행하는 데 사용되는 측정 항목은 수정 된 것입니다. Akaike 정보 기준 (AICc). AICc 값이 낮을수록 적합도가 높으므로 감마 분포가 가장 좋습니다.
여기 캐치가있다.
이 데이터 세트는 50의 평균 및 10의 표준 편차로 정규 분포 된 모집단에서 크기 50의 무작위 표본을 추출하여 생성되었습니다. 정규 분포가 정의에 의한 정답이지만, 우리의 낚시 원정은 우리에게 오도 된 결과를주었습니다.
이런 불일치가 얼마나 자주 발생합니까? 이 질문에 접근 할 수있는 한 가지 방법은 시뮬레이션을 이용하는 것입니다. 나는 정상적으로 배포 된 인구에서 다양한 크기의 샘플을 그리기 위해 작은 JMP 스크립트를 작성했습니다. 나는 5, 10, 20, 30, 50, 75, 100, 250 및 500 관측 샘플 크기를 조사했다. 각각에 대해 1,000 개의 독립적 인 샘플을 작성하고 가능한 모든 연속 분포에 대해 JMP가 적합하도록 계산했습니다. 마지막으로 각 샘플에 대해 AICc에서 측정 한 가장 적합한 분포의 이름을 기록했습니다. ( JSL 스크립트 사용 가능 JMP 파일 교환에서).
결과는 아주 놀랍습니다!
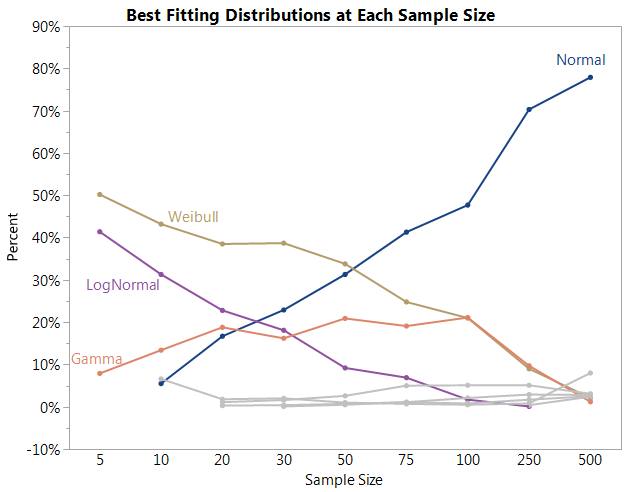
- 기억하십시오, 각각의 경우에 정답은 "정상"입니다. 우리의 낚시 원정대가 전반적으로 좋은 결과를 얻는다면, 정규 분포의 선은 높고 평평해야하며 100 %에 가깝습니다.
- 대신, 잘못된 분포가 방해 주파수로 선택되었습니다. 표본 크기가 50 미만인 경우 정규 분포는 가장 일반적으로 선택되지 않았습니다. 그 명예는와 이블 분포에 속합니다.
- 정규 분포에서의 5 회의 관측 샘플 크기의 경우, 1,000 샘플 중에서 한 번만 정확한 식별이 이루어지지 않았습니다.
- 이 방법으로 정상적으로 분포 된 데이터를 정확하게 식별 할 확률이 50 % 이상인 경우, 100 회 이상의 관측이 필요합니다!
- 500 회의 관측치의 표본 크기에서조차 정상 분포의 정확도가 최상이라고 불리는 확률은 약 80 %에 불과합니다.
이 이야기의 교훈
다른 분포의 적합도를 데이터 세트와 비교할 때 가장 작은 AICc를 갖는 분포가 올바른 것으로 가정하지 마십시오. 상대적인 AICc 통계의 크기가 중요합니다. 어림짐작 (JMP의 다른 곳에서 사용 된)은 AICc의 값이 "가장 좋은 것"의 10 단위 이내 인 모델입니다. * 위의 첫 번째 예제에서 감마 분포는 명목상 최고이지만 AICc는 .2 단위는 정규 분포보다 낮습니다. Gamma to the Normal을 선택하는 좋은 통계적 증거는 없습니다.
보다 일반적으로 문제의 맥락에서 의미가있는 배포 만 고려하는 것이 가장 좋습니다. 자신의 지식과 전문성이 일반적으로 최고의 가이드입니다. 귀하의 업무 분야에서 입증 된 실적을 보유하고 있으며 합리적인 가격보다 약간 더 적합한 이국적인 유통을 선택하지 마십시오.
*이 규칙은 JMP Pro의 Fit Model 플랫폼의 일반화 된 회귀 특성으로 작성된 모델을 비교하는 데 사용됩니다. Burnham, KP 참조 Anderson, DR (2002), 모델 선택과 다중 모델 추론 : 실제 정보 이론적 접근 . 스프링 어, 뉴욕.
배리 쓴 :
IIRC에서는 Weibull 및 Gamma pdf 모두 올바른 매개 변수 값을 선택하여 정규 분포에 적합합니다. 그러나 둘 다 인구가 왜곡되었는지 여부에 관계없이 데이터 세트의 왜곡을 조정할 수도 있습니다. 이것은 감마와와 이블 pdfs가 샘플 크기가 너무 커서 (a) 샘플 스큐가 무시할만큼 작고 (b) (나는 생각합니다) 보통 데이터 분포가 정규 분포보다 잘 잘 맞아야한다는 것을 의미합니다. 첨도가 중요해진다.
요르단 힐러 쓴 :
귀하의 코멘트 릭 주셔서 감사. 나는 동의한다 - 경험과 주제에 대한 전문 지식은 배설 준설보다 더 나은 답을 이끌어 내야한다.
릭 위클린 쓴 :
이것은 매우 중요한 교훈입니다. 컴퓨터가 많은 모델에 적합하고 맹목적으로 최적의 AICC를 선택하는 "샷건 접근 방식"을 채택하기보다는 실무자에게 모델링 전에 그럴듯한 데이터 생성 프로세스를 고려하도록 조언합니다. 정규 분포가 많은 분포에 대한 제한된 분포이기 때문에 거의 정상적인 데이터가 특히 문제가됩니다. 예를 들어, 감마 (30) 분포에서 무작위 샘플을 그립니다. 정상적으로 보입니다!

