Come analisti di dati, cerchiamo tutti di fare la cosa giusta. Quando esiste una scelta di distribuzioni statistiche da utilizzare per una determinata applicazione, è naturale provare a trovare quella "migliore".
Ma attenzione ...
Pescare per la migliore distribuzione può portarti in una trappola. Solo perché un'opzione sembra essere la migliore - questo non significa che sia corretta! Ad esempio, considera questo set di dati:
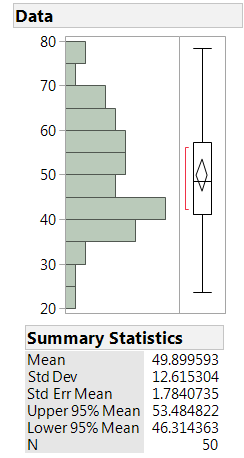 Qual è la migliore distribuzione che possiamo usare per descrivere questi dati? JMP può aiutarci a rispondere a questa domanda. Dalla piattaforma di distribuzione, possiamo scegliere di adattare una serie di distribuzioni comuni ai dati: normale, Weibull, gamma, esponenziale e altri. Per adattare tutte le possibili distribuzioni continue a questi dati in JMP, vai all'hotspot del triangolo rosso per questa variabile nel rapporto Distribuzione e scegli "Adatta continua> Tutto". Ecco il risultato:
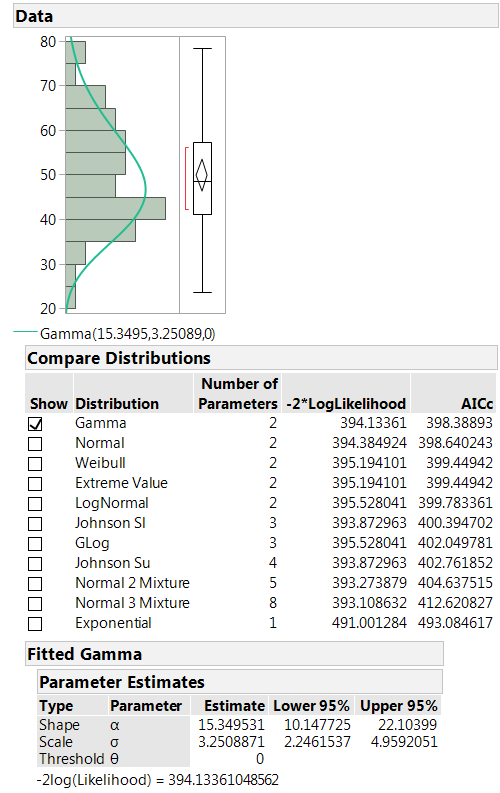 JMP ha confrontato 11 potenziali distribuzioni per questi dati e li ha classificati dal migliore (Gamma) al peggiore (esponenziale). La metrica utilizzata per eseguire la classifica è corretta Criterio informativo Akaike (AICC). Valori inferiori di AICc indicano un adattamento migliore, quindi la distribuzione Gamma è il vincitore qui.
Ecco il trucco
Questo set di dati è stato generato tracciando un campione casuale di dimensione 50 da una popolazione che è normalmente distribuita con una media di 50 e una deviazione standard di 10. La distribuzione normale è la risposta corretta per definizione, ma la nostra spedizione di pesca ci ha fornito risultati fuorvianti.
Quante volte c'è una discrepanza come questa? Un modo in cui possiamo affrontare questa domanda è attraverso la simulazione. Ho scritto un piccolo script JMP per disegnare campioni di varie dimensioni da una popolazione normalmente distribuita. Ho studiato le dimensioni del campione di 5, 10, 20, 30, 50, 75, 100, 250 e 500 osservazioni; per ognuna di esse ho estratto 1.000 campioni indipendenti e JMP ha calcolato l'adattamento per tutte le possibili distribuzioni continue. Infine, per ogni campione ho registrato il nome della distribuzione più adatta, misurata da AICc. ( Script JSL disponibile nello scambio di file JMP).
I risultati sono stati abbastanza sorprendenti!
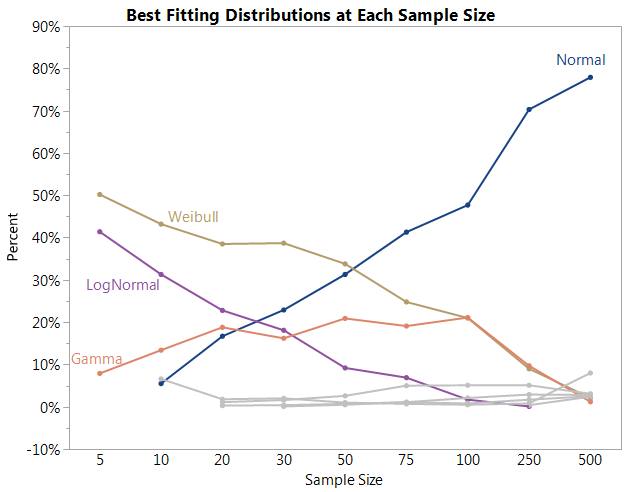
- Ricorda, la risposta corretta in ciascun caso è "Normale". Se la nostra spedizione di pesca ha prodotto buoni risultati su tutta la linea, la linea per la distribuzione normale dovrebbe essere alta e piatta, in bilico vicino al 100%.
- Invece, la distribuzione sbagliata è stata scelta con una frequenza disturbante. Per campioni di dimensioni inferiori a 50, la distribuzione normale non era nemmeno la più comunemente scelta. Questo onore appartiene alla distribuzione di Weibull.
- Per una dimensione campione di 5 osservazioni da una distribuzione normale, l'identificazione corretta non è stata effettuata una volta su 1.000 campioni.
- Se vuoi avere almeno il 50% di possibilità di identificare correttamente i dati distribuiti normalmente con questo metodo, avrai bisogno di più di 100 osservazioni!
- Anche con una dimensione del campione di 500 osservazioni, la probabilità che la distribuzione normale venga correttamente definita la migliore è solo dell'80% circa.
La morale della storia
Quando si confronta l'adattamento di diverse distribuzioni a un set di dati, non dare per scontato che la distribuzione con il più piccolo AICc sia quella corretta. Parente le grandezze delle statistiche AICc sono ciò che conta. Una regola empirica (usata altrove in JMP) è che i modelli i cui valori di AICc sono entro 10 unità del "migliore" sono approssimativamente equivalenti. * Nel nostro primo esempio sopra, la distribuzione Gamma è nominalmente la migliore, ma il suo AICc è solo .2 unità inferiori a quella della distribuzione normale. Non ci sono buone prove statistiche per scegliere la gamma oltre il normale.
Più in generale, come best practice è consigliabile considerare solo le distribuzioni che hanno senso nel contesto del problema. Le tue conoscenze e competenze sono di solito le migliori guide. Non scegliere una distribuzione esotica che abbia un adattamento leggermente migliore rispetto a una che abbia un senso e abbia una comprovata esperienza nel tuo campo di lavoro.
* Questa regola viene utilizzata per confrontare i modelli creati nella personalità della regressione generalizzata della piattaforma Fit Model in JMP Pro. Vedi Burnham, KP e Anderson, DR (2002), Selezione del modello e inferenza multimodale: un approccio teorico alle informazioni pratiche . Springer, New York.
Jordan Hiller ha scritto:
Punto eccellente!
Barry ha scritto:
IIRC, entrambi i pdf di Weibull e Gamma possono adattarsi a una distribuzione normale con la giusta scelta dei valori dei parametri. Tuttavia, entrambi possono anche contenere l'inclinazione nel set di dati, indipendentemente dal fatto che la popolazione abbia o meno obliquità. Ciò significa che i pdf Gamma e Weibull dovrebbero adattarsi meglio a un set di dati tratto da una distribuzione normale migliore del normale, fino a quando la dimensione del campione è così grande che (a) l'inclinazione del campione è trascurabile e (b) (penso) che il la curtosi diventa importante.
Jordan Hiller ha scritto:
Grazie per il tuo commento Rick. Sono d'accordo: esperienza e esperienza in materia dovrebbero portare a una risposta migliore rispetto al dragaggio della distribuzione.
Rick Wicklin ha scritto:
Questo è un racconto molto importante. Consiglio sempre ai professionisti di considerare i processi di generazione dei dati plausibili prima della modellazione, piuttosto che adottare un "approccio shotgun" in cui il computer si adatta a molti modelli e si sceglie ciecamente il migliore AICC. I dati quasi normali sono particolarmente problematici perché la distribuzione normale è una distribuzione limitante per molte distribuzioni. Ad esempio, disegnare un campione casuale da una distribuzione Gamma (30); sembra normale!

