Als Datenanalysten versuchen wir alle, das Richtige zu tun. Wenn es eine Auswahl statistischer Verteilungen gibt, die für eine bestimmte Anwendung verwendet werden sollen, ist es eine natürliche Neigung, zu versuchen, die „beste“ zu finden.
Aber Vorsicht...
Das Fischen nach der besten Verteilung kann Sie in eine Falle führen. Nur weil eine Option die beste zu sein scheint, heißt das nicht, dass sie richtig ist! Betrachten Sie zum Beispiel diesen Datensatz:
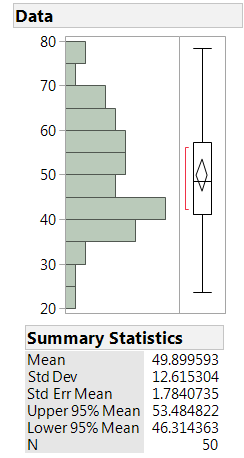 Mit welcher Verteilung können wir diese Daten am besten beschreiben? JMP kann uns helfen, diese Frage zu beantworten. Von der Distributionsplattform aus können wir eine Anzahl allgemeiner Distributionen an die Daten anpassen: Normal, Weibull, Gamma, Exponential und andere. Um alle möglichen kontinuierlichen Verteilungen an diese Daten in JMP anzupassen, wechseln Sie im Verteilungsbericht zum Hotspot für das rote Dreieck dieser Variablen und wählen Sie "Continuous Fit> All". Hier ist das Ergebnis:
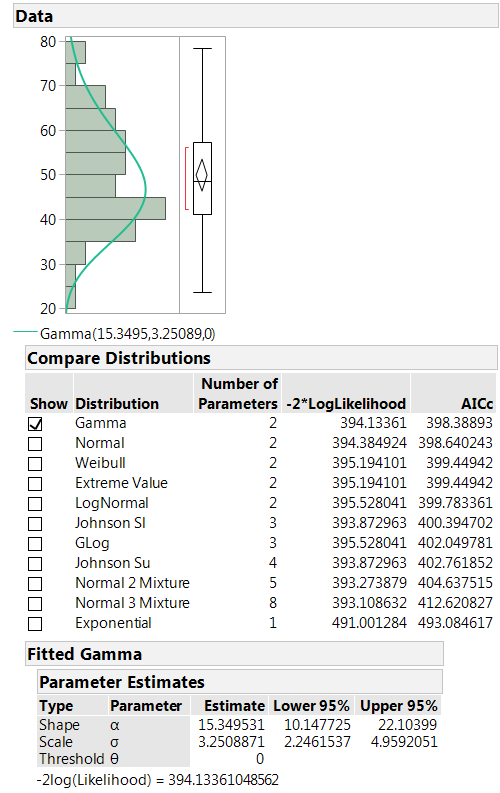 JMP hat 11 potenzielle Verteilungen für diese Daten verglichen und sie nach besten (Gamma) bis schlechtesten (Exponential) bewertet. Die zur Durchführung des Rankings verwendete Metrik ist die korrigierte Akaike Informationskriterium (AICc). Niedrigere AICc-Werte zeigen eine bessere Anpassung an, so dass die Gamma-Verteilung hier der Gewinner ist.
Hier ist der Haken
Dieser Datensatz wurde durch Entnahme einer Zufallsstichprobe der Größe 50 aus einer normal verteilten Grundgesamtheit mit einem Mittelwert von 50 und einer Standardabweichung von 10 erstellt. Die Normalverteilung ist per Definition die richtige Antwort, aber unsere Angelexpedition brachte uns ein irreführendes Ergebnis.
Wie oft gibt es ein solches Missverhältnis? Eine Möglichkeit, diese Frage anzugehen, ist die Simulation. Ich habe ein kleines JMP-Skript geschrieben, um aus einer normal verteilten Grundgesamtheit Proben verschiedener Größen zu ziehen. Ich untersuchte Probengrößen von 5, 10, 20, 30, 50, 75, 100, 250 und 500 Beobachtungen; Für jede dieser Proben habe ich 1.000 unabhängige Stichproben gezogen und die Anpassung durch JMP für alle möglichen kontinuierlichen Verteilungen berechnen lassen. Zuletzt habe ich für jede Probe den Namen der am besten passenden Verteilung gemessen, wie von AICc gemessen. ( JSL-Skript verfügbar im JMP-Dateiaustausch).
Die Ergebnisse waren ziemlich überraschend!
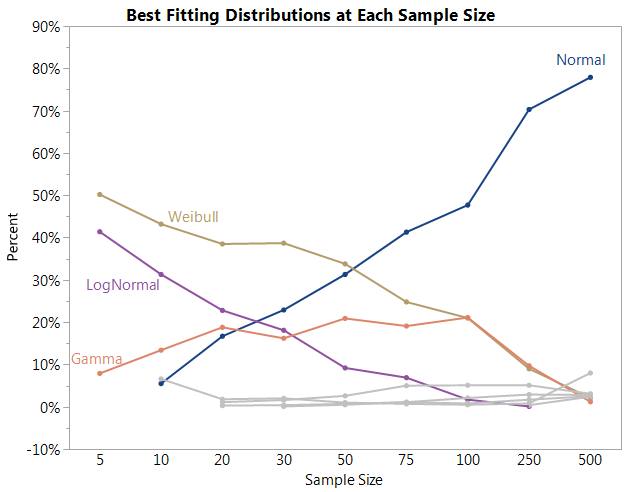
- Denken Sie daran, dass die richtige Antwort jeweils „Normal“ ist. Wenn unsere Angelexpedition auf der ganzen Linie gute Ergebnisse lieferte, sollte die Linie für die Normalverteilung hoch und flach sein und nahe bei 100% liegen.
- Stattdessen wurde die falsche Verteilung mit einer störenden Häufigkeit gewählt. Bei Stichprobengrößen unter 50 war die Normalverteilung nicht einmal die am häufigsten gewählte. Diese Ehre gehört zur Weibull-Verteilung.
- Bei einer Stichprobengröße von 5 Beobachtungen aus einer Normalverteilung wurde nicht aus 1.000 Stichproben die richtige Identifizierung vorgenommen.
- Wenn Sie eine mindestens 50% ige Chance haben möchten, normal verteilte Daten mit dieser Methode richtig zu identifizieren, benötigen Sie mehr als 100 Beobachtungen!
- Selbst bei einer Stichprobengröße von 500 Beobachtungen liegt die Wahrscheinlichkeit, dass die Normalverteilung korrekt als die beste bezeichnet wird, bei nur etwa 80%.
Die Moral der Geschichte
Gehen Sie beim Vergleich der Anpassung verschiedener Verteilungen mit einem Datensatz nicht davon aus, dass die Verteilung mit dem kleinsten AICc die richtige ist. Relativ Größenordnungen der AICc-Statistik zählen. Eine Faustregel (an anderer Stelle in JMP verwendet) lautet, dass Modelle, deren AICc-Werte innerhalb von 10 Einheiten der „besten“ liegen, in etwa gleichwertig sind. * In unserem ersten Beispiel oben ist die Gamma-Verteilung nominell die beste, aber ihre AICc-Zahl nur 0,2 Einheiten niedriger als die der Normalverteilung. Es gibt keine guten statistischen Beweise, um das Gamma über dem Normalwert zu wählen.
Allgemein betrachtet ist es sinnvoll, nur Verteilungen zu berücksichtigen, die im Zusammenhang mit dem Problem sinnvoll sind. Ihr eigenes Wissen und Know-how sind in der Regel die besten Anleitungen. Wählen Sie keine exotische Distribution, die etwas besser passt als eine, die Sinn macht und in Ihrem Arbeitsbereich nachweisbar ist.
* Diese Regel wird verwendet, um Modelle zu vergleichen, die in der Generalized Regression-Persönlichkeit der Fit Model-Plattform in JMP Pro erstellt wurden. Siehe Burnham, KP und Anderson, DR (2002) Modellauswahl und Multimodel-Inferenz: Ein theoretischer Ansatz für praktische Informationen . Springer, New York.
Barry schrieb:
Bei IIRC können sowohl die Weibull- als auch die Gamma-pdfs mit der richtigen Auswahl der Parameterwerte in eine Normalverteilung passen. Beide können jedoch auch den Versatz des Datensatzes berücksichtigen, unabhängig davon, ob die Bevölkerung einen Versatz aufweist oder nicht. Dies bedeutet, dass die Gamma- und Weibull-pdfs besser zu einem aus einer Normalverteilung gezogenen Datensatz passen sollten als die Normalgröße, bis die Stichprobengröße so groß ist, dass (a) der Stichprobenversatz vernachlässigbar ist und (b) (ich denke) die Kurtosis wird wichtig.
Jordan Hiller schrieb:
Danke für deinen Kommentar, Rick. Ich stimme zu - Erfahrung und Fachwissen sollten zu einer besseren Antwort führen als Verteilungsbaggerungen.
Rick Wicklin schrieb:
Dies ist eine sehr wichtige Warnung. Ich empfehle Praktikern immer, vor dem Modellieren plausible Datenerzeugungsprozesse in Betracht zu ziehen, anstatt einen "Shotgun-Ansatz" zu wählen, bei dem der Computer für viele Modelle geeignet ist und Sie blind die beste AICC wählen. Nahezu normale Daten sind besonders problematisch, da die Normalverteilung für viele Verteilungen eine begrenzende Verteilung darstellt. Ziehen Sie beispielsweise eine Zufallsstichprobe aus einer Gamma (30) -Verteilung; es sieht normal aus!

