En tant qu’analystes de données, nous essayons tous de faire ce qui est bien. Lorsqu'il existe un choix de distributions statistiques à utiliser pour une application donnée, il est tout à fait naturel de chercher la "meilleure".
Mais méfiez-vous...
La pêche pour la meilleure distribution peut vous mener à un piège. Ce n’est pas parce qu’une option semble être la meilleure - que cela n’est pas correct! Par exemple, considérons cet ensemble de données:
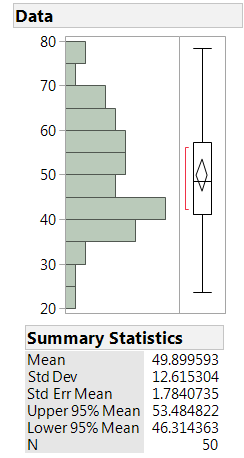 Quelle est la meilleure distribution que nous pouvons utiliser pour décrire ces données? JMP peut nous aider à répondre à cette question. À partir de la plate-forme Distribution, nous pouvons choisir d’adapter un certain nombre de distributions courantes aux données: Normal, Weibull, Gamma, Exponential et d’autres. Pour adapter toutes les distributions continues possibles à ces données dans JMP, accédez au hotspot triangle rouge correspondant à cette variable dans le rapport de distribution, puis choisissez «Ajustement continu> Tout». Voici le résultat:
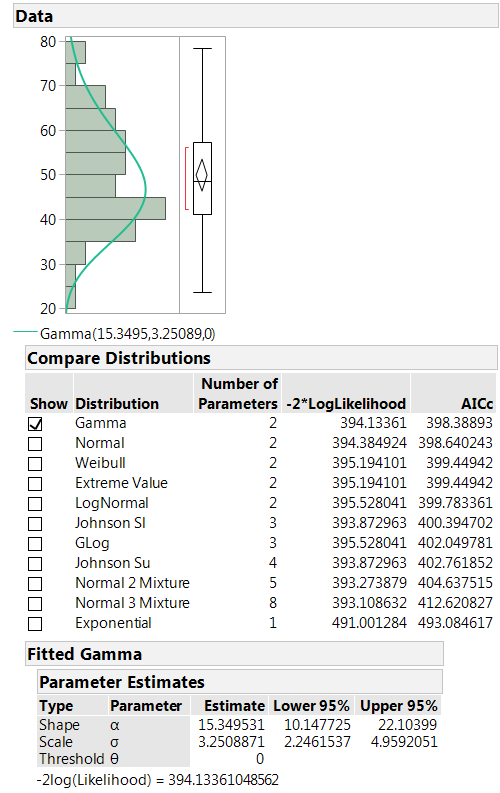 JMP a comparé 11 distributions potentielles pour ces données et les a classées du meilleur (Gamma) au pire (Exponentiel). La métrique utilisée pour effectuer le classement est la valeur corrigée. Critère d'information Akaike (AICc). Les valeurs inférieures de AICc indiquent un meilleur ajustement et la distribution Gamma est donc le gagnant ici.
Voici la prise
Cet ensemble de données a été généré en tirant un échantillon aléatoire de taille 50 d’une population normalement répartie avec une moyenne de 50 et un écart type de 10. La distribution normale est la bonne réponse par définition, mais notre expédition de pêche nous a donné un résultat trompeur.
Combien de fois y a-t-il un décalage tel que celui-ci? Une des manières d’aborder cette question est de simuler. J'ai écrit un petit script JMP pour dessiner des échantillons de différentes tailles à partir d'une population normalement distribuée. J'ai étudié des échantillons de tailles différentes (5, 10, 20, 30, 50, 75, 100, 250 et 500). pour chacun de ceux-ci, j'ai tiré 1 000 échantillons indépendants et JMP a calculé l'adéquation pour toutes les distributions continues possibles. Enfin, pour chaque échantillon, j'ai enregistré le nom de la distribution la mieux ajustée, telle que mesurée par AICc. ( Script JSL disponible dans l’échange de fichiers JMP).
Les résultats ont été assez surprenants!
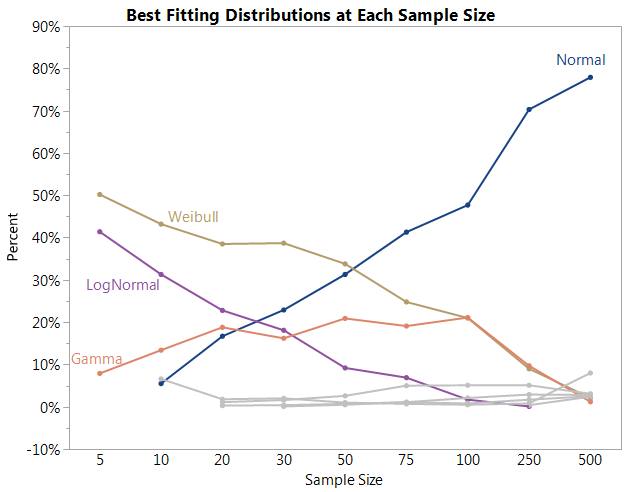
- Rappelez-vous que la réponse correcte dans chaque cas est «Normal». Si notre expédition de pêche donnait de bons résultats dans l’ensemble, la ligne de répartition de la normale devrait être haute et plate et osciller autour de 100%.
- Au lieu de cela, la mauvaise distribution a été choisie avec une fréquence perturbante. Pour les échantillons de moins de 50 ans, la distribution normale n'était même pas la plus couramment choisie. Cet honneur appartient à la distribution Weibull.
- Pour un échantillon de 5 observations d'une distribution normale, l'identification correcte n'a pas été effectuée une seule fois sur 1 000 échantillons.
- Si vous voulez avoir au moins 50% de chances d'identifier correctement les données normalement distribuées par cette méthode, vous aurez besoin de plus de 100 observations!
- Même avec un échantillon de 500 observations, la probabilité que la distribution normale soit correctement appelée meilleure n’est que d’environ 80%.
La morale de l'histoire
Lors de la comparaison de l'ajustement de différentes distributions à un ensemble de données, ne supposez pas que la distribution avec le plus petit AICc est la bonne. Relatif Ce sont les grandeurs des statistiques AICc. Une règle de base (utilisée ailleurs dans JMP) est que les modèles dont les valeurs de AICc sont comprises dans les 10 unités de la «meilleure» unité sont à peu près équivalents. * Dans notre premier exemple, la distribution Gamma est théoriquement la meilleure, mais sa seulement 0,2 unité inférieure à celle de la distribution normale. Les statistiques ne permettent pas de choisir le gamma plutôt que la normale.
Plus généralement, en tant que meilleure pratique, il est sage de ne prendre en compte que les distributions qui ont un sens dans le contexte du problème. Vos propres connaissances et compétences sont généralement les meilleurs guides. Ne choisissez pas une distribution exotique qui correspond légèrement mieux à une distribution qui a du sens et qui a fait ses preuves dans votre domaine de travail.
* Cette règle permet de comparer les modèles construits dans la personnalité de régression généralisée de la plate-forme Fit Model dans JMP Pro. Voir Burnham, KP et Anderson, DR (2002), Sélection de modèles et inférence multimodèle: une approche théorique de l'information théorique . Springer, New York.
Barry a écrit:
IIRC, les fichiers PDF Weibull et Gamma peuvent s’adapter à une distribution normale avec le bon choix de valeurs de paramètre. Cependant, les deux peuvent également prendre en compte l'inclinaison de l'ensemble de données, que la population soit asymétrique ou non. Cela signifie que les fichiers PDF Gamma et Weibull devraient correspondre mieux à un ensemble de données issu d’une distribution normale que la normale, jusqu’à ce que la taille de l’échantillon soit telle que (a) le biais de l’échantillon soit négligeable et (b) (je pense) que le kurtosis devient important.
Jordan Hiller a écrit:
Merci pour votre commentaire Rick. Je conviens que l’expérience et l’expertise en la matière devraient donner une meilleure réponse que le dragage de distribution.
Rick Wicklin a écrit:
C'est un récit édifiant très important. Je conseille toujours aux praticiens de considérer les processus de génération de données plausibles avant la modélisation, plutôt que d'adopter une "approche simpliste" dans laquelle l'ordinateur convient à de nombreux modèles et vous choisissez à l'aveuglette le meilleur AICC. Les données presque normales sont particulièrement problématiques car la distribution normale est une distribution limitante pour de nombreuses distributions. Par exemple, dessinez un échantillon aléatoire d'une distribution Gamma (30); ça a l'air normal!

