作為數據分析師,我們都試圖做正確的事情。當可以選擇用於給定應用的統計分佈時,嘗試找到“最佳”應用程序是一種自然的傾向。
但要注意......
釣魚以獲得最佳分佈可能會讓您陷入困境。僅僅因為一個選項似乎是最好的 - 這並不意味著它是正確的!例如,考慮以下數據集:
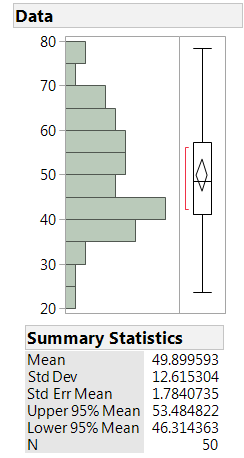 我們可以用來描述這些數據的最佳分佈是什麼? JMP 可以幫助我們回答這個問題。在分佈平台上,我們可以選擇為數據擬合多種常見分佈:Normal,Weibull,Gamma,Exponential等。要在JMP中將所有可能的連續分佈擬合到此數據,請在分佈報告中轉到此變量的紅色三角形熱點,然後選擇“連續擬合>全部”。結果如下:
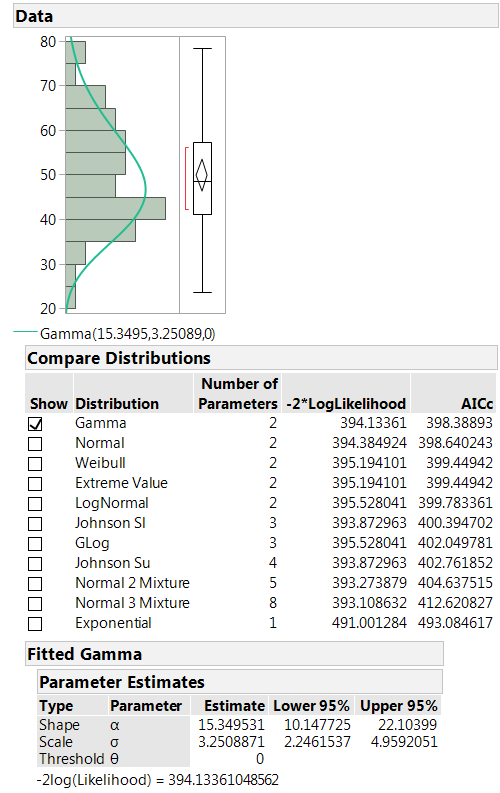 JMP比較了這些數據的11個潛在分佈,並將它們從最佳(Gamma)到最差(指數)進行排名。用於執行排名的指標已更正 Akaike信息標準 (AICC)。較低的AICc值表示更好的擬合,因此Gamma分佈在這裡是贏家。
這是捕獲
該數據集是通過從通常分佈為平均值為50且標準偏差為10的總體中抽取大小為50的隨機樣本而生成的。根據定義,正態分佈是正確的答案,但我們的釣魚探險給我們帶來了誤導性的結果。
這種不匹配的頻率是多少?我們可以通過模擬來解決這個問題的一種方法。我寫了一個小的JMP腳本來從正態分佈的人群中抽取各種大小的樣本。我研究了5,10,20,30,50,75,100,250和500個觀測樣本的大小;對於這些中的每一個,我繪製了1,000個獨立樣本,並使JMP計算出適合所有可能的連續分佈。最後,對於每個樣本,我記錄了AICc測量的最佳擬合分佈的名稱。( JSL腳本可用在JMP文件交換中)。
結果非常令人驚訝!
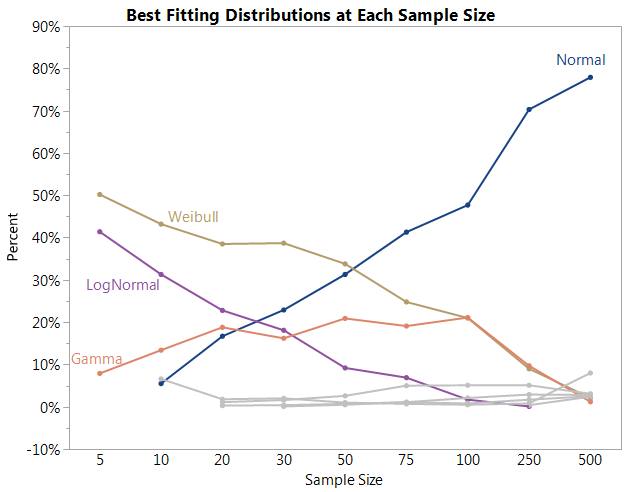
- 請記住,每種情況下的正確答案都是“正常”。如果我們的釣魚考察全面取得良好結果,那麼正態分佈的線應高而平,徘徊在100%附近。
- 相反,選擇錯誤的分佈是令人不安的頻率。對於50以下的樣本量,正態分佈甚至不是最常選擇的。這個榮譽屬於威布爾分佈。
- 對於來自正態分佈的5個觀察樣本大小,在1,000個樣本中沒有進行正確的識別。
- 如果您希望通過此方法至少有50%的機會正確識別正態分佈的數據,則需要超過100個觀測值!
- 即使在500個觀察樣本量的情況下,正態分佈被正確稱為最佳的可能性僅為約80%。
這個故事的主旨
比較不同分佈與數據集的擬合時,不要假設具有最小AICc的分佈是正確的。相對的 AICc統計數據的大小是重要的。經驗法則(在JMP的其他地方使用)是AICc的值在“最佳”值的10個單位內的模型大致相等。*在上面的第一個例子中,Gamma分佈名義上是最好的,但它的AICc是僅比正態分佈低.2個單位。沒有很好的統計證據來選擇Gamma超過法線。
更一般地說,作為最佳實踐,僅考慮在問題的上下文中有意義的分佈是明智的。您自己的知識和專業知識通常是最好的指南。不要選擇具有更好的貼合度的異域分佈,而不是那種有意義並且在您的工作領域具有良好記錄的分佈。
*此規則用於比較JMP Pro中Fit模型平台的廣義回歸個性中構建的模型。見Burnham,KP 和安德森,DR (2002年),模型選擇與多模態推理:一種實用的信息理論方法 。斯普林格,紐約。
巴里中寫道:
IIRC,Weibull和Gamma pdf都可以通過正確選擇參數值來擬合正態分佈。但是,無論人口是否有偏差,它們都可以適應數據集中的偏差。這意味著Gamma和Weibull pdf應該比正常分佈更好地擬合從正態分佈中得到的數據集,直到樣本量太大以至於(a)樣本偏差可以忽略不計並且(b)(我認為)峰度變得重要。
喬丹希勒中寫道:
感謝您對Rick的評論。我同意 - 經驗和主題專業知識應該導致比分配疏通更好的答案。
里克威克林中寫道:
這是一個非常重要的警示故事。我總是建議從業者在建模之前考慮合理的數據生成過程,而不是採用“霰彈槍方法”,其中計算機適合許多模型,你盲目地選擇最好的AICC。幾乎正常的數據尤其成問題,因為正態分佈是許多分佈的限制分佈。例如,從Gamma(30)分佈中抽取隨機樣本;看起來很正常!

