실험은 실험 과정에서 반응에서 선형 표류를 경험하는 시간 순서로 실행되는 것이 일반적입니다. 런의 순서를 무작위로 정하면이 드리프트의 효과는 추정 된 요소 효과에 편향되는 경향이 없지만 이러한 효과의 분산을 증가시킵니다.
무작위로 실행하는 것보다 더 나은 선택이 있습니까?
일반적으로 연구자에게 실행 순서를 무작위로 정하거나 균질 그룹의 실행 그룹 내에서 순서를 무작위로 지정하는 것이 좋습니다. 그러나 요인 변화와 상관없이 시간이 지남에 따라 반응이 강하게 선형화되는 추세를 의심 할만한 이유가있는 경우 진행할 수있는 더 좋은 방법이 있습니다.
이 더 좋은 방법은 무엇입니까?
이전 포스트에서, 공변량 인자를 실험에 추가하는 방법을 설명했습니다. 이 경우 시간 (또는 순서를 달리 함)을 공변량 요소로 간주 할 수 있습니다. 트렌드에 맞는 강력한 디자인을 만들려면 하나의 열이있는 데이터 테이블을 만들어야합니다. 당신은 그것을 "주문"이라고 부를 수 있습니다. 이 예제를 구체적으로 만들기 위해 16 회 실험을 만듭니다. 따라서 공변량 계수 인 Order의 내 데이터 테이블에는 1에서 16까지의 숫자가있는 16 개의 행이 있습니다. 내 테이블을 저장하고 Order.jmp라고 부릅니다.
그런 다음 사용자 지정 디자이너를 열고 Order를 공변량 요소로 추가합니다. 예를 들어, 7 개의 연속 요소를 추가하고 A부터 G까지 호출합니다. 그림 1은 요소를 입력 한 후 사용자 지정 디자인 인터페이스를 보여줍니다. 가정 된 모델에는 모든 요인의 주 효과가 포함됩니다.
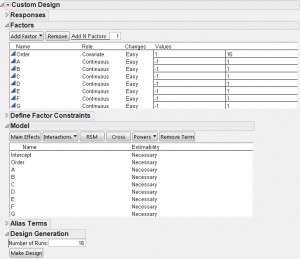
가장 효율적인 디자인을 원합니다. 그래서 빨간색 삼각형 메뉴로 가서 시작 수를 선택합니다. 이 선택은 설계자가 무작위로 시작한 설계에서 시작하여 가능한 최상의 설계를 찾으려고 시도하는 횟수를 제어합니다. 나는 랩톱에서 33 초가 걸리는 무작위 시작을 100,000 번 선택했습니다.
그림 2는 내가 만든 디자인의 상관 관계 칼라 맵을 보여줍니다. 인자 A 내지 G는 서로 직교한다. 순서는 A, B, E 및 F와 직교합니다. C, D 및 G와 상관 관계가 있지만 상관 관계는 0.0271에 불과합니다. 이러한 상관 관계는 관련 주 효과에 대해 0.1 % 미만의 분산 팽창을 초래합니다.
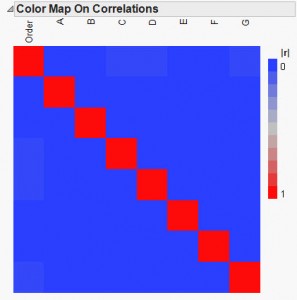
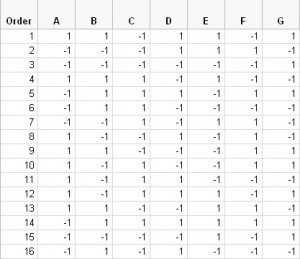
표 2는 각 실행에 대한 실행 순서 및 요인 설정을 보여줍니다.
결론
이 예제에서와 같이 요인 효과에 거의 직각이되도록 실행 순서를 만들 수있는 것은 아닙니다. 그러나 Run Order 열과 디자인의 다른 열과의 실질적인 상관 관계가있는 경우에도 데이터의 분석에서 요인으로 실행 순서를 포함하여 선형 추세 효과를 설명하고 다른 요인 효과를 정확하게 예측할 수 있습니다 .