実験を時系列で実行すると、実験の過程で応答に線形ドリフトが発生することはごく一般的です。実行の順序をランダム化すると、このドリフトの影響は推定された因子効果に偏りがちにはなりませんが、それらの効果の分散が大きくなります。
ランダムな実行順序よりも良い選択はありますか?
私はたいてい捜査官に彼らのランの順番をランダムにするか、あるいは少なくともランの均一なグループ(ブロック)内で順番をランダムにするように勧めます。しかし、要因の変化とは無関係に、経時的な応答の強い線形の傾向を疑う理由がある場合は、次に進むほうが良い方法があります。
これは何が良い方法ですか?
前回の投稿で、共変量因子を実験に追加する方法について説明しました。この場合、時間(または実行順序)を共変量因子と見なすことができます。デザインをトレンドに強くするには、まず1つの列を持つデータテーブルを作成します。あなたはそれを「注文」と呼ぶことができます。この例を具体的にするために、16回実行する実験を作成します。それで、共変量因子Orderの私のデータテーブルは、順番に1から16までの数字で16行を持ちます。テーブルを保存してOrder.jmpという名前を付けます。
次に、カスタムデザイナを開き、共変量要素として注文を追加します。例として、7つの連続係数を追加し、それらをAからGと呼びます。図1は、係数を入力した後のカスタムデザインインターフェイスを示しています。仮定モデルには、すべての要因の主な影響が含まれています。
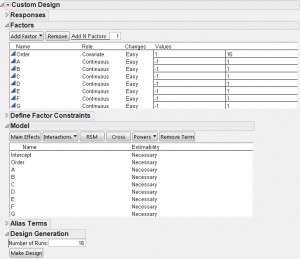
最も効率的なデザインを可能にしたいので、赤い三角形のメニューに行き、Number of Starts項目を選択します。この選択は、設計者が可能な限り最良のデザインを見つけようとするためにランダムな開始デザインから開始する回数を制御します。私は自分のラップトップで33秒かかった10万のランダムスタートを選びます。
図2は、私が作成したデザインの相関カラーマップを示しています。係数AからGは互いに直交しています。次数はA、B、E、およびFと直交しています。これはC、D、およびGと相関関係がありますが、相関関係は0.0271にすぎません。これらの相関関係は、関連する主な影響について0.1%未満の分散インフレをもたらします。
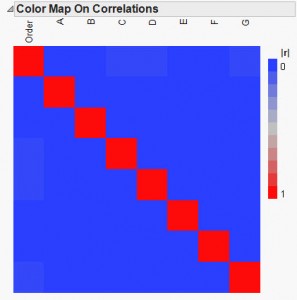
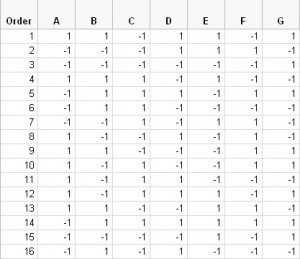
表2に、各実行の実行順序と係数の設定を示します。
ボトムライン
この例のように、実行順序を因数効果とそれほど直交するようにすることは必ずしも可能ではありません。ただし、データ分析の要因としてRun Orderを含む、Run Order列と設計内の他の列との間に実質的な相関関係がある場合でも、線形傾向の影響を説明し、その他の要因の影響を正確に推定できます。