È abbastanza comune che gli esperimenti eseguiti in una sequenza temporale conducano una deriva lineare nella risposta nel corso dell'esperimento. Se si randomizza l'ordine delle esecuzioni, l'effetto di questa deriva non tenderà a distorcere gli effetti del fattore stimato, ma aumenterà la varianza di tali effetti.
C'è una scelta migliore rispetto all'ordine di esecuzione casuale?
Di solito consiglierei agli investigatori di randomizzare l'ordine delle loro esecuzioni o almeno di randomizzare l'ordine all'interno di gruppi omogenei di esecuzioni (blocchi). Tuttavia, se c'è motivo di sospettare una tendenza fortemente lineare nella risposta nel tempo indipendentemente dal cambiamento dei fattori, allora c'è un modo migliore di procedere.
Qual è questo modo migliore?
In un post precedente, ho descritto come aggiungere fattori covariati a un esperimento. In questo caso, si potrebbe considerare il tempo (o l'ordine di esecuzione) come fattore di covariata. Per rendere il design più robusto, iniziare creando una tabella di dati con una colonna. Potresti chiamarlo "Ordine". Per rendere questo esempio specifico, creerò un esperimento a 16 fasi. Quindi la mia tabella di dati per il fattore covariate, Ordine, ha 16 righe con i numeri da 1 a 16 in ordine. Salvo il mio tavolo e lo chiamo Order.jmp.
Successivamente, apro Custom Designer e aggiungo Order come fattore di covariata. Ad esempio, aggiungo anche sette fattori continui e li chiamo da A a G. La Figura 1 mostra l'interfaccia di progettazione personalizzata dopo aver inserito i fattori. Il modello assunto contiene gli effetti principali di tutti i fattori.
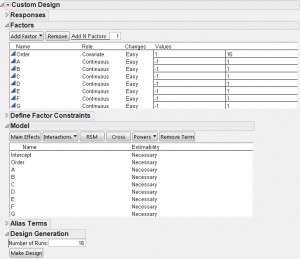
Voglio il design più efficiente possibile, quindi vado al menu del triangolo rosso e scelgo la voce Numero di Starts. Questa scelta controlla il numero di volte che il progettista inizia da un progetto di partenza casuale per cercare di trovare il miglior design possibile. Scelgo 100.000 partenze casuali, che impiegano 33 secondi sul mio laptop.
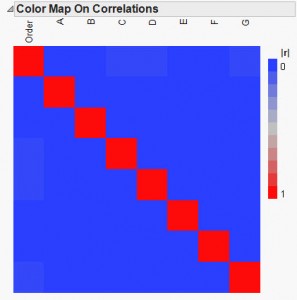
La Figura 2 mostra la mappa dei colori di correlazione del disegno che ho creato. I fattori da A a G sono ortogonali tra loro. L'ordine è ortogonale a A, B, E e F. È correlato a C, D e G, ma la correlazione è solo 0,0271. Queste correlazioni portano a una variazione dell'inflazione inferiore allo 0,1% per i principali effetti associati.
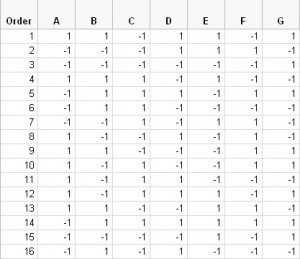
La Tabella 2 mostra l'ordine di esecuzione e le impostazioni dei fattori per ciascuna corsa.
Linea di fondo
Non è sempre possibile rendere l'ordine di esecuzione così quasi ortogonale agli effetti fattoriali come in questo esempio. Tuttavia, anche se vi sono correlazioni più sostanziali tra la colonna Ordine di esecuzione e altre colonne nel progetto, incluso Ordine di esecuzione come fattore nell'analisi degli account di dati per qualsiasi effetto di tendenza lineare e consente la stima precisa degli altri effetti del fattore .