Es ist ziemlich üblich, dass Experimente, die in einer Zeitsequenz ablaufen, im Verlauf des Experiments eine lineare Drift in der Antwort erfahren. Wenn Sie die Reihenfolge der Läufe randomisieren, neigen die Auswirkungen dieser Drift nicht dazu, die geschätzten Faktoren zu beeinflussen, erhöhen jedoch die Varianz dieser Effekte.
Gibt es eine bessere Wahl als eine zufällige Reihenfolge?
In der Regel würde ich Ermittlern empfehlen, die Reihenfolge ihrer Läufe zufällig oder zumindest innerhalb homogener Gruppen von Läufen (Blöcken) zufällig zu ordnen. Wenn jedoch Grund zu der Annahme besteht, dass unabhängig von den Faktoränderungen ein stark linearer Trend in der Antwort über die Zeit besteht, gibt es eine bessere Vorgehensweise.
Was ist der bessere Weg?
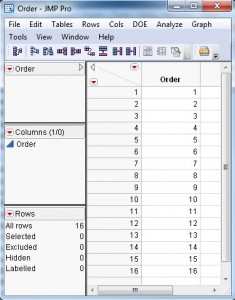
In einem früheren Beitrag habe ich beschrieben, wie man einem Experiment kovariate Faktoren hinzufügt. In diesem Fall könnte man die Zeit (oder die Ausführungsreihenfolge) als einen kovarianten Faktor betrachten. Um ein Design robust für den Trend zu machen, erstellen Sie zunächst eine Datentabelle mit einer Spalte. Man könnte es "Ordnung" nennen. Um dieses Beispiel spezifisch zu machen, werde ich ein Experiment mit 16 Durchläufen erstellen. Meine Datentabelle für den Kovariaten-Faktor Ordnung hat also 16 Zeilen mit den Nummern 1 bis 16 in der Reihenfolge. Ich speichere meine Tabelle und nenne sie Order.jmp.
Als nächstes öffne ich den benutzerdefinierten Designer und füge Ordnung als Kovariatsfaktor hinzu. Für das Beispiel füge ich auch sieben kontinuierliche Faktoren hinzu und nenne sie A bis G. Abbildung 1 zeigt die Benutzeroberfläche für das benutzerdefinierte Design nach Eingabe der Faktoren. Das angenommene Modell enthält die Haupteffekte aller Faktoren.
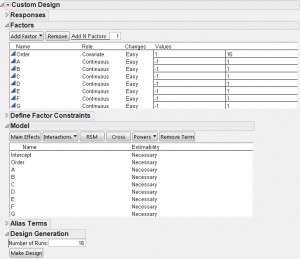
Ich möchte ein möglichst effizientes Design, also gehe ich zum roten Dreieck-Menü und wähle den Eintrag Anzahl der Starts. Diese Auswahl steuert, wie oft der Designer von einem zufälligen Startdesign startet, um das bestmögliche Design zu finden. Ich wähle 100.000 zufällige Starts, was auf meinem Laptop 33 Sekunden dauerte.
Abbildung 2 zeigt die Korrelationsfarbkarte des von mir erstellten Designs. Die Faktoren A bis G sind orthogonal zueinander. Die Reihenfolge ist orthogonal zu A, B, E und F. Sie ist mit C, D und G korreliert, aber die Korrelation beträgt nur 0,0271. Diese Korrelationen führen zu einer Varianzinflation von weniger als 0,1% für die damit verbundenen Haupteffekte.
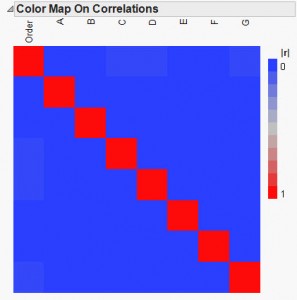
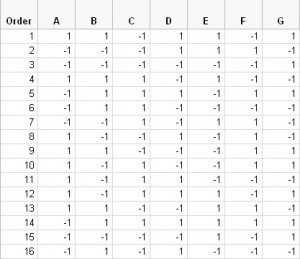
Tabelle 2 zeigt die Laufreihenfolge- und Faktoreinstellungen für jeden Lauf.
Endeffekt
Es ist nicht immer möglich, die Laufreihenfolge so nah an den Faktoreffekten wie in diesem Beispiel zu halten. Auch wenn die Korrelation zwischen der Spalte "Laufreihenfolge" und anderen Spalten des Entwurfs erheblich ist, berücksichtigt die Reihenfolge der Laufreihenfolge als Faktor bei der Analyse der Daten jeden linearen Trendeffekt und ermöglicht eine genaue Abschätzung der anderen Einflussfaktoren .