以時間順序運行的實驗經歷在實驗過程中的響應中的線性漂移是相當普遍的。如果你隨機化運行的順序,那麼這種漂移的影響不會偏向估計的因子效應,但它會增加這些效應的方差。
有沒有比隨機運行訂單更好的選擇?
我通常會建議調查人員將他們的運行順序隨機化,或者至少在同類運行組(塊)中隨機化順序。但是,如果有理由懷疑響應隨時間呈現強烈線性趨勢,而與因子變化無關,則有更好的方法可以繼續。
這有什麼好辦法?
在之前的文章中,我描述瞭如何在實驗中添加協變量因子。在這種情況下,可以將時間(或運行順序)視為協變量因子。要使設計對趨勢具有魯棒性,請首先創建一個包含一列的數據表。你可以稱之為“訂單”。為了使這個例子具體,我將創建一個16個運行的實驗。因此,我的協變量因子Order的數據表有16行,順序為1到16。我保存我的表並稱之為Order.jmp。
接下來,我打開自定義設計器並將Order添加為協變量因子。例如,我還添加了七個連續因子,並將它們稱為A到G.圖1顯示了輸入因子後的自定義設計界面。假設模型包含所有因素的主要影響。
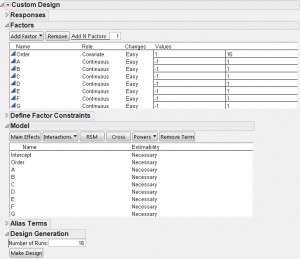
我想要最有效的設計,所以我轉到紅色三角形菜單並選擇Number of Starts項目。此選項控制設計者從隨機起始設計開始嘗試找到最佳設計的次數。我選擇100,000次隨機啟動,在筆記本電腦上花了33秒。
圖2顯示了我創建的設計的相關顏色圖。因子A至G彼此正交。順序與A,B,E和F正交。它與C,D和G相關,但相關性僅為0.0271。這些相關性導致相關主效應的方差膨脹小於0.1%。
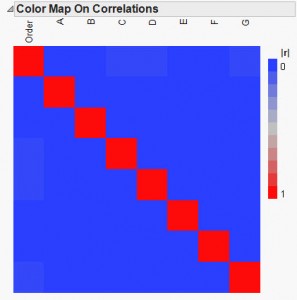
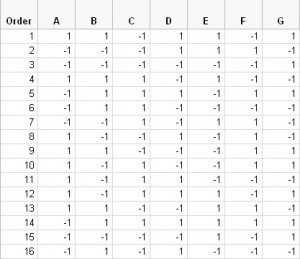
表2顯示了每次運行的運行順序和因子設置。
底線
並不總是能使運行順序與因子效應幾乎正交,如本例所示。但是,即使運行順序列與設計中的其他列之間存在更多實質性相關性,包括運行順序作為分析任何線性趨勢效應的數據帳戶的因素,並允許精確估計其他因素效應。