Im Folgenden finden Sie eine Fallstudie zur Verwendung des JSL-Debugger zur Lösung eines Problems. Dies basiert auf einem echten Skript mit dem angegebenen Problem. Wenn Sie das Problem im Kontext sehen möchten, habe ich ein Skript erstellt, das vom Original stark vereinfacht wurde und das Problem aufzeigt. Wenn Sie "mitspielen" möchten, können Sie es herunterladen DebuggerDemo-SolvingProblems.jsl aus dem JMP File Exchange (kostenloses SAS-Profil zum Herunterladen erforderlich).
Obwohl ich das ursprüngliche Skript beschreibe, stammen die Codeausschnitte und die Bilder alle aus diesem Beispielskript. Folgen!
Das Problem
Neulich wurde ein JSL-Scripter, der ein Problem mit einem Skript hatte, um Hilfe gebeten. Ihr Skript lief gut in Englisch, aber ein Tester, der ihr Skript in vereinfachtem Chinesisch abspielte, bekam Fehler.
Das Problem schien in der Art und Weise zu liegen, wie Strings auf Englisch und Chinesisch gehandhabt wurden: \! " ) wurden ausgelassen.
In englischer Sprache hier ein Beispielstring, der konstruiert wurde:
"dt << Select Where (dt: Zahlen == 45 & dt: Wählen Sie Strings == \!" South \! ")"
Auf Chinesisch sah die Zeichenfolge so aus:
"dt << Select Where (dt: Numbers == 45 und dt: Pick Strings == South)"
Beachten Sie die fehlenden \! "... \!" um Süden , was zu Fehlern führte, wenn die Zeichenfolge analysiert wurde und der nicht notierte Wert nicht aufgelöst werden konnte.
Gab es einen Fehler in JMP beim Umgang mit Anführungszeichen innerhalb von Zeichenfolgen in anderen Sprachen als Englisch?
Erster Blick
Sie schickte mir das Skript und die Daten, die zur Ausführung benötigt wurden. Das Skript hatte knapp 900 Zeilen und produzierte einen interaktiven Bericht. Die ersten 130 Zeilen wurden eingerichtet, die Zeilen 131-886 definierten Ausdrücke, und der Rest des Skripts verwendete diese Ausdrücke.
Als erstes habe ich das Skript auf Englisch und dann auf Chinesisch ausgeführt, um zu sehen, ob ich das gleiche Problem hatte. Ich tat. Dann habe ich es auf Französisch ausgeführt, was bestätigt hat, dass das Problem bei allen nicht-englischen Sprachen lag, nicht nur bei Chinesisch. Ich habe die restlichen Tests in Englisch und Französisch durchgeführt, weil Französisch für mich einfacher zu lesen ist als Chinesisch.
SPITZE: Es ist einfach, die Sprache, in der Sie JMP ausführen, unter Windows zu wechseln. Wählen Sie Datei> Voreinstellungen und wählen Sie die Windows-spezifische Kategorie. Wählen Sie oben unter Anzeigesprache eine Sprache aus. Beenden Sie auf einem Macintosh zunächst JMP und öffnen Sie dann die Systemeinstellungen (im Apple-Menü), und wählen Sie die Kategorie Sprache und Text aus. Ziehen Sie eine neue Sprache an den Anfang der Liste. Schließ das Fenster nicht! Es legt die Sprache für Ihren Computer fest. Starten Sie JMP und es wird in der ersten Sprache in der Liste ausgeführt. Wenn Sie fertig sind, beenden Sie JMP und ziehen Sie Englisch (oder die Sprache, die Sie normalerweise auf Ihrem Computer verwenden) nach oben. Jetzt können Sie das Systemeinstellungen-Fenster schließen.
Es gab mehrere Zeilen, aus denen die Zeichenfolge oben aufgebaut war, und sie waren alle auf eine ziemlich komplexe Codierung angewiesen, die es schwierig und zeitaufwendig gewesen wäre, Zeile für Zeile auszuführen, mehrere Ausdrücke einzugeben und zu verlassen und zu verstehen, was ich mir anschaute.
Wenn Sie nur die entsprechenden Zeilen zum Erstellen von Strings ausführen (nachdem das Skript einmal ausgeführt wurde, um alle diese Variablen zu initialisieren), wurden in allen Sprachen dieselben Ergebnisse erzielt, wobei die Escape-Anführungszeichen korrekt verwendet wurden. In den Zeilen, aus denen die Zeichenfolge bestand, wurden jedoch Werte aus zwei Datentabellen und eine dritte aus den ersten beiden verwendet. Auf einen Blick war es sehr schwer zu erkennen, wo alle verwendeten Variablen erstellt und gefüllt wurden.
Mit anderen Worten, dies war ein Job für den JSL-Debugger!
Geben Sie den JSL-Debugger ein
Ich führte JMP auf Englisch aus, öffnete das Skript und klickte auf Debug. Da ich das Skript bereits ausgeführt hatte, wurden alle Variablen unter Globals aufgeführt. Und es gab viele von ihnen - zu viele, um sie zu verfolgen, als ich durch das Skript ging. (Ich hätte das auch beim Laufen erfahren können Globale anzeigen () und beobachten, wie das Protokoll sehr lange wächst.)
Das war alles, was ich sofort wissen musste, also habe ich den JSL-Debugger beendet, JMP beendet und JMP neu gestartet, so dass meine Umgebung jetzt völlig sauber ist. Ich habe das Skript geöffnet und den Debugger erneut gestartet.
Ich interessierte mich nur für die Zeichenfolge, die gerade erstellt wurde, und fügte diese Variable meiner Überwachungsliste hinzu. Dazu habe ich die Variable im Skript wie im JSL-Debugger angezeigt ausgewählt, mit der rechten Maustaste darauf geklickt und Watch hinzufügen hinzugefügt.
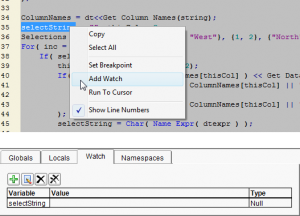
Ich habe einen Haltepunkt in der ersten Zeile hinzugefügt, nachdem der Setup-Abschnitt abgeschlossen war (Zeile 131 im Original; Zeile 34 in meinem Beispiel), und einen weiteren an der ersten "echten" Befehlszeile, nachdem alle Ausdrücke erstellt wurden (Zeile 887 im Original; das existiert in meinem Beispiel nicht). Dazu habe ich im Skript im Debugger neben der Zeilennummer geklickt.
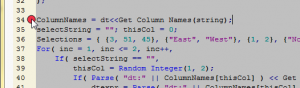
SPITZE: Ein Haltepunkt funktioniert nur, wenn Sie ihn an einer Zeile platzieren, die eine Aktion ausführt. Ein Haltepunkt in einer leeren Zeile, eine Zeile, die nur eine geschlossene Klammer enthält, oder eine auskommentierte Zeile wird ignoriert.
Ich habe den ersten "setup" -Abschnitt ausgeführt und sah, dass meine String-Variable noch nicht erstellt wurde. Das habe ich mit einem Klick gelernt - viel schneller, als ich das Skript manuell zeilenweise ausführen müsste!
Ich lief den zweiten Teil, der einfach alle Ausdrücke erstellte.
Nun war es Zeit zu handeln.
Das "Fleisch" des Skripts war in nur 10 Zeilen am Ende des Originalskripts enthalten. Der erste Teil war eine Schleife, die einige Ausdrücke aufrief (die Ausdrücke aufriefen, die Ausdrücke aufriefen usw.). Ich habe die Step-In-Schaltfläche verwendet, um in jeden Ausdruck zu gelangen und herauszufinden, was passiert.
SPITZE: Step Over verwenden, wenn ein Ausdruck, eine benutzerdefinierte Funktion oder Umfassen () aufgerufen werden, führt diesen Code vollständig aus, gibt sein Ergebnis zurück und platziert den Ausführungspunkt in der nächsten Zeile. Wenn Sie nicht Zeile für Zeile Schritt für Schritt vorgehen müssen, können Sie schnell überspringen, was Sie nicht benötigen. Auf der anderen Seite müssen Sie manchmal genau sehen, was der Ausdruck, die Funktion oder das enthaltene Skript tun. Verwenden Sie stattdessen "Step Into", und Sie können diesen Code zeilenweise durchlaufen.
Ergebnisse
Was ich entdeckte, war, dass jedes Stück der Saite aus einem Stück gebaut wurde Ob () Ausdruck: Wenn die Spalte mit den Informationen ein Zeichen war, wurde der Wert in Anführungszeichen gesetzt. Andernfalls wurde der Wert nicht angegeben.
Das bedeutete auch, dass ich von fast 900 Zeilen Code eigentlich nur an einem kleinen Stück von 19 Zeilen interessiert war (was trotzdem von den anderen 800+ abhing). Diese Zeilen werden in den Zeilen 38 - 54 in meinem Beispiel neu erstellt (und vereinfacht).
Ich habe JMP so geändert, dass es auf Französisch läuft, beendet und neu gestartet wurde und den Debugger erneut durchlaufen hat.
Plötzlich war alles klar ...
JMP ist lokalisiert! (Wer wusste?)
Das Problem bestand nicht bei den Zuweisungen, aus denen die Zeichenfolge bestand. Das Problem, das ich sofort mit dem Debugger sah, ist, dass auf Französisch der Zustand innerhalb der Ob () Ausdruck, der bestimmt, ob die Spalte ein Zeichen war, das die Spalte war nicht Charakter. Bei Zeichenspalten führte das Skript auf Französisch einen anderen Codepunkt aus als auf Englisch.
In der Tat würde die Bedingung auf Französisch immer wieder zurückkehren 0 . Das Zustandsstück der Ob () Ausdruck ist dies (Zeilen 40 und 48 in meinem Beispiel):
Parse ( "dt:" || ColumnNames [ thisCol ] ) << Datentyp abrufen () == "Charakter"
Auf Englisch, col << Datentyp abrufen () kehrt zurück "Charakter" für eine Charakterspalte. Auf Französisch kehrt es zurück "Caractère" , die niemals gleichwertig sein wird "Charakter" .
col << Datentyp abrufen () Gibt immer eine lokalisierte Antwort zurück.
Da war die betreffende Kolumne nie als gleich bestimmt "Charakter" Bei der Ausführung in Chinesisch (oder Französisch oder einer anderen Sprache als Englisch, die von JMP unterstützt wird) wurde die Zeichenfolge so erstellt, als wäre der Zellenwert numerisch. Aus diesem Grund hatte die englische Zeichenfolge Anführungszeichen und die chinesische Zeichenfolge keine Anführungszeichen.
Hinweis: Obwohl der JSL-Debugger nicht die Ergebnisse von anzeigt << Datentyp abrufen () message - nur das Ergebnis des Vergleichs - Ich konnte den Debugger problemlos beenden und auswählen und ausführen Parse ( "dt:" || ColumnNames [ thisCol ] ) << Datentyp abrufen () um zu sehen, was tatsächlich zurückgegeben wurde. Der Debugger ermöglichte es mir, das Problem schnell und schmerzlos zu finden.
Aufruf zum Handeln
Es gibt keinen Fehler in JMP: Dies funktioniert wie vorgesehen. Das Skript benötigt nur eine kleine Änderung, um in jeder Sprache zu arbeiten.
Es gibt mehr als einen Ansatz, um das Skript für mehrere Sprachen benutzerfreundlich zu machen. Was würden Sie tun? Ich werde den Ansatz in ein oder zwei Wochen zu den Kommentaren hinzufügen.
