데이터 분석을하는 사람은 데이터 정리에 많은 시간을 할애하는 것이 일반적입니다. 실제 데이터는 더러운 데이터입니다. 자동 수집 도구를 사용하는 경우에도 오류, 예외 및 불일치는 여전히 데이터에 반영됩니다.
다음 몇 블로그 게시물을 통해 데이터 무결성을 향상시키는 몇 가지 간단한 기술을 보여 드리고자합니다. 내가 무엇을 찾고, 어떻게 사용하는지에 대해 이야기 할 것입니다. JMP . 대부분의 경우 JMP에는 작업을 수행하는 데 필요한 모든 기능이 있습니다. 몇 가지 경우에는 정리 작업을 돕기 위해 스크립트를 작성했습니다. 이 스크립트를 JMP 사용자 커뮤니티 .
데이터 정리를 컨텍스트에 넣으려면 문제가 발생할 수있는 세 가지 일반적인 장소를 고려하십시오. 문제가 발생할 수있는 첫 번째 단계는 데이터 세트를 작성하는 것입니다. 누락 된 구분 기호, 일치하지 않는 열 이름 및 동기화되지 않은 시간 스탬프는 데이터 액세스, 연결 및 결합을 어렵게 만듭니다. 데이터가 JMP 데이터 세트에 있으면 다른 일련의 문제가 발생합니다. 잘못된 데이터 또는 모델링 유형, 값이없는 열, 오류 코드 및 맞춤법이 틀린 값이 일반적입니다. 마지막으로 분석 프로세스에서 이상 치를 제거하거나 열을 변환하거나 변수 수준을 집계해야 할 수도 있습니다.
위에서 언급 한 두 번째 영역 인 가운데에서 시작해 봅시다. 데이터 세트를 만들었지 만 분석하기 전에 정리해야합니다. 나는 이것이 당신이 당신의 문제의 대부분을 만날 곳이라고 생각합니다. 먼저 불필요한 열을 제거하고 데이터와 모델링 유형을 올바르게 수정하는 데 초점을 맞 춥니 다. 이 중 많은 부분을 칼럼 뷰어만으로 수행 할 수 있습니다.
설명하기 위해 미국 환경 보호국 웹 사이트에서 다운로드 한 데이터를 사용합니다. 자동차 연비 . 7 개의 별도 Excel 워크 시트 (데이터 세트의 각 연도마다 하나씩)가 다운로드되고 연결되었습니다. 찾을 수 있습니다. 자료 JMP 사용자 커뮤니티에서.
우리가 할 수있는 첫 번째 일은 거의 정보없이 변수를 제거하는 것입니다. 모든 값이 같은 (또는 누락 된) 열은 이상적인 후보입니다. 칼럼 뷰어 사용하기 (Cols 메뉴 아래) :
선택을 취소하여 범주 형 값만 필터링합니다. 마디 없는 . (이것은 모든 플랫폼 대화 상자에서 찾을 수있는 동일한 열 편집기입니다.)모든 열을 선택하고 클릭하십시오. 요약보기 .아래 표에서 마우스 오른쪽 버튼을 클릭하십시오. 요약 통계 선택하고 열로 정렬 ... 고르다 N 카테고리 그리고 오름차순 요약 테이블에서 선택한 컬럼은 상위 데이터 테이블에서 동시에 선택됩니다. 이렇게하면 작업을 수행하기 전에 특정 속성으로 열을 미리 선택할 수 있으므로 여러 열 작업이 더 쉬워집니다.
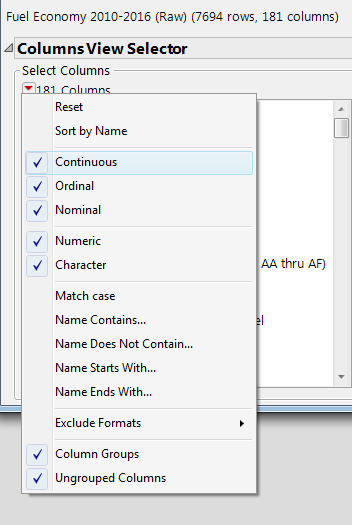
그림 1. Columns Viewer 필터는 특정 속성을 가진 데이터 테이블 열을 빠르게 식별하는 데 사용할 수 있습니다.
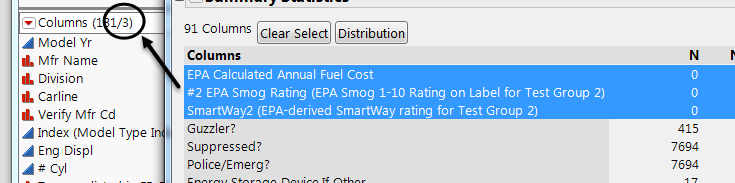
그림 2. Columns Viewer 요약 창에서 선택한 열도 데이터 테이블에서 선택됩니다.
맨 위의 세 열은 모두 누락 된 값을 가지며 제거 될 수 있습니다. 선택한 후에는 Cols> 열 삭제 데이터 테이블에서 제거 할 것입니다. 삭제 된 열은 요약 테이블에서 제거되지 않으므로 재실행하는 것이 좋습니다. 요약보기 (모든 열을 다시 선택해야 함). 이전 요약 표를 제거하여 보고서를 정리할 수 있습니다 ( 요약 통계 표제).
다음 10 개의 열은 하나의 값만 갖습니다. 이들을 지키기위한 결정은 그들이 가지고있는 누락 된 가치의 비율과 그 신분이 추가 정보를 제공한다고 생각하는지 여부에 달려 있습니다. 두 개의 열, 억제? 과 경찰 / 이머전? 누락 된 값이 없으므로 (즉, 모든 행이 동일하므로) 안전하게 제거 할 수 있습니다. 나머지 8 개 열 중 7 개가 대부분 누락되어 (> 99.997 %) 제거 할 수있는 좋은 후보가 될 수 있습니다. 나머지 열 목구멍가? 누락되지 않은 약 5 %가 있으며 유지할 가치가 있습니다. (나는 어떤 컬럼도 여러 컬럼으로 분리 된 변수의 일부라고 가정하지 않을 것이다. 나중에이 상황을 찾아 수정하는 방법에 대해 이야기하겠습니다.)
위의 단일 카테고리 예에서 대부분의 데이터가 누락되었습니다. 그러나 대부분의 데이터가 잘못된 것이 아니라면 비슷한 인수를 사용하여 열 제거시기를 정당화 할 수 있습니다. 한 열이 하나의 값으로 구성되었지만 누락 된 값의 비율이 충분히 큰 경우 열을 유지하는 것이 좋습니다. 그 가치가없는 부분이 당신에게 뭔가를 말하고있을 수도 있습니다.
또한 누락 정도가 높은 다중 카테고리 열을 제거 할 수 있습니다. 이렇게하려면 요약 테이블을 마우스 오른쪽 단추로 클릭하고 정렬하십시오. N 없음 . 확인하지 마라. 오름차순 상자는 이번에는 값이 거의없는 열만 고려하기 때문에 이 열은 둘 이상의 범주가 있으므로 자세히 검토해야 할 수도 있습니다. 이렇게하려면 요약 테이블에서 선택하고 분포 단추. 이전과 마찬가지로, 어떤 비율의 비가 시적인 값이 열을 유지하는 것을 정당화해야하는지 결정해야합니다.
범주 형 데이터를 완료하면 연속 데이터와 동일한 작업을 수행 할 수 있습니다. 필터 팝업 대화 상자에서 다시 선택하십시오. 마디 없는 선택을 취소하다 서수 과 명사 같은 ( Alt 핫 스폿을 클릭하기 전에 키를 눌러 여러 항목을 선택할 수 있습니다. 요약을 표시 한 후 오름차순으로 정렬 표준 개발 (오른쪽 끝에 있습니다). 열 표준 개발 0과 같을 때 하나의 값만 있습니다. 하나만 있어야합니다 ( 빗 CO2 보정 조정 ). 정렬 기준 N 없음 값이 대부분 누락 된 열을 찾습니다.
불필요한 열 제거가 끝나면 데이터 및 모델링 유형을 확인할 수 있습니다. JMP가 처음에 다른 소스의 데이터를 읽을 때 숫자 만 포함하는 열에는 숫자 데이터 유형 및 마디 없는 모델링 유형. 그렇지 않은 경우 캐릭터 데이터 유형 및 명사 같은 모델링 유형. 경우에 따라 JMP는 열을 숫자 문자 값이 몇 개인 경우에도 마찬가지입니다. 이 경우 그림 3과 같은 경고 메시지가 표시됩니다.
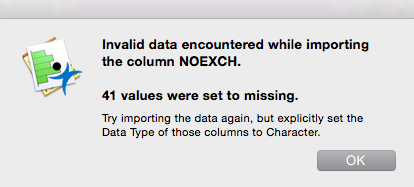
그림 3. 문자 값이 누락 된 경우 경고 메시지가 표시됩니다.
JMP의 기본값은 대부분의 경우 잘 작동하지만 알아 두어야 할 몇 가지 상황이 있습니다. 첫째, 숫자 열에 "NA", 오류 코드, 비정상적인 관찰을 표시하는 기호 등이 포함 된 텍스트가있는 경우 - 열은 다음과 같이 읽을 수 있습니다. 캐릭터 / 명사 같은 . 둘째, 숫자 값은 코드화 된 가치관 정확히 잰 값. 이러한 상황에서는 모델링 유형을 다음과 같이 처리해야합니다. 명사 같은 . 마지막으로, 어떤 상황에서는 측정 된 범주 형 값이 서수 형으로 취급되어야합니다. 다행히도 모델링간에 차이가있는 경우는 비교적 적습니다. 명사 같은 데이터 및 모델링 서수 데이터.
따라서 우리는 Columns Viewer를 계속 사용할 수 있습니다. 우리의 다음 과제는 범주형 숫자 형 열을 찾는 것입니다. (다른 작업은 다음 게시물을 기다려야합니다.)
이 열을 찾으려면 다음을 수행하십시오.
열보기에서 모든 연속 열의 요약을 작성하십시오.아래의 요약 통계 핫스팟, 데이터 표보기를 선택하십시오.모든 항목을 선택하십시오. 숫자 열을 선택하고 모델링 유형을 다음과 같이 변경하십시오. 서수 . 대부분의 데이터가 처음부터 순서대로 사용되므로 서수를 사용하는 것을 좋아합니다. 마디 없는 또는 명사 같은 . 서수로 만들면 숫자 , 나는 그것을 범주화하는 것을 고려 중입니다. 의 모든 열이 열보기 선택기 을 선택하고 요약보기 . 비어있는 경우 열보기 선택기 상자에서 먼저 열보기 뷰어 필터에서 서수를 다시 켜십시오.요약 내에서 마우스 오른쪽 버튼을 클릭하고 Make into Data Table을 선택하십시오. 이미 데이터보기가 있으므로 다른보기를 만들 필요가 없습니다.2 단계의 표를 4 단계의 표로 업데이트하십시오. 이름이 지정된 열과 일치 열 .2 단계에서 작성한 테이블을 선택하십시오. 이동 테이블> 업데이트 목록 상자에서 4 단계에서 생성 한 테이블을 선택하고 열 일치 열 이름을 변경하지 않았다고 가정하면 열을 선택하십시오. 열 각 표에서 시합 . 결과는 그림 4와 유사합니다.딸깍 하는 소리 승인 .정렬 기준 N 카테고리 .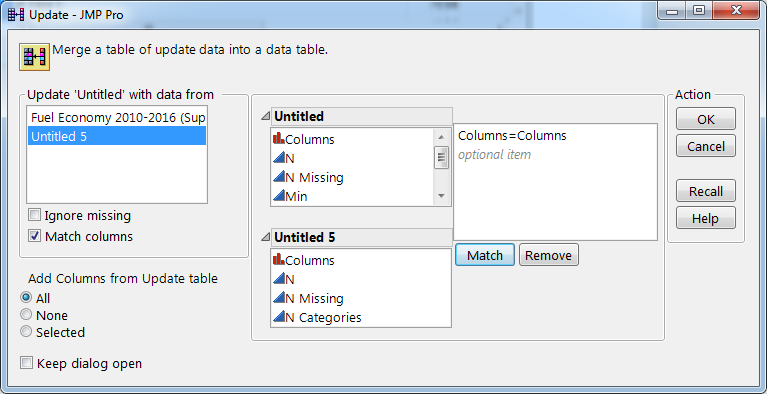
그림 4. 일치하는 열과 함께 업데이트 사용
보고서 창의 요약 테이블과 마 y 가지로 결과 테이블은 작성된 데이터 테이블에 링크됩니다. 데이터보기를 사용 중이므로 이전에 상위 데이터 테이블에서 선택된 열을 선택 해제해야 할 수 있습니다. 범주 형 변수를 찾으려면 범주 수가 적은 열 또는 Min 값이 0에 가까운 열을 찾습니다.
범주 형 수치 데이터를 찾는 이러한 접근 방식은 완벽하지는 않지만 빠르고 쉽게 시작할 수 있습니다. 요약 데이터 테이블에서 행을 선택하고 상위 테이블로 돌아가서 다음을 실행하여 간단한 검사를 수행 할 수 있습니다 분포 선택한 열에서 열이있는 경우 N 카테고리 6 이하이면 열 몇 개에 십진수가 포함 된 값이 있음을 알 수 있습니다. 이러한 열을 처음부터 제외하는 것이 좋았지 만 Columns Viewer는 현재이 기능을 제공하지 않으므로 약간의 스크립팅으로이 작업을 수행 할 것입니다.
우리는 다음 번에 그 이상에 대해 이야기 할 것입니다.
