データ分析を行う人にとっては、データのクリーニングに多くの時間を費やすのが一般的です。実データはダーティデータです。自動収集ツールを使用している場合でも、エラー、異常、矛盾がデータに反映されます。
今後数回のブログ投稿で、データの完全性を向上させるための簡単な手法をいくつか紹介します。何を探すべきか、そしてそれを使ってそれを行う方法について話します。 JMP 。多くの場合、JMPにはタスクを実行するために必要なすべての機能があります。いくつかのケースでは、クリーニングに役立つスクリプトをまとめました。これらのスクリプトは JMPユーザーコミュニティ 。
データクリーニングをコンテキストに入れるには、問題が発生する可能性がある一般的な場所を3つ考えてください。あなたが問題に出くわすかもしれない最初の場所はあなたのデータセットを構築している間です。区切り文字がない、列名が一致しない、およびタイムスタンプが同期していないと、データへのアクセス、連結、結合が困難になります。データがJMPデータセットに入ると、別の問題に遭遇することになります。誤ったデータやモデルの種類、値のない列、エラーコード、つづりの誤った値が一般的です。最後に、分析プロセスで、異常値の削除、列の変換、または変数レベルの集計が必要になることがあります。
真ん中から始めましょう、上記の2番目の領域です。データセットを作成しましたが、分析の前にクリーンアップする必要があります。私はこれがあなたがあなたの問題の大部分に遭遇する場所であると思う。まず、不要な列を削除し、データとモデリングの種類を正しくすることに焦点を当てます。これの多くは、Columns Viewerだけで実現できます。
説明のために、米国環境保護庁のWebサイトからダウンロードしたデータを使用します。自動車の燃費 。7つの別々のExcelワークシート(データセット内の各年に1つ)をダウンロードして連結しました。発見できるデータ JMPユーザーコミュニティで。
私たちができる最初のことは、ほとんどまたはまったく情報なしで変数を削除することです。すべての値が同じ(または、欠けている)列は理想的な候補です。Columns Viewerを使用する(Colsメニューの下):
チェックを外してカテゴリー値のみをフィルタリング連続的 。(これはすべてのプラットフォームダイアログボックスにあるのと同じ列エディタです。)すべての列を選択してクリック要約を表示 。下の表を右クリック要約統計そして選ぶ列で並べ替え… 選択する Nカテゴリーそしてチェック上昇サマリーテーブルで選択した列は、親データテーブルでも同時に選択されます。これにより、操作を実行する前に特定のプロパティを持つ列を事前選択できるため、多くの列操作が簡単になります。
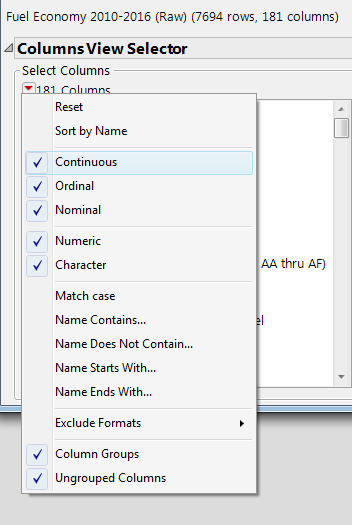
図1。列ビューアフィルタを使用すると、特定のプロパティを持つデータテーブル列をすばやく識別できます。
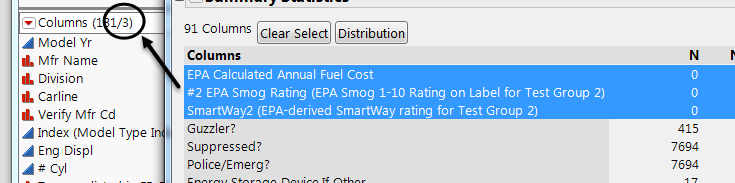
図2 列ビューアの要約ウィンドウで選択された列もデータテーブルで選択されます。
上の3列には欠損値がすべてあり、削除できることに注意してください。選択したら、列>列の削除データテーブルからそれらを削除します。削除された列はサマリテーブルから削除されないので、再実行するのが理にかなっているかもしれないことに注意してください。要約を表示 (すべての列を再選択することを忘れないでください)。古いサマリーテーブルを削除してレポートを整理することができます(の横にあるホットスポットの下を見てください)。要約統計タイトル)。
次の10列には値が1つだけあります。それらを保持するかどうかの決定は、それらが持っている欠損値の割合と、あなたがそれらの識別が追加情報を提供すると思うかどうかに依存します。2列抑制された?そして警察/ Emerg?欠損値がない(つまり、すべての行が同一である)ため、安全に削除できます。残りの8つの列のうち7つはほとんど欠落しており(> 99.997%)、除去に適している可能性があります。残りの列グズラー?約5%が欠けていないし、維持する価値があるかもしれません。(どの列も、複数の列に分割された変数の一部ではないと想定します。この状況を見つけて解決する方法については、後の投稿で説明します。)
上記の単一カテゴリの例では、データの大部分が欠落していました。ただし、ほとんどのデータが欠落していない場合は、列を削除するタイミングを正当化するために同様の引数を使用できます。列が単一の値で構成されていても、欠測値の割合が十分に大きい場合は、それを維持することを検討してください。これらの欠けている値がどこにあるかはあなたに何かを伝えているかもしれません。
欠けている度合いが高い複数カテゴリの列も削除できます。これを行うには、サマリーテーブルを右クリックして並べ替えます。 Nがありません 。チェックしない上昇なぜなら、値がほとんど欠落している列だけを考慮したいからです。これらの列には複数のカテゴリがあるため、それらをより詳細に調べることもできます。これを行うには、サマリーテーブルでそれらを選択して、分布ボタン。前と同じように、欠落していない値のどの割合が列を保持することを正当化するのかを決定する必要があります。
カテゴリカルデータを使用し終えたら、連続データを使用して同じ操作を実行できます。フィルタポップアップダイアログで、再度選択します。連続的そして選択を解除序数そして公称 (を持っていることを覚えている Alt ホットスポットをクリックする前にキーを押すと、複数の選択を行うことができます。要約を表示した後、昇順で並べ替えます Std Dev (右端にあります) ここで列 Std Dev ゼロと等しい場合、単一の値のみを持ちます。1つだけあるべきです( 調整された櫛CO2丸み ) 並び替え Nがありません値がほとんど欠落している列を見つけるため。
不要な列の削除が完了したら、データとモデリングの種類の確認に進むことができます。JMPが最初に他のソースからデータを読み込むとき、数字だけを含む列には数値データ型と連続的モデリングタイプ。それ以外の場合は、キャラクターデータ型と公称モデリングタイプ。時折、JMPは列をに設定します。数値いくつかの文字値があっても。この場合、図3のような警告メッセージが表示されます。
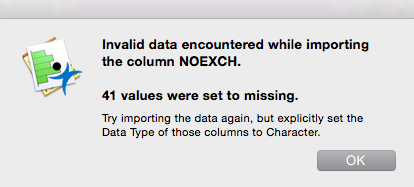
図3 文字値が欠落に設定されているときの警告メッセージ。
JMPのデフォルトはほとんどの場合うまく機能しますが、知っておくべき状況がいくつかあります。まず、数値列に無関係のテキストがある場合 - 「NA」、エラーコード、異常な観測値にフラグを立てるための記号など - 列は次のように読みます。キャラクター / 公称 。次に、数値はに対応します。コード化値ではなく測定済み値 このような状況では、モデリングタイプを公称 。最後に、状況によっては、測定されたカテゴリ値は序数として扱われるべきです。幸いなことに、モデル化とモデル化の違いがある場合は比較的少ないです。公称データとモデリング序数データ。
だから私たちはColumns Viewerを使い続けることができます。次のタスクは、カテゴリカル数値列を見つけることです。(他の仕事は次の投稿を待つ必要があります。)
これらの列を見つけるには
列ビューアですべての連続列の概要を作成します。下要約統計ホットスポットの場合は、[データテーブルビュー]を選択します。すべて選択数値列を作成し、それらのモデリングタイプを序数 。私は序数を使うのが好きです。連続的または公称 。それを序数にすると、それがそれであることがわかります。数値しかし、私はそれをカテゴリカルにすることを検討しています。のすべての列を確認してください。列表示セレクタを選択してクリック要約を表示 。空の場合列表示セレクタボックスで、最初に列ビューアフィルタで序数をオンにします。要約内を右クリックして「データ表にする」を選択します。データビューはすでにあるので、別のビューを作成する必要はありません。手順2のテーブルを手順4のテーブルで更新します。という名前の列で一致列 。手順2で作成したテーブルを選択します。に行くテーブル>更新リストボックスからステップ4で作成したテーブルを選択し、列を一致させる列名を変更していないと仮定して、列を選択します。列各表からクリックして一致 。結果は図4のようになります。クリック OK 。並び替え Nカテゴリー 。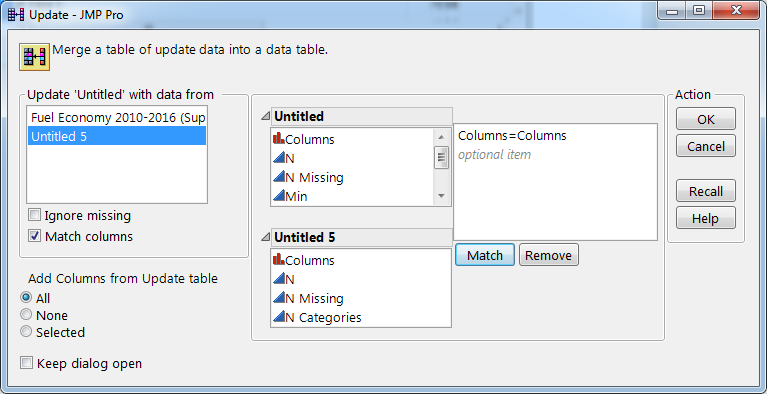
図4 一致する列で更新を使用する。
レポートウィンドウのサマリテーブルと同様に、結果テーブルは作成元のデータテーブルにリンクされます。データビューを使用しているため、親データテーブルで以前に選択された可能性がある列の選択を解除する必要があります。カテゴリカル変数を見つけるには、カテゴリ数が少ない列やMin値が0に近い列を探します。
カテゴリカル数値データを見つけるためのこのアプローチは完璧とは言い難いものの、迅速で簡単なスタートです。要約データ表の行を選択し、親表に戻ってから実行することで、簡単なチェックを実行できます。分布選択した列で。あなたが持っている列でこれを行うと Nカテゴリー 6以下では、少数の列に小数点付きの値が含まれています。最初からこれらの列を除外した方がよかったでしょうが、Columns Viewerは現在これを提供していないので、少しスクリプトを使ってこれを行います。
私達はそれについてそして次回もっと話します。
