Los datos que desea importar JMP a menudo requiere algo de manipulación antes de que esté listo para ser analizado en JMP. A veces los datos se organizan de manera que una fila contenga información para múltiples observaciones. Para preparar sus datos para el análisis, debe reestructurarlos de modo que cada fila de la tabla de datos JMP contenga información para una sola observación. En este ejemplo, verá cómo reestructurar los datos apilando y recodificando una tabla de datos en JMP. Una vez que se apilan los datos, podemos realizar un análisis de Oneway.
Los datos utilizados en este ejemplo se llaman Fill Weights.xlsx, que se encuentra en la carpeta Muestras / Importar datos instalados con JMP. Este dato representa el peso de las cajas de cereales producidas en tres líneas de producción. El objetivo es apilar los datos para comparar los resultados de las líneas de producción y ver si están produciendo aproximadamente el mismo peso medio de llenado. Idealmente, el peso de relleno medio de cada línea de producción estará cerca del peso de relleno objetivo.
En Fill Weights.xlsx, las líneas de producción se organizan en tres conjuntos de columnas. En su tabla de datos JMP, debe apilar los datos de las tres líneas de producción en un único conjunto de columnas. De esta manera, cada fila representa los datos para una sola parte.
La siguiente figura muestra el formato inicial de los datos en Excel. Los pesos de las cajas de cereales se muestrean de forma aleatoria desde tres líneas de producción diferentes.
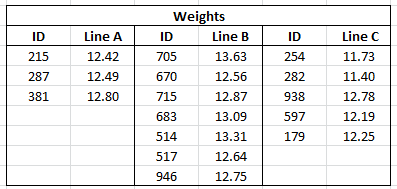
Hoja de cálculo de Excel - sin apilar
Las columnas de ID contienen un identificador para cada caja de cereal que se midió. Las columnas de Línea contienen los pesos (en onzas) para cajas muestreadas de la línea de producción correspondiente.
El peso de llenado objetivo para las cajas es de 12.5 onzas. Aunque le interesa saber si las tres líneas de producción cumplen con el objetivo, inicialmente desea ver si las tres líneas alcanzan la misma tasa de llenado promedio. Después de configurar correctamente los datos, puede realizar un análisis de Oneway para comprobar las diferencias entre los pesos medios de llenado.
Importar los datos
Para empezar, primero debes importar los datos. Seleccionar Archivo> Abrir en JMP y seleccione Fill Weights.xlsx de la carpeta Samples / Import Data.
En la vista previa del Asistente de importación de Excel, la fila 1 contiene información sobre la tabla, y la fila 2 está en blanco. La información del encabezado de la columna comienza en la fila 3. Además, las filas 3 y 4 contienen información de encabezado de columna. Cambie la configuración en el Asistente de importación de Excel para que los encabezados de columna comiencen en la fila 3 y el número de filas con encabezados de columna sea 2.
Así es como se ve la tabla de datos una vez que haya terminado de editar en el Asistente de importación de Excel:
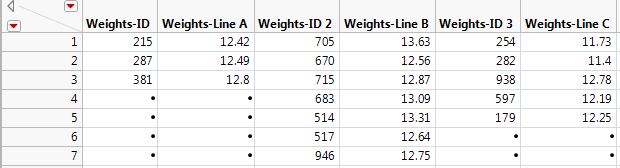
Tabla de datos importados
Los datos se colocan en siete filas y aparecen múltiples ID en cada fila. Para cada una de las tres líneas, hay una columna de ID y peso, que da un total de seis columnas.
Tenga en cuenta que la parte "Pesos" del nombre de la columna de ID es innecesaria y engañosa. Puede cambiar el nombre de las columnas ahora, pero será más eficiente cambiar el nombre de las columnas después de apilar los datos.
Apilar los datos
Cambie la forma de los datos para que cada fila en la tabla de datos JMP refleje solo una observación. Esto requiere que apile las ID de la caja de cereal, los identificadores de línea y los pesos en columnas.
Para ello, seleccione Tablas> Pila para colocar una observación en cada fila de una nueva tabla de datos. Debido a que está apilando dos series, ID y Línea, esta es una pila de series múltiples. En la ventana Pila, seleccione la opción Eliminar filas faltantes para deshacerse de las filas con datos faltantes. Esta es la ventana de pila completa:
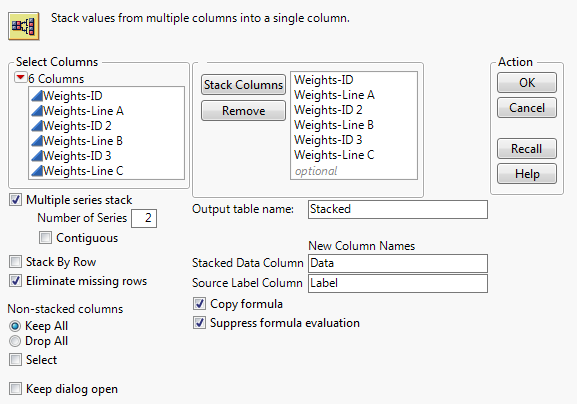
Ventana de pila
La tabla de datos apilados contiene columnas etiquetadas Datos y Datos 2. Estas columnas contienen la ID y los datos de peso. Elimine la columna Etiqueta ya que las entradas eran los encabezados de columna para los identificadores de cuadro, que no necesita en su tabla.
Para hacer que la tabla de datos sea más comprensible, cambie el nombre de cada columna haciendo doble clic en el encabezado de la columna. En este ejemplo, las columnas se renombran como sigue:
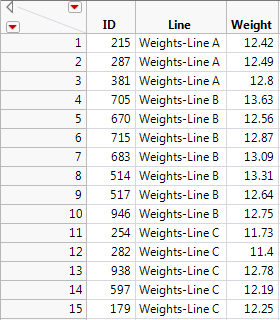
Nuevos encabezados de columna
Como se mencionó anteriormente, puede excluir la parte "Pesos" de la columna Línea para hacer que la tabla sea más legible. Haga clic en el encabezado de la columna Línea para seleccionar la columna y seleccionar Cols> Recode .
Cambie los valores en la columna Nuevos valores para que coincidan con los de la figura siguiente.
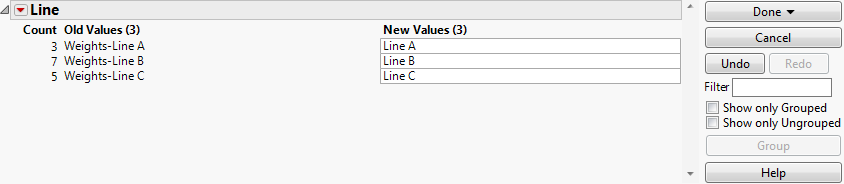
Recodificar columnas
Después de recodificar y seleccionar Hecho> en el lugar , su nueva tabla de datos ahora está adecuadamente estructurada para analizar en JMP. Ahora, cada fila contiene datos para una caja de cereal individual. La primera columna proporciona la identificación de la caja, la segunda proporciona la línea de producción y la tercera el peso de la caja.
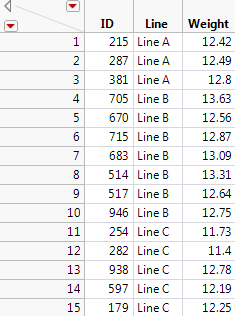
Tabla de datos apilados completada
Conducir el Análisis de Oneway
Ahora que sus datos están apilados, podemos realizar un Análisis de varianza de Oneway para probar las diferencias en los pesos medios de llenado entre las tres líneas de producción.
Para ello, seleccione Analizar> Ajustar Y por X y asigna Peso a Y, Respuesta y Línea a X, Factor. Una vez que se crea la trama, seleccione Medios / Anova en el menú del triángulo rojo.
Los diamantes medios en la gráfica muestran intervalos de confianza del 95% para las medias de la línea de producción. Los puntos que caen fuera de los diamantes medios no son valores atípicos. Para ver esto, agregue diagramas de caja a la parcela. En el menú del triángulo rojo, seleccione Opciones de visualización> Gráficos de caja .
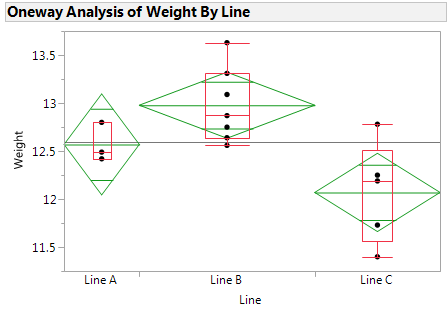
Diagramas de caja
Observe que todos los puntos caen dentro de los límites de los gráficos de caja por lo tanto, no son valores atípicos.
Veamos los resultados comparativos de Todos los pares, Tukey HSD. En el menú del triángulo rojo, seleccione Comparar Medios> Todos los pares, Tukey HSD . En la gráfica, haga clic en el círculo de comparación para la Línea C. Aquí están los resultados:
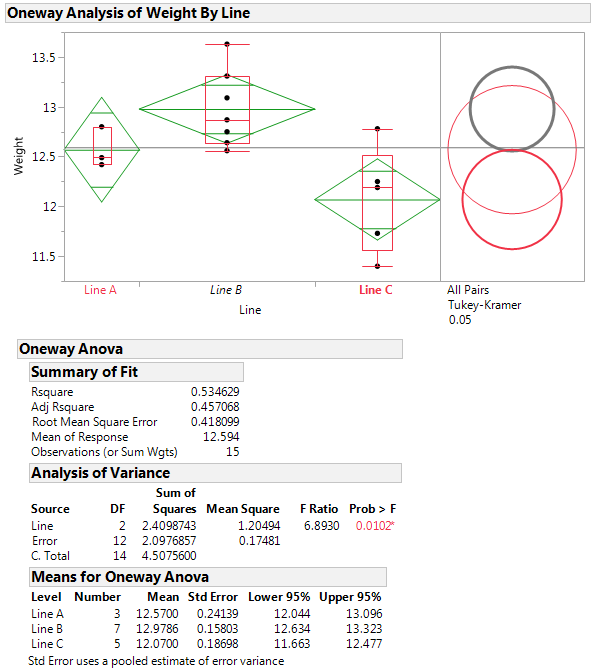
Peso por línea
En el informe de Análisis de Varianza, el valor p de 0.0102 proporciona evidencia de que las medias no son todas iguales. Compara los medios de cada grupo visualmente examinando la intersección de los círculos de comparación. El ángulo exterior de la intersección le indica si las medias del grupo son significativamente diferentes. Si el ángulo de intersección es cercano a 90 grados, puede verificar si los medios son significativamente diferentes haciendo clic en el círculo de comparación para seleccionarlo.
Los grupos que son diferentes del grupo seleccionado aparecen como círculos grises gruesos. Aviso La línea C está seleccionada y aparece roja (en los colores predeterminados de JMP), y la línea B aparece en gris grueso. Esto significa que la Línea B no está en el mismo grupo que la Línea A, por lo tanto, sus medios son significativamente diferentes. La media para la Línea C difiere de la media para la Línea B en el nivel de significancia de 0.05. Las líneas A y B no muestran una diferencia estadísticamente significativa.
Además, los diamantes medios mostrados en la parcela abarcan intervalos de confianza del 95% para las medias. Los límites numéricos para los intervalos de confianza del 95% se proporcionan en el informe ANOVA de Medias para Oneway. La gráfica indica que los intervalos de confianza para las Líneas B y C no contienen el peso objetivo de relleno de 12.5: la Línea B parece llenarse en exceso y la Línea C parece no llenarse. Para estas dos líneas de producción, deben abordarse las causas subyacentes que resultan en pesos de relleno fuera del objetivo. Quizás el equipo necesita ser reemplazado, o tal vez las líneas necesiten ser ajustadas.
Con los datos estructurados de manera similar a los datos utilizados en este ejemplo, cualquiera sea su caso, apilarlo para un análisis de Oneway es una excelente manera de comparar sus resultados.
