Basta con mirar la lista de funciones de caracteres disponibles en el JMP Editor de fórmulas.
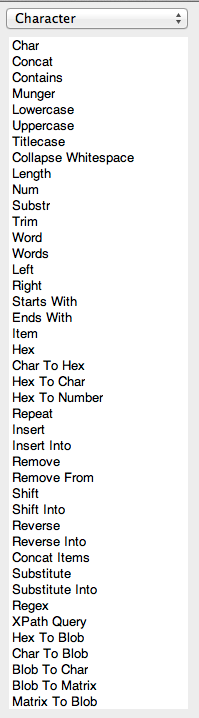
No es que nadie esté contando, ¡pero son 42 funciones! No hace falta decir que si tienes una columna de caracteres y quieres cambiarla de alguna manera, JMP probablemente tenga una función para hacerlo por ti.
Sin embargo, tenga en cuenta que nueve de esas funciones tienen como objetivo, o en su mayoría, extraer una parte del valor de un carácter. Es cierto que esta es una de las operaciones más comunes: extraer una parte de una cadena de caracteres más grande. Esto se conoce como subcadena.
La función más obvia para esto es la substr() función, pero esta función requiere que sepa exactamente dónde se encuentra la parte que le interesa en la cadena más grande. También significa que la parte que deseas debe estar en el mismo lugar en cada cadena.
Por eso amo el Palabra() función. Es increíblemente flexible y funciona como creo.
El Palabra() La función toma dos argumentos obligatorios y uno opcional.
Palabra(n, "texto", <"delimitadores">)
El Palabra() función divide el texto en palabras basadas en la delimitadores usted especificó y devuelve el n th palabra. Si no especifica el delimitadores argumento, entonces el delimitador predeterminado es el mismo que usamos para separar palabras en oraciones: un espacio.
Como ejemplo, considere la siguiente columna de días:
| Día |
|---|
| 6 de diciembre |
| 16 de diciembre |
| 28 de septiembre |
| 19 de mayo |
| 29 de septiembre |
| 11 de septiembre |
| Marzo 14 |
| 13 de noviembre |
| 27 de octubre |
| 7 de enero |
Separar el mes es fácil con el Palabra() función. Solo quieres la primera palabra de cada cadena.
Palabra( 1, Día )
| Mes |
|---|
| Diciembre |
| Diciembre |
| Septiembre |
| Puede |
| Septiembre |
| Septiembre |
| Marzo |
| Noviembre |
| Octubre |
| Enero |
Eso funciona bien en muchos casos, pero el verdadero poder surge cuando piensas en usar otros caracteres como delimitadores para dividir una cadena en "palabras".
Aquí hay otra lista. Estas son ubicaciones. Esta vez, la latitud y la longitud están incrustadas en la cadena detrás del nombre de la ciudad.
| Ubicación |
|---|
| 1600 NEW BERN AVE Raleigh, Carolina del Norte [35.779892815000494, -78.61572674699966] |
| 3800 NEW BERN AVE Raleigh, Carolina del Norte [35.79777009600048, -78.57633099599968] |
| 3200 CAPITAL BLVD Raleigh, Carolina del Norte [35.822875239000496, -78.58848179699964] |
| 700 VARDAMAN ST Raleigh, Carolina del Norte [35.77016025800049, -78.61995064499968] |
| 2900 TILO DR Raleigh, Carolina del Norte [35.74121031600049, -78.60477047599966] |
| 1300 CURFMAN ST Raleigh, Carolina del Norte [35.76619700500049, -78.65143264899967] |
| 8500 SWARTHMORE DR Raleigh, Carolina del Norte [35.89068092800045, -78.60012101699965] |
| 1200 CANYON ROCK CT Raleigh, Carolina del Norte [35.76156160400046, -78.55683519199965] |
| 800 GREENWICH ST Raleigh, Carolina del Norte [35.768321829000456, -78.59393748999963] |
| 300 ROSELLE CT Raleigh, Carolina del Norte [35.788000157000454, -78.58367178499964] |
Sería útil tener latitud y longitud en otra columna.
Si piensa en los corchetes como delimitadores, esto es bastante simple. Sólo quieres la segunda "palabra".
Palabra(2, Ubicación, "[]")
Ahora tienes una columna (LatLong) de cadenas que tienen latitud y longitud separadas por una coma y un espacio.
| Latitud longitud |
|---|
| 35.779892815000494, -78.61572674699966 |
| 35.79777009600048, -78.57633099599968 |
| 35.822875239000496, -78.58848179699964 |
| 35.77016025800049, -78.61995064499968 |
| 35.74121031600049, -78.60477047599966 |
| 35.76619700500049, -78.65143264899967 |
| 35.89068092800045, -78.60012101699965 |
| 35.76156160400046, -78.55683519199965 |
El Palabra() La función vuelve al rescate. Esta vez queremos utilizar comas y espacios como delimitadores. Si usamos solo una coma, entonces la cadena de longitud tendrá un espacio al principio. El uso de ambos delimitadores nos da cadenas sin espacios.
Latitud
Palabra(1, LatLong, ", ")
Longitud
Palabra(2, LatLong, ", ")
Estos deben limpiarse aún más convirtiéndolos a números usando el Núm() función, pero eso es un ejercicio para otra publicación.
La clave para aprovechar el Palabra() La función es ver sus cadenas como "oraciones" y pensar de manera abstracta acerca de la elección de delimitadores.
He aquí un último ejemplo. Supongamos que tiene una columna de números de lote (LotNo) con un nombre incrustado en el medio:
| Mucho no |
|---|
| A30941ALTE69073172 |
| A82886ILEAK51521781 |
| A54715XSURVXC88997379 |
| A7860BATTBC97523479 |
| A79004ILEAK52159080 |
| A59508ABAEG58962051 |
| A44172ILEAK28255713 |
| A21319XSURVXC88014800 |
| A58308BATTBC49519851 |
| A19412C83938451 |
Esto es difícil ya que el nombre no aparece en la misma posición en la cadena en cada fila. Si piensa en los números de la misma manera que piensa en los espacios cuando lee, entonces el nombre se convierte en la "segunda" palabra.
Palabra(2, n.º de lote, "0123456789")
| NOMBRE |
|---|
| ALTO |
| IFUGA |
| XSURVXC |
| BATTBC |
| IFUGA |
| ABAEG |
| IFUGA |
| XSURVXC |
| BATTBC |
| C |
Si tiene tiempo para aprender sólo una de las funciones de 42 caracteres en el editor de fórmulas, comenzaría con Palabra() función.
Muy útil.
¡Gracias por enfatizar este sobre todos los demás...!
Yee Seng Lee escribió:
Muchas gracias. ¡Funciona perfecto!
Jeff Perkinson escribió:
Prueba el Artículo() funcionar en su lugar. Es como Word() excepto que trata múltiples delimitadores como si cada uno de ellos definiera un nuevo elemento.
Yee Seng Lee escribió:
Hola Jeff,
Si tuviera una cadena = "1*2*3**5***8" donde se pretende dividir en 8 columnas separadas en lugar de 5, lo que significa que el doble ** debe considerarse como una columna con datos vacíos , mientras que triple *** debe considerarse como dos columnas con datos vacíos, y así sucesivamente, ¿alguna solución con la función de Word?
Jeff Perkinson escribió:
Gracias, Pablo. Actualicé la publicación para corregir esa tabla.
Pablo Savarese escribió:
Jeff: Disfruté tu publicación sobre la función WORD, pero el último ejemplo me confundió un poco. Parece que algo está fuera de lugar. El primer número de lote es A30941ALTE69073172 y la 'palabra' incrustada es, aparentemente, ALTE, pero la palabra (2, número de lote, "0123456789") se muestra como que devuelve el valor 'C'. Además, algunos de los otros números de lote tenían incrustadas las palabras "XSURVX", pero ninguno de los resultados mostró que estuviera seleccionado. Además, no vi la palabra 'VOLT' incrustada en ninguno de los números de lote, pero aparece como resultado de la función PALABRA en dos ocasiones.
Gracias,
Pablo S.
