다음에서 사용할 수 있는 캐릭터 기능 목록을 살펴보세요. JMP 수식 편집기.
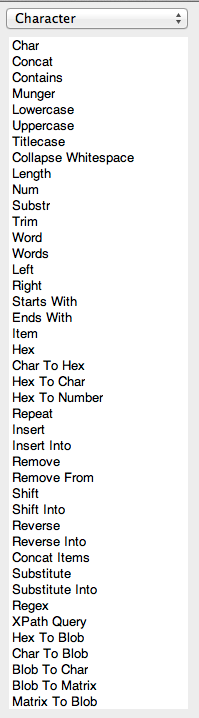
누구도 세고 있지는 않지만 42개의 기능이 있습니다! 말할 필요도 없이, 문자 열이 있고 이를 어떻게든 변경하고 싶다면 JMP에 이를 수행하는 기능이 있을 것입니다.
하지만 이들 함수 중 9개는 모두 또는 대부분 문자 값의 일부를 추출하는 것에 관한 것입니다. 물론 이것은 가장 일반적인 작업 중 하나입니다. 더 큰 문자열의 일부를 추출하는 것입니다. 이를 하위 문자열이라고 합니다.
이에 대한 가장 확실한 기능은 하위 문자열() 함수이지만 이 함수를 사용하려면 관심 있는 부분이 더 큰 문자열에서 어디에 있는지 정확히 알아야 합니다. 이는 또한 원하는 부분이 모든 문자열에서 동일한 위치에 있어야 함을 의미합니다.
그렇기 때문에 나는 ~를 좋아한다 단어() 기능. 놀랍도록 유연하고 제가 생각하는 방식대로 작동합니다.
그만큼 단어() 함수는 두 개의 필수 인수와 하나의 선택 인수를 취합니다.
단어(n, "텍스트", <"구분자">)
그만큼 단어() 함수는 텍스트 에 기초하여 단어로 구성됩니다. 구분 기호 당신이 지정하고 n을 반환 일 단어. 지정하지 않으면 구분 기호 인수인 경우 기본 구분 기호는 문장에서 단어를 구분하는 데 사용하는 것과 동일한 공백입니다.
예를 들어, 다음 날짜 열을 고려해 보세요.
| 낮 |
|---|
| 12월 6일 |
| 12월 16일 |
| 9월 28일 |
| 5월 19일 |
| 9월 29일 |
| 9월 11일 |
| 3월 14일 |
| 11월 13일 |
| 10월 27일 |
| 1월 7일 |
월을 구분하는 것은 쉽습니다. 단어() 기능. 각 문자열의 첫 번째 단어만 원합니다.
단어( 1, 일 )
| 월 |
|---|
| 12월 |
| 12월 |
| 구월 |
| 5월 |
| 구월 |
| 구월 |
| 3월 |
| 십일월 |
| 십월 |
| 1월 |
이는 많은 경우에 잘 작동하지만 문자열을 "단어"로 나누기 위해 다른 문자를 구분 기호로 사용한다고 생각할 때 진정한 힘이 나옵니다.
여기 또 다른 목록이 있습니다. 위치는 다음과 같습니다. 이번에는 위도와 경도가 도시 이름 뒤의 문자열에 포함됩니다.
| 위치 |
|---|
| 1600 NEW BERN AVE 롤리, NC [35.779892815000494, -78.61572674699966] |
| 3800 NEW BERN AVE Raleigh, NC [35.79777009600048, -78.57633099599968] |
| 3200 CAPITAL BLVD 롤리, NC [35.822875239000496, -78.58848179699964] |
| 700 VARDAMAN ST 롤리, NC [35.77016025800049, -78.61995064499968] |
| 2900 BASSWOOD DR 롤리, NC [35.74121031600049, -78.60477047599966] |
| 1300 CURFMAN ST 롤리, NC [35.76619700500049, -78.65143264899967] |
| 8500 SWARTHMORE DR 롤리, NC [35.89068092800045, -78.60012101699965] |
| 1200 CANYON ROCK CT 롤리, NC [35.76156160400046, -78.55683519199965] |
| 800 GREENWICH ST 롤리, NC [35.768321829000456, -78.59393748999963] |
| 300 ROSELLE CT 롤리, NC [35.788000157000454, -78.58367178499964] |
다른 열에 위도와 경도가 있으면 유용합니다.
대괄호를 구분 기호로 생각하면 매우 간단합니다. 당신은 두 번째 "단어"를 원합니다.
단어(2, 위치, "[]")
이제 위도와 경도가 쉼표와 공백으로 구분된 문자열 열(LatLong)이 생겼습니다.
| 위도경도 |
|---|
| 35.779892815000494, -78.61572674699966 |
| 35.79777009600048, -78.57633099599968 |
| 35.822875239000496, -78.58848179699964 |
| 35.77016025800049, -78.61995064499968 |
| 35.74121031600049, -78.60477047599966 |
| 35.76619700500049, -78.65143264899967 |
| 35.89068092800045, -78.60012101699965 |
| 35.76156160400046, -78.55683519199965 |
그만큼 단어() 기능이 다시 구출됩니다. 이번에는 쉼표와 공백을 구분 기호로 사용하겠습니다. 쉼표만 사용하면 경도 문자열의 시작 부분에 공백이 생깁니다. 두 구분 기호를 모두 사용하면 공백이 없는 문자열이 제공됩니다.
위도
단어(1, LatLong, ", ")
경도
단어(2, LatLong, ", ")
이는 다음을 사용하여 숫자로 변환하여 추가로 정리해야 합니다. 번호() 기능이지만 이는 다른 게시물에 대한 연습입니다.
장점을 활용하는 핵심 단어() 기능은 문자열을 "문장"으로 보고 구분 기호 선택에 대해 추상적으로 생각하는 것입니다.
다음은 마지막 예입니다. 중간에 이름이 포함된 로트 번호(LotNo) 열이 있다고 가정합니다.
| 로트아니오 |
|---|
| A30941ALTE69073172 |
| A82886ILEAK51521781 |
| A54715XSURVXC88997379 |
| A7860BATTBC97523479 |
| A79004ILEAK52159080 |
| A59508ABAEG58962051 |
| A44172ILEAK28255713 |
| A21319XSURVXC88014800 |
| A58308BATTBC49519851 |
| A19412C83938451 |
이름이 각 행의 문자열에서 동일한 위치에 나타나지 않기 때문에 어렵습니다. 읽을 때 공백을 생각하는 것과 같은 방식으로 숫자를 생각하면 이름이 "두 번째" 단어가 됩니다.
워드(2, LotNo, "0123456789")
| 이름 |
|---|
| 알테 |
| ILEAK |
| XSURVXC |
| BATTBC |
| ILEAK |
| 아백 |
| ILEAK |
| XSURVXC |
| BATTBC |
| 씨 |
수식 편집기에 있는 42개의 문자 기능 중 하나만 배울 시간이 있다면 다음부터 시작하겠습니다. 단어() 기능.
@JensRiege 이 게시물을 발견하고 유용하다고 생각하셔서 다행입니다.
매우 도움이 됩니다.
다른 것보다 이 점을 강조해주셔서 감사합니다...!
제프 퍼킨슨 썼다:
시도해 보세요 안건() 대신 기능을 수행합니다. 여러 구분 기호를 각각 새 항목을 정의하는 것으로 처리한다는 점을 제외하면 Word()와 같습니다.
이이생 썼다:
안녕 제프,
5개가 아닌 8개의 개별 열로 분할하려는 문자열 = "1*2*3**5***8"이 있는 경우 이는 이중 **이 빈 데이터가 있는 하나의 열로 간주되어야 함을 의미합니다. , 트리플 ***은 빈 데이터가 있는 두 개의 열로 간주되어야 하는 반면 Word 함수에 대한 해결 방법은 없습니까?
제프 퍼킨슨 썼다:
고마워요, 폴. 해당 테이블을 수정하기 위해 게시물을 업데이트했습니다.
폴 사바레세 썼다:
Jeff: WORD 함수에 대한 게시물은 마음에 들었지만 마지막 예에서는 약간 혼란스러웠습니다. 뭔가 잘못된 것 같습니다. 첫 번째 로트 번호는 A30941ALTE69073172이고 삽입된 '단어'는 분명히 ALTE이지만 Word(2, LotNo, "0123456789")는 'C' 값을 반환하는 것으로 표시됩니다. 또한 다른 Lot No 중 일부에는 'XSURVX'라는 단어가 삽입되어 있었지만 결과에서는 이것이 선택되지 않았습니다. 그리고 Lot No에 'VOLT'라는 단어가 삽입된 것을 본 적이 없는데 2번에 걸쳐 WORD 함수의 결과로 나타나는데요?
감사해요,
폴 S.
