で利用可能な文字関数のリストを見てください。 JMP数式エディター。
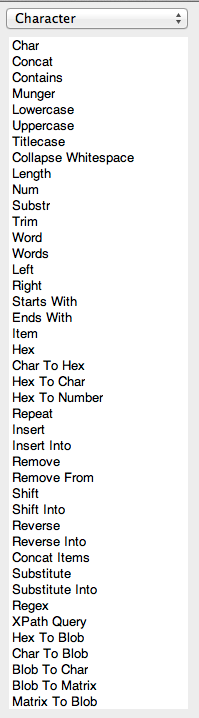
誰も数えていないかもしれませんが、それは 42 個の関数です。 言うまでもなく、文字列があり、それを何らかの方法で変更したい場合は、おそらく JMP にそれを行う機能が用意されています。
ただし、これらの関数のうち 9 つはすべて、またはほとんどが文字値の一部の抽出に関するものであることに注意してください。 確かに、これは最も一般的な操作の 1 つであり、より大きな文字列の一部を抽出します。 これは部分文字列として知られています。
このための最も明白な関数は、 Substr()ただし、この関数では、関心のある部分が大きな文字列のどこにあるかを正確に知っている必要があります。 また、必要な部分がすべての文字列の同じ場所に存在する必要があることも意味します。
だからこそ私は言葉()関数。 驚くほど柔軟で、私の考えたとおりに機能します。
の言葉() function は 2 つの必須引数と 1 つのオプションの引数を取ります。
Word(n, "テキスト", <"区切り文字">)
の言葉()関数は、文章に基づいて言葉にする区切り文字指定したnを返します番目言葉。 指定しない場合は、区切り文字引数を指定した場合、デフォルトの区切り文字は、文内の単語を区切るのに使用するものと同じ、スペースです。
例として、次の日数の列を考えてみましょう。
| 日 |
|---|
| 12月6日 |
| 12月16日 |
| 9月28日 |
| 5月19日 |
| 9月29日 |
| 9月11日 |
| 3月14日 |
| 11月13日 |
| 10月27日 |
| 1月7日 |
月の区切りは、言葉()関数。 各文字列の最初の単語だけが必要です。
Word( 1, 日 )
| 月 |
|---|
| 12月 |
| 12月 |
| 9月 |
| 5月 |
| 9月 |
| 9月 |
| 行進 |
| 11月 |
| 10月 |
| 1月 |
多くの場合、これでうまく機能しますが、真の力は、文字列を「単語」に分割するための区切り文字として他の文字を使用することを考えるときです。
ここに別のリストがあります。 これらは場所です。 今回は、緯度と経度が都市名の後ろの文字列に埋め込まれます。
| 位置 |
|---|
| 1600 NEW BERN AVE ローリー、ノースカロライナ州 [35.779892815000494, -78.61572674699966] |
| 3800 NEW BERN AVE ローリー、ノースカロライナ州 [35.79777009600048, -78.57633099599968] |
| 3200 CAPITAL BLVD ローリー、ノースカロライナ州 [35.822875239000496, -78.58848179699964] |
| 700 VARDAMAN ST ローリー、ノースカロライナ州 [35.77016025800049, -78.61995064499968] |
| 2900 BASWOOD DR ノースカロライナ州ローリー [35.74121031600049, -78.60477047599966] |
| 1300 CURFMAN ST ノースカロライナ州ローリー [35.76619700500049, -78.65143264899967] |
| 8500 SWARTHMORE DR ローリー、ノースカロライナ州 [35.89068092800045, -78.60012101699965] |
| 1200 CANYON ROCK CT ノースカロライナ州ローリー [35.76156160400046, -78.55683519199965] |
| 800 グリニッジ ST ローリー、ノースカロライナ州 [35.768321829000456, -78.59393748999963] |
| 300 ROSELLE CT ノースカロライナ州ローリー [35.788000157000454, -78.58367178499964] |
緯度と経度を別の列に含めると便利です。
角括弧を区切り文字と考えると、これは非常に簡単です。 必要なのは 2 番目の「単語」だけです。
Word(2, 場所, "[]")
これで、緯度と経度がカンマとスペースで区切られた文字列の列 (LatLong) ができました。
| 緯度経度 |
|---|
| 35.779892815000494、-78.61572674699966 |
| 35.79777009600048、-78.57633099599968 |
| 35.822875239000496、-78.58848179699964 |
| 35.77016025800049、-78.61995064499968 |
| 35.74121031600049、-78.60477047599966 |
| 35.76619700500049、-78.65143264899967 |
| 35.89068092800045、-78.60012101699965 |
| 35.76156160400046、-78.55683519199965 |
の言葉()関数が再び役に立ちます。 今回は区切り文字としてカンマとスペースを使用したいと思います。 カンマのみを使用する場合、経度文字列の先頭にはスペースが含まれます。 両方の区切り文字を使用すると、スペースのない文字列が得られます。
緯度
Word(1, LatLong, ", ")
経度
Word(2, LatLong, ", ")
これらは、次のコマンドを使用して数値に変換することでさらにクリーンアップする必要があります。数値()関数ですが、それは別の投稿の練習になります。
を活用するための鍵は、言葉()機能は、文字列を「文」として見て、区切り文字の選択について抽象的に考えることです。
最後の例を示します。 中央に名前が埋め込まれたロット番号 (LotNo) の列があるとします。
| ロット番号 |
|---|
| A30941ALTE69073172 |
| A82886ILEAK51521781 |
| A54715XSURVXC88997379 |
| A7860BATTBC97523479 |
| A79004ILEAK52159080 |
| A59508ABAEG58962051 |
| A44172ILEAK28255713 |
| A21319XSURVXC88014800 |
| A58308BATTBC49519851 |
| A19412C83938451 |
各行の文字列内の同じ位置に名前が出現しないため、これは困難です。 数字を読むときにスペースと同じように考えると、名前が「2 番目の」単語になります。
Word(2, LotNo, "0123456789")
| 名前 |
|---|
| アルテ |
| イリーク |
| XSURVXC |
| BATTBC |
| イリーク |
| アバエグ |
| イリーク |
| XSURVXC |
| BATTBC |
| C |
数式エディターの 42 文字関数のうち 1 つだけを学習する時間があれば、まず次の関数から始めます。言葉()関数。
@JensRiegeこの投稿を見つけて役に立ったことを嬉しく思います。
非常に役立ちます。
他のものよりもこれを強調していただきありがとうございます...!
ジェフ・パーキンソン書きました:
試してみてくださいアイテム()代わりに関数を使用します。 これは Word() と似ていますが、複数の区切り文字をそれぞれ新しい項目を定義するものとして扱います。
イーセン・リー書きました:
こんにちは、ジェフさん
文字列 = "1*2*3**5***8" がある場合、5 列ではなく 8 列に分割することを意図しています。つまり、二重 ** は空のデータを含む 1 列とみなされます。 、トリプル *** は空のデータを含む 2 つの列とみなされる必要があるなど、Word 関数での回避策はありますか?
ジェフ・パーキンソン書きました:
ありがとう、ポール。 その表を修正するために投稿を更新しました。
ポール・サバレーズ書きました:
Jeff: WORD 関数に関する投稿は楽しかったですが、最後の例では少し混乱しました。 何かが場違いなようです。 最初のロット番号は A30941ALTE69073172 で、埋め込まれた「ワード」は明らかに ALTE ですが、Word(2, LotNo, "0123456789") は値「C」を返すように表示されます。 また、他のロット番号の一部には「XSURVX」という文字が埋め込まれていましたが、これが選択されたことを示す結果はありませんでした。 また、どのロット番号にも「VOLT」という単語が埋め込まれていませんでしたが、WORD 関数の結果として 2 回表示されました。
ありがとう、
ポール S.
