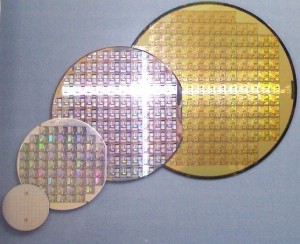
Hace muchos años, agregamos los cuadros de control Presummarized a JMP La versión 5 a petición de la gente en la industria de semiconductores. Si bien hay muchos tipos de gráficos de control Presummarized, uno de los más comunes es el gráfico denominado "Personas en medias grupales", que representa el promedio del subgrupo como un gráfico XBar, pero utiliza el rango de movimiento general entre cada promedio consecutivo para sigma Al calcular los límites.
El proceso típico de fabricación de obleas implica varios pasos, muchos de los cuales se encuentran en una estructura anidada, de parcelas divididas. Por ejemplo, una oblea (en la imagen de arriba) se corta típicamente de un lingote de silicio cilíndrico. Luego, se aplican varios procesos a la oblea antes de ser cortada en trozos individuales, que se convierten en el circuito integrado. De esto, podemos ver que si ocurriera una impureza en el cilindro original, afectaría a todas las obleas cortadas de ese cilindro, y posteriormente a todos los circuitos individuales cortados de cada una de las obleas asociadas con ese cilindro. Sin embargo, si ocurriera un error en una capa a través de una oblea, mientras que afectaría a cada circuito resultante proveniente de esa oblea en particular, no esperaríamos que afecte a ninguna otra oblea o troquelado de esas obleas. En entornos en los que se pueden ver los efectos en distintos niveles de granularidad, como en el proceso de fabricación de semiconductores, un cuadro de resumen o de tres vías puede ser muy útil.
Al utilizar la antigua plataforma de Gráficos de control en JMP, podemos comparar los resultados de la ejecución de una combinación de gráficos XBar / R con un grupo Presummarize de gráficos de control en los mismos datos. Los mismos puntos promedio de subgrupos se trazan en cada gráfico, y cada gráfico tiene la misma media. Mientras se selecciona la Prueba 1 para ambos gráficos, vemos que los puntos fuera de control aparecen solo en el gráfico XBar porque el sigma utilizado para calcular los límites es diferente para cada gráfico (rango frente a rango móvil). El sigma utilizado para el gráfico XBar se basa en el rango promedio dentro para cada subgrupo de obleas, mientras que el individuo en medias grupales ignora la variación en cada combinación de subgrupos de obleas / lotes y solo observa el rango móvil Entre cada subgrupo de obleas / lotes.
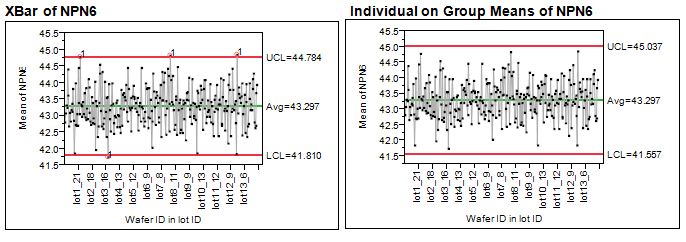
En la Figura 1, muestro solo el primer gráfico en la salida, lo que podría llamarse el gráfico de "Ubicación". El segundo gráfico que normalmente se muestra, o gráfico de "Dispersión", es el gráfico asociado (Rango o Rango móvil) que se usa para calcular el sigma del gráfico de ubicación.
La partición de la varianza para ver realmente todas las fuentes de variación le permite detectar áreas de alto ruido y aplicar límites con el ancho adecuado. Anteriormente, la única forma en que podía hacer esto en JMP era ejecutar dos tipos de gráficos de control: el gráfico R de los gráficos XBar / R y los gráficos Presummarize, o escribir un script que los ejecutara a ambos y luego los concatenara juntos.
En JMP 10, hemos agregado una opción para hacer esto por usted. Así es cómo:
Abra Semiconductor Capability.jmp desde los archivos de datos de muestra en JMP 10Seleccione Analizar-> Calidad y proceso-> Control Chart BuilderArrastre NPN6 a la zona de caída YArrastre lot_id a la zona de colocación X, luego arrastre la oblea sobre lot_id para anidar la oblea dentro de lot_idHaga clic derecho en el gráfico y elija Agregar gráfico de dispersión
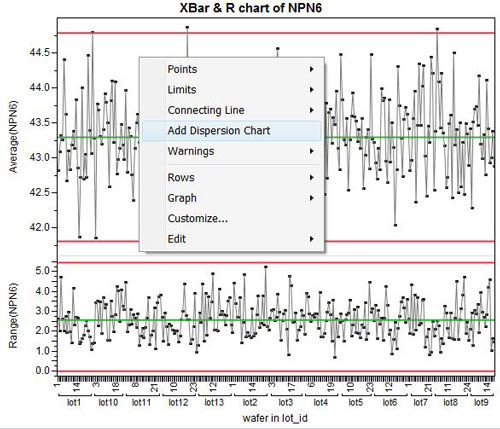
De manera predeterminada, el generador de gráficos de control insertará un rango móvil en el gráfico de medias entre los gráficos XBar y R para mostrar la variación entre las obleas dentro del lote. Además, cambia los límites en el gráfico de ubicación para utilizar el rango de movimiento, cambiándolo así al gráfico Presummarized, Individual on Group Means.
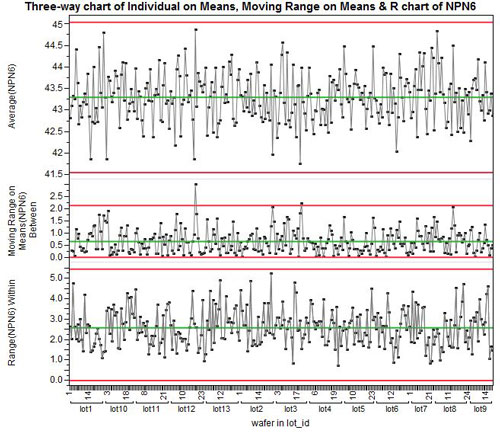
Ahora, los cuadros de control de tres vías presummarizados en JMP están incorporados y son fáciles de usar. Déjame saber lo que piensas de ellos.
Annie Dudley Zangi escribió:
Gracias por las sugerencias y por compartir algunos de sus desafíos. ¿Escribes un blog? Si es así, creo que deberías considerar discutir esto con más detalle en una publicación de blog. Creo que muchos lectores encontrarán su experiencia y cualquier consejo de JSL que pueda prestar.
Mike Clayton escribió:
En la industria de los semiconductores, hemos utilizado un enfoque europeo para la evaluación de la capacidad y los gráficos de control, el producto Camline SPACE (Lineworks es otro de sus nombres) de Alemania.
Ese sistema tiene muchas opciones de métodos LÍMITES y muchas opciones de REGLAS que son más sólidas dados los componentes de la varianza subyacente, el anidamiento y la falta de independencia.
Tenemos subobjetivos que son solo para fines de diagnóstico (3 a 9 sitios en cada oblea, por ejemplo) no para establecer límites de gráficos ... ya que están altamente correlacionados A MENOS que algunos estén deformados o cambios radiales de distribución debido al acondicionamiento de la cámara.
No tenemos un muestreo aleatorio ... pero trazamos cada lote y, a veces, cada oblea, ya que se produce para CONTAINMENT y el uso de DETECCIÓN DE FALLAS de la máquina, no para un ajuste simple ... y aún TAMBIÉN extraemos datos basados en sensores que se utilizan para declarar esa herramienta está bien y luego permite que el gráfico de tendencias de datos de metrología (EWMA por ejemplo) CORRECE la configuración de la receta (control de proceso adaptativo).
Esta MEZCLA es el problema, y JMP solo se usa para planificar y verificar (modo fuera de línea) estas herramientas en tiempo real. Otro ejemplo, otra industria, es el uso de Umetrics para el monitoreo en tiempo real en modo multivariable (refinerías de petróleo, molinos de papel, cualquier industria de proceso continuo). Y JMP se usa nuevamente fuera de línea para la planificación, verificación, etc. del DOE, no para fines de control de procesos.
Así que la utilidad de gráficos en JMP podría agregar algunas reglas de ROBUSTO (N de M punto> 2 sigma, N de M puntos en un lado de la línea central, etc. en lugar de los números de Shewhart o Nelson.
Y los límites podrían establecerse mediante percentiles de la distribución de datos sin procesar, por ejemplo, en lugar de un múltiplo sigma. Límites económicos utilizando estadísticas robustas. Ya hemos discutido estos problemas con muchas personas, y es por eso que Camline tiene tantas opciones ... tuvieron que satisfacer a Infineon como su primer socio (Europa, chips automotrices), y luego otros, durante muchos años.
Se basaba en Q-DAS, una herramienta de software de calidad de la cadena de suministro automotriz, todavía vigente, pero tenía que ser altamente personalizada para los fabricantes de chips.
El otro problema es WAFER MAPS ... para el cual utilizamos gráficos de contorno por oblea para datos BIT (bueno contra malo), así como datos PARÁMETROS, valores reales, contornos reales. Y también para los números de error de BIN (el código de bin de error se utiliza como etiqueta en cada sitio de matriz). Y a menudo tenemos mapas APILADOS que usan medianas (el eng puede elegir el tipo de estadística) para datos paramétricos en muchas obleas y lotes para visualizar patrones espaciales crónicos.
Uno de los otros problemas es cómo cargar los LÍMITES DE ESPECIFICACIÓN (no los límites de control) a COLUMN PROPERTIES desde un archivo de especificaciones (intente BUSCAR en sus muchos tutoriales, libros y entidades de grupos de usuarios) para que la capacidad se pueda ejecutar en 200 o Más parámetros de prueba, y PLOTS puede mostrar los límites como lo hacen en los diagramas de distribución (Graph Builder, por ejemplo, y Fit Y numeric by X nominal). Ahora escribimos scripts personalizados para hacer eso para cada plataforma y en algún momento cada versión de JMP.
