편집자 주 : 이 게시물은에 의해 작성되었습니다 @eric_cai , 또한 화학자이자 통계 학자 인 화학 통계학 자 . Twitter에서 Eric을 팔로우하십시오 @chemstateric .
화학에서 가장 공통적 인 과제 중 하나는 수용액에서 화학 물질의 농도를 결정하는 것입니다 (즉, 화학 물질은 용액에 다른 화학 물질과 함께 물에 용해 됨). 이 작업을 수행하는 일반적인 방법은 다음의 신호를 측정하여 검정 곡선을 만드는 것입니다. 알려진 관심 화학 물질의 양 - 종종 분석 물 - 일부 분석 방법 (일반적으로 흡수 분광법, 방출 분광법 또는 전기 화학을 포함)에 대한 응답으로; 검량선은 분석 물의 농도를 얻기 위해 관심있는 용액의 신호를 보간하거나 외삽하기 위해 사용됩니다.
그러나 솔루션의 다른 구성 요소가 분석 물의 신호를 왜곡하면 어떻게 될까요? 이 왜곡을 행렬 간섭 또는 매트릭스 효과 , 매트릭스 효과가있는 용액은 순수하게 분석 물을 함유 한 용액에 비해 다른 신호를 나타냅니다. 결과적으로, 분석 물만을 함유하는 용액에 기초한 검정 곡선은 분석 물의 농도를 정확하게 결정하는데 사용될 수 없다.
표준 추가로 매트릭스 간섭 극복
행렬 간섭을 극복하기위한 효과적이고 일반적으로 사용되는 기술은 다음과 같습니다. 표준 추가 . 여기에는 알려진 양의 분석 물 ( 표준 )를 분석하고 각각에 응답하여 솔루션의 분석 신호를 측정합니다 부가. (샘플에 표준을 추가하는 것을 일반적으로 " 스파이크 샘플 "). 분석 신호가 매트릭스 효과가있는 상태에서 분석 물의 농도에 비례하여 여전히 변하는 것으로 가정하면, 검량선은 단순 선형 회귀 . 표준을 추가하기 전에 용액에서 분석 물의 농도를 회귀선에서 외삽 할 수 있습니다. 이 외삽 법이 회귀 직선의 플롯과 함께 포스트에서 어떻게 작동하는지 설명하겠습니다.
절차 적으로 표준 추가 분석을 위해 시료를 준비하는 단계는 다음과 같습니다.
1) 동일한 부피로 분석 물을 포함하는 용액의 여러 샘플을 얻습니다.
2) 용액 중 하나를 제외하고 모든 분석 물에 증가하는 알려진 양의 분석 물을 첨가하십시오.
3) 혼합물을 물로 희석하여 모든 용액의 부피가 같도록한다.
이 세 단계가 아래 다이어그램에 나와 있습니다. 최초의 용적 플라스크에 표준 물질이 첨가되어 있지 않음에 주목하십시오.
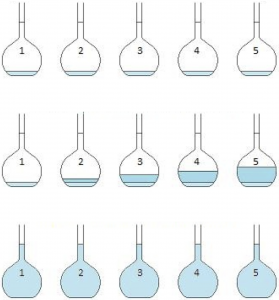
이 위의 이미지는 위키피디아를 통한 Lins4y 약간의 수정을가했습니다.
이 시점에서 5 가지 솔루션은 이제 몇 가지 분석 방법으로 분석 할 준비가되었습니다. 표준에 추가되지 않은 샘플을 포함하여 신호를 정량화하고 솔루션에 추가 된 표준 농도에 대해 플롯합니다. 그런 다음 간단한 선형 회귀 곡선을 데이터에 적용하고 화학 농도를 추정하는 데 사용합니다.
사진 폐기물의은 농도 계산하기 : JMP의 예시
다음 예제는 117-120 페이지의 " 분석 화학 통계학 "JC Miller와 JN Miller (제 2 판, 1988). 사진 필름의 감광성 화학 물질은 할로겐화은 (즉,은과 할로겐 중 하나 인 불소, 브롬, 염소 및 요오드로 만든 이온 화합물)입니다. 따라서,은은 상업적 매립을 위해 사진 낭비로부터 종종 추출된다. 원자 흡광 광도법을 표준 첨가하여 은량이 알려지지 않은 사진 폐기물 샘플을 결정했다. 다음은 JMP의 데이터입니다.
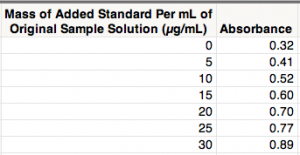
나는 "X에 의한 Y 맞춤"플랫폼 그리고 "맞춤 라인"옵션 아래의 붉은 삼각형 메뉴 구현 단순 선형 회귀 . (이 작업은 "맞춤 맞춤"옵션 ; 설정을 조정하지 않고 "확인"을 클릭하십시오.) 축을 조정하고 캡션을 추가 한 후 다음 그림이 표시됩니다.
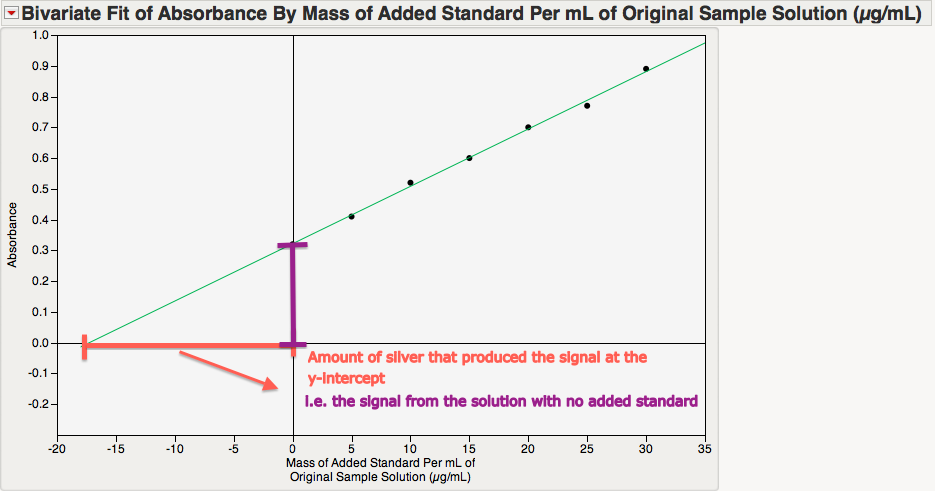
이 도표는이 보정 곡선을 사용하는 주요 아이디어를 보여줍니다. x 절편의 크기는 원래 용액에서 은의 농도입니다. 이유를 이해하려면 다음 두 값에서 흡광도를 고려하십시오.
- x = 0에서, y의 값은 첨가 표준이없는 용액의 흡광도이다 (즉, 우리가 궁극적으로 원하는은 농도에 해당).
따라서 x = 0과 x- 절편 간의 차이의 크기는 원래 관심 대상 솔루션에 대한 신호를 생성하는 데 필요한은 농도입니다! 이제 우리의 임무는 x- 절편을 결정하는 것입니다.
작은 선형 대수학을 사용하여 수학적으로 x- 절편을 얻을 수 있습니다. 그러나 JMP에서 그것을 발견하는 영리한 방법은 " 역 예측 "아래의 기능" 모델에 맞추기 ". (고마워. @markbailey , 또 다른 JMP 블로거,이 트릭에 대한 그의 지침!)
먼저, "Analyze"메뉴의 "Fit Model"을 사용하여 다시 선형 회귀 분석을 실행 해 봅시다.
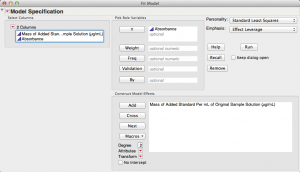
JMP가이 대화 상자 창의 오른쪽 위에 "Standard Least Squares"를 자동으로 제안하는 방법에 유의하십시오.
다음은 "Fit Model"의 출력입니다.
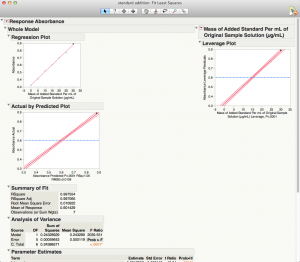
x-intercept를 얻으려면, "Response Absorbance"에 대한 붉은 삼각형 메뉴로가 봅시다. "Estimates"하위 메뉴에서 "Inverse Prediction"을 선택하십시오. 이것은 우리가 주어진 Y 값을 x 값으로 예측할 수있게 해줍니다. x 절편이 필요하기 때문에 y 값 (흡광도)은 0이어야합니다. 유의 수준 1 %를 사용하는 것을 선호하므로 자신감 수준을 0.99로 설정했습니다.
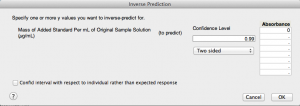
왼쪽 하단에는 "예상 응답보다는 개별 응답과 관련된 신뢰 구간"이라는 옵션이 있으며, 이것이 의미하는 것이 궁금 할 수 있습니다. 이 옵션을 사용하면 예측 간격 , 이것은 "Absorbance = 0"에서의 새로운 관측치의 x- 값 (은 농도)에 대한 확신을 수치화합니다. 대조적으로, 신뢰 구간은 특정 흡광도에서 평균은 농도에 대한 확신을 정량화합니다. 예측 간격은 두 가지 변형 소스를 고려합니다.
신뢰 구간은 첫 번째 변동 요인 만 고려하므로 예측 간격보다 좁습니다.
흡광도가 0 일 때 x- 절편 만 관찰하고 새로운 관측은 아니기 때문에이 옵션을 선택하지 않고 신뢰 구간을 사용하도록합시다.
결과 창 하단에 추가 된 출력이 있습니다.
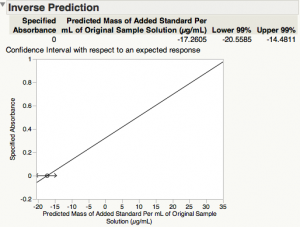
x- 절편 (흡광도가 0 일 때 표준 용액에서은 농도)은 17.2605 μg / mL이고 99 % 신뢰 구간은 14.4811, 20.5585이다.
결론
표준 첨가는 분석 신호를 방해하는 다른 화학 물질의 존재하에 분석 물의 농도를 결정하는 간단하면서도 효과적인 방법입니다. 단순 선형 회귀의 사용은 "Fit Model"플랫폼을 사용하여 JMP에서 쉽게 구현 및 시각화 할 수 있으며 "역 예측"기능은 분석 물 농도를 예측할뿐만 아니라 신뢰 구간을 생성하는 쉬운 방법을 제공합니다 .
참고 문헌
JC Miller와 JN Miller. 분석 화학 통계. 1988 년 2 판, Ellis Horwood Limited. 117-120 쪽.
G. Gruce와 P. Gill. " 표준 추가 분석에서 정밀도 추정치. "Journal of Chemical Education, Volume 76, June 1999.
Eric Cai는 캐나다 토론토의 Environics Analytics에서 데이터 과학 컨설턴트로 일하고 있습니다. 그는 자신의 블로그를 통해 통계, 기계 학습, 화학 및 수학에 대한 열정을 공유하고, 화학 통계학 자 ; 그의 유튜브 채널 ; 그리고 그의 트위터 @chemstateric 피드 . 이것은 JMP의 게스트 블로거로서의 Eric의 첫 번째 게시물입니다.
에릭 카이 쓴 :
네가 좋아하는 걸 기쁘다, 러스! 꼭 추가 기능 사용자가 사용할 수있을 때마다 참조하십시오.
Russ Wolfinger 쓴 :
좋은 게시물에 대한 에릭 감사합니다. 우연히도, 나는 교정 곡선을위한 새로운 애드 인 (add-in)을 연구 중이다. JMP 파일 교환에 초기 버전을 밀어 넣었습니다. 희망이 있습니다. 문서에서이 블로그를 참조하고 추가 기능을 사용하여 동일한 결과를 얻는 방법을 보여줍니다. 추가 기능은 별도의 JMP 테이블에서 역 예측 포인트를 가져 와서 편리하게 결과를 해당 테이블로 다시 복사합니다. 또한 4 매개 변수 물류 모델을 제공하며 여러 변수를 처리합니다. 친절히, 러스
에릭 카이 쓴 :
고마워, 라이언! 여러분의 의견을 듣고 정말 반가워요. JMP의 게스트 블로거로서 저의 첫 번째 글에 들러서 기쁩니다!
당신은 선형 회귀 분석에 적용된 통계 수업에서 매우 훌륭한 조교 였으므로 교육 노동의 결실이 이제이 블로그에 표시됩니다!
에릭 카이 쓴 :
다른 도메인에서 유용한 응용 프로그램을 찾은 것을 기쁘게 생각합니다, 루! 읽어 주셔서 감사합니다!
에릭 카이 쓴 :
긍정적 인 피드백을 주셔서 감사합니다, 필 - 당신이 그것을 좋아했기 때문에 기쁩니다! 나는 밀러와 밀러의 책도 좋아했습니다!
라이언 리키 베츠 쓴 :
안녕 에릭,
잘 했어. JMP 블로그에 게시하는 것을 보니 잘됐다!
건배, Ryan
표준 추가로 화학 물질 농도를 결정 : JMP에서 선형 회귀의 응용 - A 게스트 블로그 게시물에 대한 JMP 블로그 | 화학 통계학 자 쓴 :
JMP 블로깅 커뮤니티는 많은 격려와 격려로 JMP 블로그에 첫 번째 게시물을 게시하게되어 기쁩니다! The Chemical Statistician의 전통에 따라,이 게시물은 내 [â |]
Lou V 쓴 :
안녕 에릭,
이 역 예측은 모기지 데이터를 분석하는 데 매우 유용한 도구를 제공했습니다. 월간 원금을 월별로 지불하면 내 지불 금액이 0 일 때 정확한 날짜를 예측할 수있었습니다 
감사합니다, Lou V
필 케이 쓴 :
안녕 에릭,
그레이트 포스트. 분석 화학자에게 JMP가 얼마나 유용한 지 보여주는 완벽한 예입니다.
BTW, Miller & Miller는 통계에서 제가 가장 좋아하는 책 중 하나입니다.
필
에릭 카이 쓴 :
안녕 루,
"샘플 복제"가 의미하는 바를 정확히 이해한다면 각은 농도별로 여러 흡광도가 측정되는지 궁금해 할 것입니다. 제임스 밀러 (James N. Miller)와 제인 밀러 (Jane C. Miller)의 "Statistics and Chemometrics"제 4 판 125 페이지에이 데이터가 있습니다. 이 책을 다시 확인한 후에은 농도별로 여러 개의 흡광도가 보이지 않습니다. 따라서, 복제 샘플은 존재하지 않았다.
너는 좋은 지적을 제기한다, 루. 회귀 함수의 추정에서 무작위적인 변화의 영향을 줄이기 위해 복제를 사용하고 궁극적으로 원래의은 농도를 추정하는 것이 좋은 생각이라고 생각합니다. 복제는 다양한 통계 분야, 특히 실험 설계에서 무작위 편차의 영향을 줄이기 위해 사용됩니다. 여러분의 의견이 지적했듯이 이것은 표준 추가를위한 좋은 아이디어입니다!
Lou V 쓴 :
에릭,
이 연구에서 복제 샘플을 채취 했습니까? 이 사례는 28 년 동안 Kodak에서 일한 이래로 내 마음에 가깝고 사랑스런 결과를 얻었으며 분석가들은 종종은 회수 과정에서 그러한 샘플을 평가했습니다. 일반적으로보고 된 값은 예를 들어 3 개의 반복 샘플의 평균값입니다.
