Nota del editor: Esta publicación fue escrita por @eric_cai , un químico y estadístico que también bloguea en El estadístico químico . Sigue a Eric en Twitter @chemstateric .
Una de las tareas más comunes en química es determinar la concentración de un producto químico en una solución acuosa (es decir, el producto químico se disuelve en agua, con otros productos químicos posiblemente en la solución). Una forma común de realizar esta tarea es crear una curva de calibración midiendo las señales de conocido cantidades del producto químico de interés - a menudo llamado el analito - en respuesta a algún método analítico (que comúnmente involucra espectroscopia de absorción, espectroscopia de emisión o electroquímica); La curva de calibración se utiliza para interpolar o extrapolar la señal de la solución de interés para obtener la concentración del analito.
Sin embargo, ¿qué pasa si otros componentes en la solución distorsionan la señal del analito? Esta distorsión se llama interferencia de la matriz o efecto matriz y una solución con un efecto de matriz daría una señal diferente en comparación con una solución que contenga únicamente el analito. En consecuencia, una curva de calibración basada en soluciones que contienen solo el analito no se puede utilizar para determinar con precisión la concentración del analito.
Superar las interferencias de la matriz con la adición estándar
Una técnica efectiva y comúnmente utilizada para superar las interferencias de la matriz es adición estándar . Esto implica agregar cantidades conocidas del analito (el estándar ) a la solución de interés y la medición de las señales analíticas de la solución en respuesta a cada adición. (Agregar el estándar a la muestra comúnmente se llama " clavar la muestra. ") Suponiendo que la señal analítica aún cambie proporcionalmente a la concentración del analito en presencia de efectos de matriz, se puede obtener una curva de calibración basada en Regresión lineal simple . La concentración del analito en la solución antes de cualquier adición del estándar se puede extrapolar de la línea de regresión; Explicaré cómo funciona esta extrapolación más adelante en el post con un gráfico de la línea de regresión.
A modo de procedimiento, aquí están los pasos para preparar las muestras para el análisis en adición estándar:
1) Obtenga varias muestras de la solución que contiene el analito en volúmenes iguales.
2) Agregue cantidades crecientes y conocidas del analito a todas menos una de las soluciones.
3) Diluya la mezcla con agua para que todas las soluciones tengan volúmenes iguales.
Estos tres pasos se muestran en el diagrama a continuación. Observe que no se agregó ningún estándar al primer matraz volumétrico.
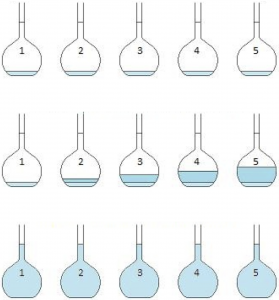
Esta imagen de arriba fue hecha por Lins4y a través de Wikimedia Con algunas ligeras modificaciones.
En este punto, las cinco soluciones ahora están listas para ser analizadas por algún método analítico. Las señales se cuantifican y se representan en función de las concentraciones de los estándares que se agregaron a las soluciones, incluida una muestra que no tenía ningún estándar agregado. Una curva de regresión lineal simple puede ajustarse a los datos y usarse para extrapolar la concentración química.
Determinación de la concentración de plata en residuos fotográficos: un ejemplo ilustrativo en JMP
El siguiente ejemplo es de las páginas 117-120 en " Estadística de Química Analítica "por JC Miller y JN Miller (2ª edición, 1988). Los productos químicos sensibles a la luz en la película fotográfica son haluros de plata (es decir, compuestos iónicos hechos de plata y uno de los halógenos: flúor, bromo, cloro y yodo). Por lo tanto, la plata a menudo se extrae de los residuos fotográficos para la recuperación comercial. Se determinó una muestra de residuos fotográficos que contenían una cantidad desconocida de plata mediante adición estándar con espectroscopia de absorción atómica. Aquí están los datos en JMP:
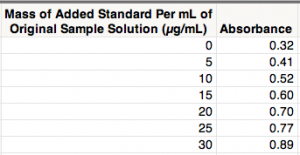
Usé el Plataforma "Fit Y by X" y el Opción "Fit Line" bajo la menú de triángulo rojo para implementar Regresión lineal simple . (También puedes hacer esto con la Opción "Fit Special" ; simplemente haga clic en "Aceptar" sin ajustar ninguna configuración.) Después de ajustar los ejes y agregar algunos títulos, obtengo la siguiente gráfica:
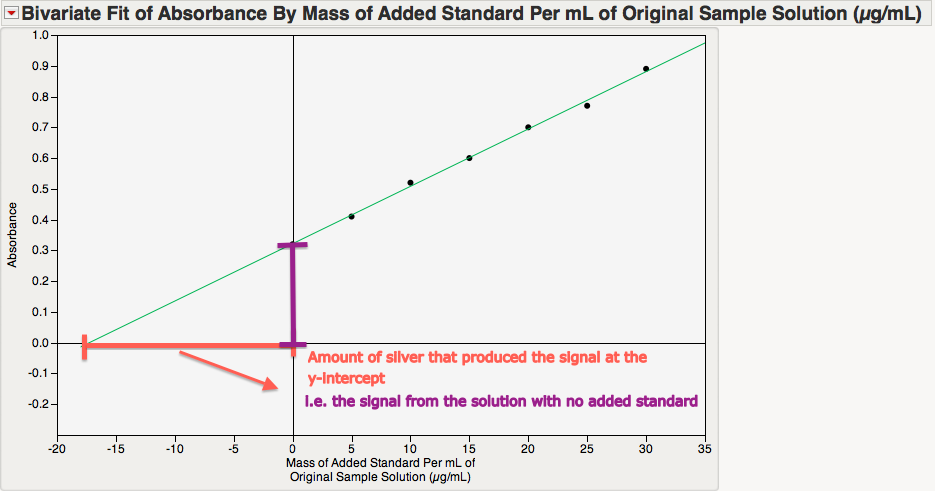
Esta gráfica ilustra la idea clave detrás del uso de esta curva de calibración. La magnitud de la intersección x es la concentración de la plata en la solución original. Para entender por qué esto es así, considere la absorbancia en los siguientes dos valores:
- en x = 0, el valor de y es la absorbancia de la solución sin un estándar agregado (es decir, corresponde a la concentración de plata que finalmente queremos).
- en la intersección x, no hay absorbancia.
Por lo tanto, la magnitud de la diferencia entre x = 0 y la intersección x es la concentración de plata que se necesita para producir la señal para la solución original de interés. Nuestro trabajo ahora es determinar la intersección x.
Usando un poco de álgebra lineal, podemos obtener matemáticamente la intersección con x. Sin embargo, hay una forma inteligente de encontrarlo en JMP usando el " Predicción inversa "función bajo" Modelo de ajuste ". (Agradezco @markbailey , otro blogger de JMP, por su orientación en este truco!)
Primero, ejecute nuevamente la regresión lineal con "Ajustar modelo" en el menú "Analizar".
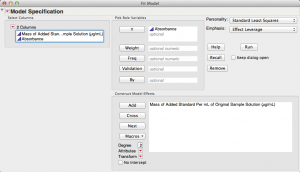
Observe cómo JMP sugiere automáticamente "Mínimos cuadrados estándar" en la parte superior derecha de esta ventana de diálogo.
Aquí está la salida de "Fit Model".
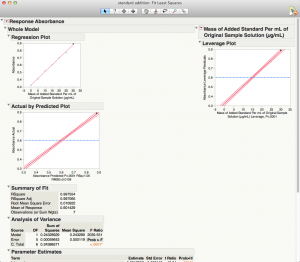
Ahora, para obtener la intersección con x, vamos al menú del triángulo rojo para "Absorción de respuesta". Dentro del submenú "Estimaciones", elija "Predicción inversa". Esto nos permite predecir un valor x dado un valor y. Dado que necesitamos el intercepto x, el valor y (absorbancia) debe ser cero. Prefiero usar un nivel de significación del 1%, así que establezco mi nivel de confianza en 0.99.
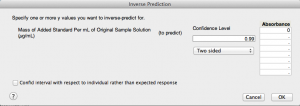
Hay una opción en la parte inferior izquierda que dice "Intervalo de confianza con respecto a la respuesta individual en lugar de la esperada", y puede que se esté preguntando qué significa. Esta opción le permite obtener el intervalo de predicción , que cuantifica qué tan seguro estoy sobre el valor x (concentración de plata) de una nueva observación en "Absorbancia = 0". En contraste, un intervalo de confianza cuantifica cuán seguro estoy sobre la concentración media de plata en esa absorbancia en particular. Un intervalo de predicción tiene en cuenta dos fuentes de variación:
- Variación en la estimación del valor x medio.
- Variación en el muestreo de una nueva observación.
Un intervalo de confianza solo toma en cuenta la primera fuente de variación, por lo que es más estrecho que un intervalo de predicción.
Ya que me interesa el x-intercept solo y no una nueva observación con absorbancia cero, dejemos esa opción sin marcar y solo usamos un intervalo de confianza.
Aquí está el resultado que se ha agregado al final de esta ventana de resultados.
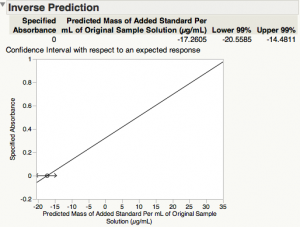
La estimación del intercepto x (concentración de plata en la solución estándar con absorbancia cero) es de 17.2605 µg / ml y su intervalo de confianza del 99% [14.4811, 20.5585].
Conclusión
La adición estándar es un método simple pero efectivo para determinar la concentración de un analito en presencia de otros químicos que interfieren con su señal analítica. Su uso de regresión lineal simple se puede implementar y visualizar fácilmente en JMP usando la plataforma "Fit Model", y su función de "Predicción inversa" proporciona una manera fácil no solo de estimar la concentración del analito, sino también de generar un intervalo de confianza para él. .
Referencias
JC Miller y JN Miller. Estadística de Química Analítica. 2ª Edición, 1988, Ellis Horwood Limited. Páginas 117-120.
G. Gruce y P. Gill. " Estimaciones de precisión en un análisis de adición estándar. "Revista de educación química, volumen 76, junio de 1999.
Eric Cai trabaja como Consultor de Ciencia de Datos en Environics Analytics en Toronto, Canadá. Él comparte su pasión por las estadísticas, el aprendizaje automático, la química y las matemáticas a través de su blog, El estadístico químico ; su Canal de Youtube ; y su Twitter feed @chemstateric . Esta es la primera publicación de Eric como blogger invitado para JMP.
Eric Cai escribió:
Hola Lou
Si entiendo lo que quiere decir con "replicar muestras" correctamente, se pregunta si se midieron múltiples absorbancias en cada concentración de plata. Encontré este conjunto de datos en la página 125 de la 4ª edición de "Statistics and Chemometrics" por James N. Miller y Jane C. Miller; Después de haber revisado este libro nuevamente, no veo múltiples absorbancias para cada concentración de plata. Por lo tanto, no hubo muestras replicadas.
Levantas un buen punto, Lou. Creo que es una buena idea usar la replicación para reducir el efecto de la variación aleatoria en la estimación de la función de regresión y, en última instancia, la estimación de la concentración de plata original. La replicación se utiliza para reducir el efecto de la variación aleatoria en muchas áreas de las estadísticas, especialmente el diseño experimental. ¡Como su comentario señala, esta es una buena idea para la adición estándar, también!

