Anmerkung des Herausgebers: Dieser Beitrag wurde von geschrieben @eric_cai , Chemiker und Statistiker, der auch bei bloggt Der chemische Statistiker . Folgen Sie Eric auf Twitter @chemstateric .
Eine der häufigsten Aufgaben in der Chemie ist die Bestimmung der Konzentration einer Chemikalie in einer wässrigen Lösung (dh die Chemikalie wird in Wasser gelöst, wobei andere Chemikalien möglicherweise in der Lösung vorliegen). Ein üblicher Weg, um diese Aufgabe zu erfüllen, ist das Erstellen einer Kalibrierungskurve durch Messung der Signale von bekannt Mengen der Chemikalie von Interesse - oft auch als Analyt - als Reaktion auf einige Analysemethoden (üblicherweise mit Absorptionsspektroskopie, Emissionsspektroskopie oder Elektrochemie); Die Kalibrierungskurve wird dann verwendet, um das Signal der interessierenden Lösung zu interpolieren oder zu extrapolieren, um die Konzentration des Analyten zu erhalten.
Was aber, wenn andere Komponenten in der Lösung das Signal des Analyten verzerren? Diese Verzerrung wird als a bezeichnet Matrixinterferenz oder Matrixeffekt und eine Lösung mit einem Matrixeffekt würde ein anderes Signal ergeben als eine Lösung, die nur den Analyten enthält. Folglich kann eine Kalibrierungskurve, die auf Lösungen basiert, die nur den Analyten enthalten, nicht dazu verwendet werden, die Konzentration des Analyten genau zu bestimmen.
Überwindung von Matrixinterferenzen mit Standardaddition
Eine wirksame und häufig verwendete Technik zur Überwindung von Matrixinterferenzen ist Standardaddition . Dazu werden bekannte Mengen des Analyten zugegeben (die Standard ) auf die interessierende Lösung und Messung der analytischen Signale der Lösung als Antwort auf jedes Zusatz. (Das Hinzufügen des Standards zur Probe wird allgemein als " Spikes Probe. ") Unter der Annahme, dass sich das Analysesignal in Gegenwart von Matrixeffekten immer noch proportional zur Konzentration des Analyten ändert, kann eine Kalibrierungskurve erhalten werden einfache lineare Regression . Die Konzentration des Analyten in der Lösung vor jeglichen Zugaben des Standards kann dann aus der Regressionslinie extrapoliert werden; Wie diese Extrapolation funktioniert, werde ich später im Beitrag mit einer grafischen Darstellung der Regressionsgeraden erklären.
Verfahrensmäßig sind hier die Schritte zur Vorbereitung der Proben für die Analyse in Standardaddition:
1) Holen Sie mehrere Proben der Lösung, die den Analyten in gleichen Volumina enthält.
2) Alle bis auf eine der Lösungen mit steigenden und bekannten Mengen des Analyten zugeben.
3) Verdünne die Mischung mit Wasser, so dass alle Lösungen gleiche Volumina haben.
Diese drei Schritte sind in der folgenden Abbildung dargestellt. Beachten Sie, dass dem ersten Messkolben kein Standard hinzugefügt wurde.
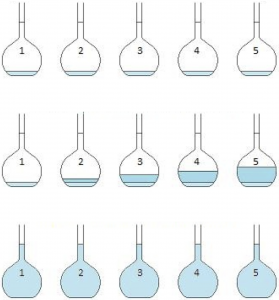
Dieses Bild wurde von gemacht Lins4y über Wikimedia mit einigen geringfügigen Modifikationen.
Zu diesem Zeitpunkt sind die fünf Lösungen nun zur Analyse mit einer Analysemethode bereit. Die Signale werden quantifiziert und gegen die Konzentrationen der Standards aufgetragen, die den Lösungen zugesetzt wurden, einschließlich einer Probe, der kein Standard hinzugefügt wurde. Eine einfache lineare Regressionskurve kann dann an die Daten angepasst und zur Extrapolation der chemischen Konzentration verwendet werden.
Bestimmung der Silberkonzentration in fotografischen Abfällen: Ein Beispiel in JMP
Das folgende Beispiel stammt von Seiten 117-120 in " Statistik für die analytische Chemie "von JC Miller und JN Miller (2. Auflage, 1988). Die lichtempfindlichen Chemikalien auf fotografischen Filmen sind Silberhalogenide (dh ionische Verbindungen aus Silber und einem der Halogene: Fluor, Brom, Chlor und Jod). Daher wird Silber häufig aus fotografischen Abfällen zur kommerziellen Rekultivierung gewonnen. Eine Probe eines fotografischen Abfalls, der eine unbekannte Menge Silber enthielt, wurde durch Standardzugabe mit Atomabsorptionsspektroskopie bestimmt. Hier sind die Daten in JMP:
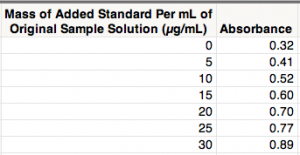
Ich habe die Plattform "Fit by X" und das Option "Linie anpassen" unter dem rotes Dreieck-Menü implementieren einfache lineare Regression . (Sie können dies auch mit tun Option "Anpassen" ; Klicken Sie einfach auf "OK", ohne die Einstellungen zu ändern.) Nachdem Sie die Achsen angepasst und Untertitel hinzugefügt haben, erhalte ich die folgende Grafik:
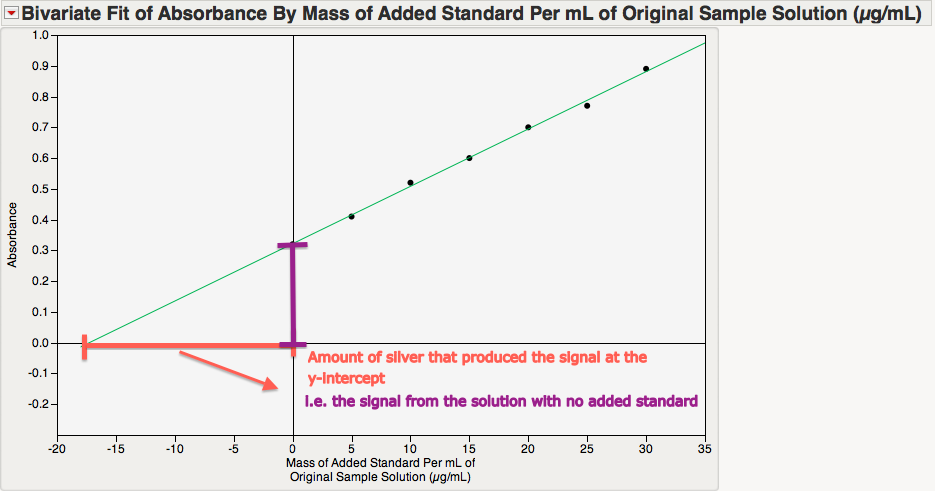
Dieses Diagramm veranschaulicht die Schlüsselidee, die hinter dieser Kalibrierungskurve steht. Die Größe des x-Achsenabschnitts ist die Konzentration des Silbers in der ursprünglichen Lösung. Um zu verstehen, warum dies so ist, betrachten Sie die Extinktion bei den folgenden zwei Werten:
- Bei x = 0 ist der Wert von y die Absorption der Lösung ohne hinzugefügten Standard (dh sie entspricht der Silberkonzentration, die wir letztendlich wünschen).
- Im x-Abschnitt gibt es keine Absorption.
Somit ist die Größe der Differenz zwischen x = 0 und dem x-Achsenabschnitt die Konzentration von Silber, die zur Erzeugung des Signals für die ursprüngliche interessierende Lösung benötigt wird! Unsere Aufgabe ist es nun, den x-Achsenabschnitt zu bestimmen.
Mit etwas linearer Algebra können wir den x-Achsenabschnitt mathematisch erhalten. Es gibt jedoch einen intelligenten Weg, um ihn in JMP zu finden. Inverse Vorhersage "Funktion unter" Modell anpassen ". (Ich danke @ Markbailey , ein anderer JMP-Blogger, für seine Anleitung zu diesem Trick!)
Lassen Sie uns zuerst die lineare Regression erneut über "Fit Model" im Menü "Analyze" ausführen.
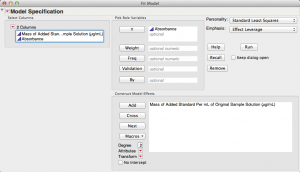
Beachten Sie, dass JMP oben rechts in diesem Dialogfenster automatisch "Standard-Kleinstquadrate" vorschlägt.
Hier ist die Ausgabe von "Fit Model".
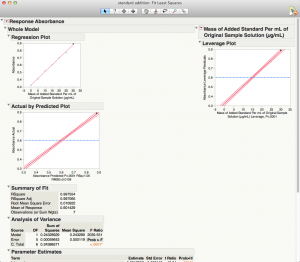
Um den x-Achsenabschnitt zu erhalten, gehen wir zum roten Dreieck-Menü für "Response Absorbance". Wählen Sie im Untermenü "Schätzungen" die Option "Inverse Vorhersage". Dies erlaubt uns, einen x-Wert bei einem y-Wert vorherzusagen. Da wir den x-Achsenabschnitt benötigen, muss der y-Wert (Absorption) Null sein. Ich ziehe es vor, ein Signifikanzniveau von 1% zu verwenden, deshalb setze ich mein Vertrauensniveau auf 0,99.
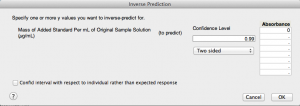
Unten links gibt es eine Option mit der Angabe "Vertrauliches Intervall in Bezug auf die Reaktion des Einzelnen anstelle der erwarteten Reaktion". Möglicherweise fragen Sie sich, was es bedeutet. Diese Option ermöglicht es Ihnen, die Vorhersageintervall , was quantifiziert, wie sicher ich über den x-Wert (Silberkonzentration) einer neuen Beobachtung bei "Absorbanz = 0" bin. Im Gegensatz dazu quantifiziert ein Konfidenzintervall, wie sicher ich über die mittlere Silberkonzentration bei dieser bestimmten Extinktion bin. Ein Vorhersageintervall berücksichtigt zwei Variationsquellen:
- Variation in der Schätzung des mittleren x-Wertes.
- Variation in der Probenahme einer neuen Beobachtung.
Ein Konfidenzintervall berücksichtigt nur die erste Variationsquelle und ist daher schmaler als ein Vorhersageintervall.
Da ich mich nur für den x-Achsenabschnitt interessiere und keine neue Beobachtung bei Null-Extinktion, lassen wir diese Option nicht aktiviert und verwenden einfach ein Konfidenzintervall.
Hier ist die Ausgabe, die am unteren Rand dieses Ergebnisfensters hinzugefügt wurde.
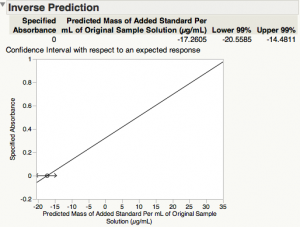
Die Schätzung des x-Achsenabschnitts (Silberkonzentration in der Standardlösung bei Null-Extinktion) beträgt 17,2605 µg / ml und das Konfidenzintervall von 99% [14.4811, 20.5585].
Fazit
Die Standardzugabe ist eine einfache, aber effektive Methode zur Bestimmung der Konzentration eines Analyten in Gegenwart anderer Chemikalien, die sein analytisches Signal stören. Die Verwendung der einfachen linearen Regression kann in JMP mithilfe der Plattform "Fit Model" einfach implementiert und visualisiert werden. Mit der Funktion "Inverse Prediction" können Sie die Konzentration des Analyten nicht nur schätzen, sondern auch ein Konfidenzintervall dafür erstellen .
Verweise
JC Miller und JN Miller. Statistik für die analytische Chemie. 2. Auflage, 1988, Ellis Horwood Limited. Seiten 117-120.
G. Gruce und P. Gill. " Schätzwerte der Genauigkeit in einer Standardadditionsanalyse. "Journal of Chemical Education, Band 76, Juni 1999.
Eric Cai arbeitet als Data Science Consultant bei Environics Analytics in Toronto, Kanada. Er teilt seine Leidenschaft für Statistik, maschinelles Lernen, Chemie und Mathematik über seinen Blog. Der chemische Statistiker ; seine Youtube Kanal ; und sein Twitter-Feed @chemstateric . Dies ist Erics erster Beitrag als Gastblogger für JMP.
Eric Cai schrieb:
Hi Lou,
Wenn ich richtig verstehe, was Sie unter "Proben replizieren" verstehen, fragen Sie sich, ob bei jeder Silberkonzentration mehrere Extinktionen gemessen wurden. Ich fand diesen Datensatz auf Seite 125 der 4. Ausgabe von "Statistics and Chemometrics" von James N. Miller und Jane C. Miller; Nachdem ich dieses Buch erneut durchgesehen habe, sehe ich nicht mehrere Absorptionsgrade für jede Silberkonzentration. Daher gab es keine Wiederholungsproben.
Sie sprechen einen guten Punkt an, Lou. Ich denke, dass es eine gute Idee ist, die Replikation zu verwenden, um den Effekt zufälliger Variationen bei der Abschätzung der Regressionsfunktion und letztendlich der Abschätzung der ursprünglichen Silberkonzentration zu reduzieren. Replikation wird verwendet, um den Effekt zufälliger Variationen in vielen Bereichen der Statistik, insbesondere im experimentellen Design, zu reduzieren. Wie Ihr Kommentar hervorhebt, ist dies auch eine gute Idee für die Standardaddition!

