Note de l'éditeur: Cet article a été écrit par @eric_cai , un chimiste et statisticien qui blogue également à Le statisticien chimique . Suivez Eric sur Twitter @chemstateric .
L'une des tâches les plus courantes en chimie consiste à déterminer la concentration d'un produit chimique dans une solution aqueuse (c'est-à-dire que le produit chimique est dissous dans l'eau, d'autres produits chimiques pouvant se trouver dans la solution). Une méthode courante pour accomplir cette tâche consiste à créer une courbe d’étalonnage en mesurant les signaux de connu quantités de la substance chimique d'intérêt - souvent appelé le analyte - en réponse à une méthode analytique (impliquant généralement la spectroscopie d'absorption, la spectroscopie d'émission ou l'électrochimie); la courbe d'étalonnage est ensuite utilisée pour interpoler ou extrapoler le signal de la solution d'intérêt pour obtenir la concentration de l'analyte.
Cependant, que se passe-t-il si d'autres composants de la solution faussent le signal de l'analyte? Cette distorsion s'appelle un interférence de matrice ou effet de matrice , et une solution à effet de matrice donnerait un signal différent de celui d’une solution contenant uniquement l’analyte. Par conséquent, une courbe d'étalonnage basée sur des solutions contenant uniquement l'analyte ne peut pas être utilisée pour déterminer avec précision la concentration de l'analyte.
Surmonter les interférences de matrice avec l'addition standard
Une technique efficace et couramment utilisée pour surmonter les interférences de la matrice est addition standard . Ceci implique l’ajout de quantités connues de l’analyte (le la norme ) à la solution d’intérêt et à mesurer les signaux analytiques de la solution en réponse à chaque une addition. (L'ajout de la norme à l'échantillon est communément appelé " pointes l'échantillon. ") En supposant que le signal analytique change encore proportionnellement à la concentration de l'analyte en présence d'effets de matrice, une courbe d'étalonnage peut être obtenue sur la base de régression linéaire simple . La concentration de l'analyte dans la solution avant toute addition de l'étalon peut ensuite être extrapolée à partir de la droite de régression; J'expliquerai comment cette extrapolation fonctionne plus tard dans l'article avec un graphique de la droite de régression.
Sur le plan de la procédure, voici les étapes pour préparer les échantillons pour analyse en plus des normes:
1) Obtenir plusieurs échantillons de la solution contenant l'analyte en volumes égaux.
2) Ajouter des quantités croissantes et connues de l'analyte à toutes les solutions sauf une.
3) Diluer le mélange avec de l’eau pour que toutes les solutions aient des volumes égaux.
Ces trois étapes sont illustrées dans le diagramme ci-dessous. Notez qu'aucune norme n'a été ajoutée à la première fiole jaugée.
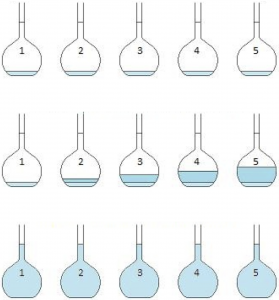
Cette image ci-dessus a été faite par Lins4y via Wikimedia avec quelques légères modifications.
À ce stade, les cinq solutions sont maintenant prêtes à être analysées par une méthode analytique. Les signaux sont quantifiés et comparés aux concentrations des étalons ajoutés aux solutions, y compris un échantillon auquel aucun étalon n'a été ajouté. Une simple courbe de régression linéaire peut ensuite être ajustée aux données et utilisée pour extrapoler la concentration en produit chimique.
Détermination de la concentration en argent dans les déchets photographiques: un exemple illustratif dans JMP
L'exemple suivant provient des pages 117 à 120 de " Statistiques pour la chimie analytique "de JC Miller et JN Miller (2e édition, 1988). Les produits chimiques photosensibles sur le film photographique sont des halogénures d’argent (composés ioniques composés d’argent et d’un des halogènes: fluor, brome, chlore et iode). Ainsi, l'argent est souvent extrait des déchets photographiques pour une récupération commerciale. Un échantillon de déchets photographiques contenant une quantité inconnue d'argent a été déterminé par addition standard avec spectroscopie d'absorption atomique. Voici les données dans JMP:
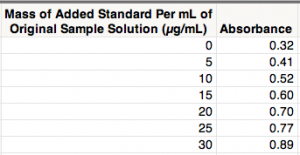
J'ai utilisé le Plate-forme "Fit Y by X" et le Option "Ajuster la ligne" sous le menu triangle rouge implémenter régression linéaire simple . (Vous pouvez aussi le faire avec le Option "Fit Special" ; Cliquez simplement sur "OK" sans régler aucun paramètre.) Après avoir ajusté les axes et ajouté quelques légendes, je reçois le graphique suivant:
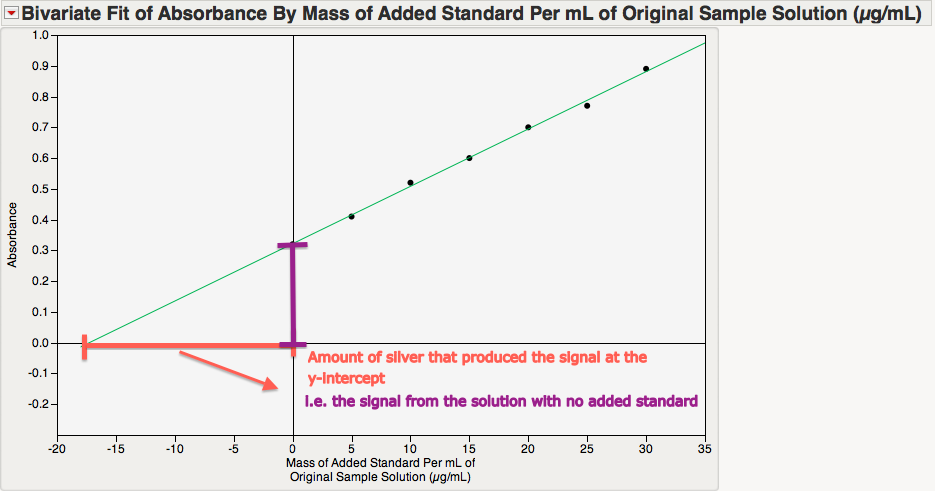
Ce graphique illustre l'idée clé derrière l'utilisation de cette courbe d'étalonnage. La magnitude de l'ordonnée à l'origine est la concentration de l'argent dans la solution d'origine. Pour comprendre pourquoi, considérons l'absorbance aux deux valeurs suivantes:
- à x = 0, la valeur de y est l'absorbance de la solution sans étalon ajouté (c'est-à-dire qu'elle correspond à la concentration d'argent que nous souhaitons au final).
- à l'abscisse, il n'y a pas d'absorbance.
Ainsi, l'amplitude de la différence entre x = 0 et l'ordonnée à l'origine est la concentration en argent nécessaire pour produire le signal de la solution d'intérêt originale! Notre travail consiste maintenant à déterminer l’interception x.
En utilisant un peu d'algèbre linéaire, nous pouvons obtenir mathématiquement l'ordonnée à l'origine. Cependant, il existe un moyen astucieux de le trouver dans JMP en utilisant le " Prédiction Inverse "fonction sous" Modèle ajusté ". (Je remercie @markbailey , un autre blogueur de JMP, pour ses conseils sur cette astuce!)
Commençons d’abord par la régression linéaire avec "Fit Model" dans le menu "Analyze".
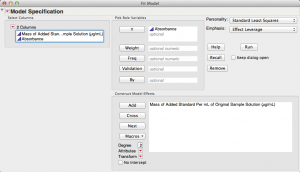
Notez que JMP suggère automatiquement les "moindres carrés standard" en haut à droite de cette boîte de dialogue.
Voici le résultat de "Fit Model".
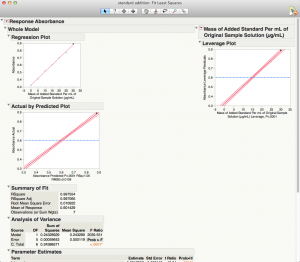
Maintenant, pour obtenir l'ordonnée à l'origine, passons au menu du triangle rouge pour "Absorbance de la réponse". Dans le sous-menu "Estimations", choisissez "Prévision inverse". Cela nous permet de prédire une valeur x à partir d'une valeur y. Puisque nous avons besoin de l'ordonnée à l'origine, la valeur y (absorbance) doit être égale à zéro. Je préfère utiliser un niveau de signification de 1%, je règle donc mon niveau de confiance à 0,99.
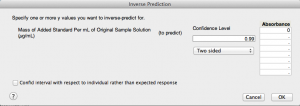
En bas à gauche, une option indique "Intervalle de confiance relatif à la réponse individuelle plutôt qu'attendue" et vous vous demandez peut-être ce que cela signifie. Cette option vous permet d’obtenir le intervalle de prédiction , qui quantifie à quel point je suis certain de la valeur x (concentration en argent) d’une nouvelle observation à "Absorbance = 0". En revanche, un intervalle de confiance quantifie à quel point je suis certain de la concentration moyenne en argent à cette absorbance particulière. Un intervalle de prédiction prend en compte deux sources de variation:
- Variation dans l'estimation de la valeur x moyenne.
- Variation dans l'échantillonnage d'une nouvelle observation.
Un intervalle de confiance ne prend en compte que la première source de variation, il est donc plus étroit qu'un intervalle de prédiction.
Puisque je suis intéressé par la seule x-interception et non par une nouvelle observation à absorption nulle, laissez cette option décochée et utilisons simplement un intervalle de confiance.
Voici la sortie qui a été ajoutée au bas de cette fenêtre de résultats.
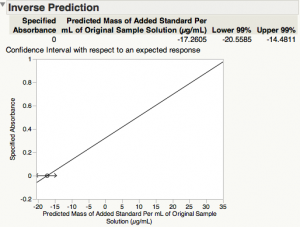
L'estimation de l'ordonnée à l'origine (concentration d'argent dans la solution étalon à absorbance nulle) est de 17,2605 µg / mL et de son intervalle de confiance à 99% [14.4811, 20.5585].
Conclusion
L'addition de standard est une méthode simple mais efficace pour déterminer la concentration d'un analyte en présence d'autres produits chimiques qui interfèrent avec son signal analytique. Son utilisation de la régression linéaire simple peut être facilement implémentée et visualisée dans JMP à l'aide de la plate-forme "Fit Model". Sa fonction "Inverse Prediction" fournit un moyen simple d'estimer non seulement la concentration de l'analyte, mais également de générer un intervalle de confiance. .
Références
JC Miller et JN Miller. Statistiques pour la chimie analytique. 2e édition, 1988, Ellis Horwood Limited. Pages 117-120.
G. Gruce et P. Gill. " Estimations de la précision dans une analyse d'addition standard. "Journal of Chemical Education, Volume 76, juin 1999.
Eric Cai travaille en tant que consultant en science de données chez Environics Analytics à Toronto, au Canada. Il partage sa passion pour les statistiques, l’apprentissage automatique, la chimie et les mathématiques via son blog, Le statisticien chimique ; le sien Chaîne Youtube ; et son Flux Twitter @chemstateric . C'est le premier article d'Eric en tant que blogueur invité pour JMP.
Eric Cai a écrit:
Salut lou,
Si je comprends bien ce que vous entendez par "répliquer des échantillons" correctement, vous vous demandez si plusieurs absorbances ont été mesurées à chaque concentration en argent. J'ai trouvé cet ensemble de données à la page 125 de la 4e édition de "Statistics and Chemometrics" de James N. Miller et Jane C. Miller; Après avoir revérifié ce livre, je ne vois pas plusieurs absorbances pour chaque concentration d’argent. Ainsi, il n'y avait pas d'échantillons répliqués.
Tu soulèves un bon point, Lou. Je pense que l’utilisation de la réplication est une bonne idée pour réduire l’effet de la variation aléatoire dans l’estimation de la fonction de régression et, finalement, dans l’estimation de la concentration en argent d’origine. La réplication est utilisée pour réduire l'effet de la variation aléatoire dans de nombreux domaines de la statistique, en particulier la conception expérimentale. Comme votre commentaire le souligne, c’est aussi une bonne idée pour l’ajout standard!

