Estadística de prueba MANOVAla última vez en analisis multivariable…
En mi blog Sassy Statistician, Aprendimos que el MANOVA es igual que el ANOVA. …con algunos ajustes. Al igual que el ANOVA, el MANOVA divide la varianza en partes, pero ahora la varianza tiene la forma de una matriz en lugar de un número unidimensional.
Tomamos nuestra matriz de varianza (llamada suma de cuadrados y productos cruzados) y la dividimos en dos matrices: la " entre ", que representa la varianza de los vectores medios de nuestro grupo alrededor del vector medio general, y la matriz " dentro ”matriz que representa la varianza de los vectores de datos alrededor de sus vectores medios de grupo. Llamaremos a estas matrices h y mi para Hipótesis ("entre") y Error ("dentro").
Los dejé con un suspenso sobre cómo realizar una prueba de hipótesis con estas matrices, y ahora estoy aquí para cumplirlo.

Hablemos de prueba de hipótesis en un MANOVA.
El ANOVA utiliza la varianza 1d dividida (unidimensional, no OneDirection) para crear una relación F que compara la varianza entre grupos con la varianza dentro de los grupos. El MANOVA hace lo mismo, pero comenzamos con una matriz de varianzas y covarianzas.
Queremos comprimir una matriz en un número para poder compararla tan fácilmente como comparamos varianzas 1d en un ANOVA. Pero hay muchas formas de despellejar a un gato... quiero decir... comprimir una matriz, y todas son válidas. Quizás por esta razón, existen muchas estadísticas de prueba para un MANOVA. Hablaremos de cuatro – así es, cuatro – de los más comunes.
LAMBDA DE WILK
comenzamos con Lambda de Wilk . Usos de Lambda de Wilk determinantes para comprimir matrices en números unidimensionales. Primero, un rápido repaso sobre los determinantes.

Una matriz es realmente una transformación porque cuando multiplicas algo por una matriz, se mueve y se estira. Por ejemplo, la matriz
toma el vector

y lo cambia al vector


La cantidad de “estiramiento” (o, por el contrario, “aplastamiento”) que realiza una matriz está representada por su determinante. Las matrices que estiran las cosas tienen determinantes grandes, y las matrices que aplastan las cosas tienen determinantes pequeños.
La Lambda de Wilk es el determinante de nuestra mi matriz, dividida por el determinante de h +E . Esto nos da una idea de qué tan "grande" es la matriz de varianza dentro del grupo en comparación con la matriz de varianza total (recuerde en nuestro ejemplo, H+E = Varianza total) porque la cantidad que una matriz estira las cosas es una forma de medir qué tan grande es una matriz.
Si hubiera un efecto en nuestros datos, esperaríamos mi ser una parte más pequeña de la varianza total ( h +E ) que h . Dado que el determinante nos dice cuánto estira una matriz un objeto, y la Lambda de Wilk termina siendo una relación de cuánto estira la matriz mi La matriz estira las cosas, en comparación con cuánto la matriz ( h +E ) estira las cosas. Si mi estira las cosas solo un poco en comparación con ( H+E ), obtendremos una Lambda de Wilk más pequeña. A diferencia del estadístico F en un ANOVA, tendemos a rechazar el valor nulo, entonces el Lambda de Wilk es pequeño . Los criterios de rechazo para Lambda de Wilk son un poco más de lo que quiero abordar aquí, así que dejaré ese cálculo en particular a su software estadístico.
HOTELLING-LAWLEY y PILLAI TRACES
Las siguientes dos estadísticas de prueba utilizan algo llamado rastro de una matriz, así que un rápido resumen antes de comenzar.
El rastro de una matriz es la suma de los elementos diagonales de una matriz. No tiene una interpretación geométrica clara como el determinante, pero los dos están relacionados. Lo que no mencioné antes es que el determinante es igual al producto de los valores propios de una matriz. Para obtener más información sobre los valores propios, recomiendo 3Blue1Brown. video sobre el tema.
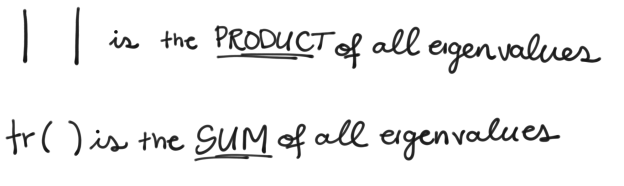
Cada uno de los valores propios tiene un vector propio coincidente. Cuando pensamos en una matriz como una transformación que toma un objeto y lo estira; los vectores propios representan la dirección (o eje) en la que se estira el objeto, y su amigo valor propio te dice hasta qué punto se estira. El determinante es el producto de todos los valores propios, la traza es la suma de ellos. Si bien no nos dan exactamente la misma información, la fuente es la misma.
Está bien lo de las huellas. Veamos las dos estadísticas de prueba que los utilizan: el Hotelling-Lawley Trace , y el Seguimiento de Pillai . Vaya, supongo que todavía estamos hablando de rastros.
El Hotelling-Lawley La versión toma el rastro de la matriz.

Si h es grande en comparación con mi , entonces la traza de Hotelling-Lawley será GRANDE, a diferencia de la Lambda de Wilk, por lo que rechazamos cuando la traza es significativamente grande .

De manera similar, el pillai La versión toma el rastro de la matriz.

Recordar H+E es la cantidad total de varianza, por lo que nuevamente, si h es grande en comparación con la matriz de varianza total ( H+E ), entonces el rastro de Pillai será grande .
RAÍZ MÁXIMA DE ROY
El cuarto y último estadístico de prueba es también una derivada (no en el sentido del cálculo) de los valores propios de nuestra h y mi matrices, pero esta es un poco más simple.La raíz máxima de Roy es el valor propio máximo de

Un valor propio es una “raíz” del polinomio característico de una matriz, más sobre eso aquí .
Al igual que con Hotelling-Lawley Trace,

será grande si h es grande en comparación con mi . Pero como utilizamos sólo el valor propio más grande en lugar de alguna combinación de todos ellos, la raíz máxima de Roy a menudo sobreestima un efecto. Entonces, si alguna vez te encuentras con un caso en el que ninguna de las otras estadísticas de prueba es significativa excepto la raíz de Roy es , lo más probable es que el significado de la raíz de Roy sea un falso positivo y debe ignorarse.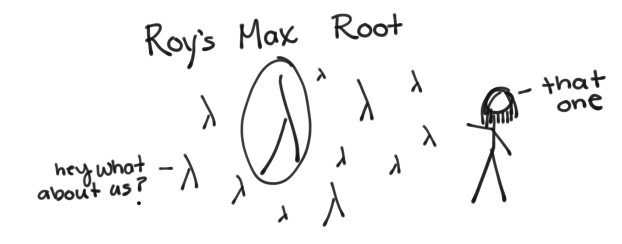
Eso es todo, ya superó todas las estadísticas de prueba y matrices, y casi llegamos al final de este artículo. Puede notar que no he cubierto los valores p aquí, pero su software estadístico le dará un valor p asociado con cada una de estas estadísticas de prueba en función de cada una de sus distribuciones.
En JMP , ejecutar un MANOVA es tan fácil como ejecutar cualquier modelo lineal. Pones todas tus variables de resultado en el cuadro Y, tus predictores en Efectos del modelo y cambias la Personalidad a MANOVA.
Una vez que haga clic en Ejecutar, JMP Se abrirá una ventana para su MANOVA, pero aún debe elegir su Especificación de respuesta. Para un MANOVA básico, JMP recomienda elegir la opción Identidad, pero consulte aquí para otras matrices de contraste que puede utilizar.
 Simple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPMANOVA simple en JMP
Con la matriz de contraste elegida, ahora verá aparecer en la ventana las hermosas estadísticas de la prueba MANOVA. Al igual que con el ANOVA, verás una prueba para todo el modelo, la intersección y una para cada efecto que hayas puesto en tu modelo (aquí solo tenemos uno, grupo).
¿Observa cómo el efecto de intersección solo proporciona una prueba F y no nuestras estadísticas de prueba recién aprendidas? JMP hace esto automáticamente para todos y cada uno de los efectos que tienen un grado de libertad. Con un grado de libertad, las estadísticas de la prueba son equivalentes, por lo que JMP consolida por usted y simplemente informa solo la prueba F.
Al igual que el ANOVA, el MANOVA es una prueba general, lo que significa que una prueba significativa significa que hay alguna diferencia. en algún lugar , pero no nos dirá dónde está. Cuando obtenga un ANOVA significativo, tendrá que probar cada par de grupos para ver dónde está la diferencia en nuestra variable de resultado. En un MANOVA significativo con más de dos grupos y más de dos variables de resultado, no sólo estará inseguro de cuál grupos son diferentes, pero que variables de resultado son responsables de esa diferencia. El MANOVA solo te lo dice ahí es una diferencia, no dónde está. Para eso, necesitaremos algunas pruebas de seguimiento. Pero hablaremos de eso más adelante.


T Aquí hay muchas estadísticas de prueba para un MANOVA. Hablaremos de cuatro – así es, cuatro – de los más comunes.
