MANOVA 테스트 통계마지막으로 다변량 분석…
내 Sassy 통계학자 블로그에서 우리는 MANOVA가 ANOVA와 같다는 것을 배웠습니다. ...몇 가지 수정 사항이 있습니다. ANOVA와 마찬가지로 MANOVA는 분산을 부분으로 분할하지만 이제 분산은 1차원 숫자 대신 행렬의 형태입니다.
우리는 분산 행렬(제곱합과 외적이라고 함)을 두 개의 행렬로 분할했습니다. ~ 사이 전체 평균 벡터 주변의 그룹 평균 벡터의 분산을 나타내는 행렬과 " 이내에 그룹 평균 벡터 주변의 데이터 벡터 분산을 나타내는 행렬입니다. 우리는 이 행렬을 호출할 것입니다. 시간 그리고 이자형 가설("사이") 및 오류("이내")에 대해.
이 행렬로 가설 테스트를 수행하는 방법에 대한 결정적인 문제를 여러분에게 맡겼고 이제 전달하려고 합니다.

다변량 분산 분석의 가설 테스트에 대해 이야기해 봅시다.
ANOVA는 분할된 1d(OneDirection이 아닌 1차원) 분산을 사용하여 그룹 간 분산과 그룹 내 분산을 비교하는 F 비율을 생성합니다. MANOVA는 동일한 작업을 수행하지만 분산 및 공분산의 행렬로 시작합니다.
ANOVA에서 1d 분산을 비교하는 것처럼 쉽게 비교할 수 있도록 행렬을 하나의 숫자로 압축하려고 합니다. 하지만 고양이 가죽을 벗기는 많은 방법이 있습니다...제 말은...행렬을 압축하면 모두 유효합니다. 아마도 이러한 이유로 MANOVA에 대한 많은 테스트 통계가 있습니다. 네 가지에 대해 이야기하겠습니다 – 맞습니다. 네 – 가장 일반적입니다.
윌크의 람다
우리는 시작 윌크의 람다 . Wilk의 Lambda는 다음을 사용합니다. 결정 요인 행렬을 1차원 숫자로 압축합니다. 첫째, 결정 요인에 대한 빠른 복습입니다.

행렬은 무언가를 행렬로 곱하면 이동하고 늘어나기 때문에 실제로 변환입니다. 예를 들어, 행렬
벡터를 취한다

그리고 그것을 벡터로 바꾼다.


행렬이 수행하는 "스트레칭" 또는 반대로 "압박"의 양은 행렬식으로 표시됩니다. 물체를 늘리는 행렬에는 큰 결정 요인이 있고, 찌그러뜨리는 행렬에는 작은 결정 요인이 있습니다.
Wilk의 Lambda는 우리의 결정 요인입니다. 이자형 행렬을 행렬식으로 나눈 값 시간 +E . 이것은 그룹 내 분산 행렬이 전체 분산 행렬과 비교하여 얼마나 "큰"지에 대한 아이디어를 제공합니다(예제에서 기억하십시오. H+E = Total Variance) 행렬이 늘어나는 양은 행렬의 크기를 측정하는 방법이기 때문입니다.
데이터에 영향이 있다면 이자형 전체 분산의 더 작은 부분( 시간 +E ) 보다 시간 . 결정자는 행렬이 객체를 얼마나 늘리는지 알려주고 Wilk의 Lambda는 결국 이자형 행렬은 행렬( 시간 +E ) 물건을 늘립니다. 만약에 이자형 ( H+E ), 우리는 더 작은 Wilk의 Lambda를 얻을 것입니다. ANOVA의 F-통계와 달리 null을 거부하는 경향이 있으며 Wilk의 Lambda는 다음과 같습니다. 작은 . Wilk의 람다에 대한 거부 기준은 제가 여기서 다루고자 하는 것보다 조금 더 많기 때문에 특정 계산은 귀하의 통계 소프트웨어에 맡기겠습니다.
HOTELLING-LAWLEY 및 PILLAI 흔적
다음 두 테스트 통계는 추적하다 시작하기 전에 간단하게 요약하겠습니다.
그만큼 추적하다 행렬의 는 행렬의 대각선 요소의 합입니다. 행렬식과 같은 명확한 기하학적 해석은 없지만 둘은 관련이 있습니다. 내가 이전에 언급하지 않은 것은 결정자가 행렬의 고유값의 곱과 같다는 것입니다. 고유값에 대한 자세한 내용은 3Blue1Brown's를 추천합니다. 동영상 주제에.
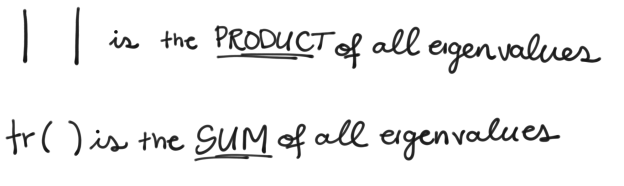
고유값은 각각 일치하는 고유벡터를 가집니다. 행렬을 개체를 가져와 늘리는 변환으로 생각할 때; 고유 벡터는 객체가 늘어나는 방향(또는 축)을 나타내며 고유값 친구는 얼마나 멀리 뻗어 있는지 알려줍니다. 행렬식은 모든 고유값의 곱이고 추적은 이들의 합입니다. 정확히 동일한 정보를 제공하지는 않지만 소스는 동일합니다.
자취에 대해서는 충분합니다. 이를 사용하는 두 가지 테스트 통계를 살펴보겠습니다. 호텔링-라울리 트레이스 , 그리고 필라이 트레이스 . 이런, 우리는 여전히 흔적에 대해 이야기하고 있는 것 같습니다.
그만큼 호텔링-라울리 버전은 행렬의 추적을 취합니다.

만약에 시간 에 비해 크다 이자형 , Wilk의 Lambda와 달리 Hotelling-Lawley 추적은 BIG이므로 추적이 상당히 클 때 거부합니다. 크기가 큰 .

유사하게, 필라이 버전은 행렬의 추적을 취합니다.

기억하다 H+E 분산의 총량이므로 다시 시간 전체 분산 행렬( H+E ), Pillai 추적은 크기가 큰 .
로이의 최대 루트
네 번째이자 마지막 검정 통계량은 또한 우리 시간 그리고 이자형 하지만 이것은 조금 더 간단합니다.로이의 최대 루트 의 최대 고유값

고유값은 행렬의 특성 다항식의 "근"입니다. 여기 .
Hotelling-Lawley Trace와 마찬가지로

큰 경우 시간 에 비해 크다 이자형 . 그러나 우리는 모든 고유값을 조합하는 대신 가장 큰 고유값만 사용하기 때문에 Roy의 Maximum Root는 종종 효과를 과대평가합니다. 따라서 Roy's Root 외에 다른 테스트 통계가 중요하지 않은 경우를 본다면 ~이다 , Roy의 근의 중요성은 거짓 긍정일 가능성이 높으므로 무시해야 합니다.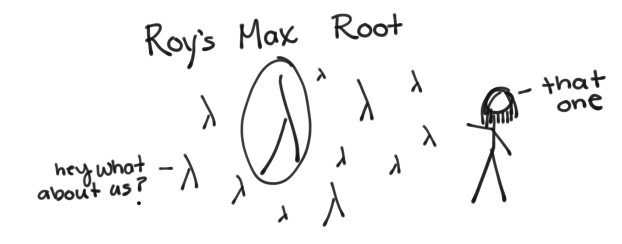
모든 테스트 통계 및 행렬을 통해 만들었고 이 문서의 끝에 거의 도달했습니다. 여기서 p-값을 다루지 않았지만 통계 소프트웨어는 각 분포를 기반으로 이러한 각 테스트 통계와 관련된 p-값을 제공합니다.
~ 안에 JMP , MANOVA를 실행하는 것은 선형 모델을 실행하는 것만큼 쉽습니다. 모든 결과 변수를 Y 상자에, 예측 변수를 모델 효과에 넣고 성격을 MANOVA로 전환합니다.
실행을 클릭하면, JMP MANOVA에 대한 창이 열리지만 여전히 응답 사양을 선택해야 합니다. 기본 다변량 분산 분석의 경우 JMP는 ID 옵션을 선택할 것을 권장하지만 여기 다른 조영제에 사용할 수 있습니다.
 Simple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPJMP의 단순 다변량 분산 분석
대비 매트릭스를 선택하면 이제 아름다운 MANOVA 테스트 통계가 창에 팝업되는 것을 볼 수 있습니다. ANOVA와 마찬가지로 전체 모델, 절편 및 모델에 넣은 각 효과에 대한 테스트가 표시됩니다(여기서는 하나의 그룹만 있음).
가로채기 효과가 F 테스트만 제공하고 새로 학습된 테스트 통계는 제공하지 않는 것을 주목하십시오. JMP는 자유도가 1인 모든 효과에 대해 자동으로 이 작업을 수행합니다. 자유도가 1이면 테스트 통계가 동일하므로 JMP가 자동으로 통합되어 F-테스트만 보고합니다.
ANOVA와 마찬가지로 MANOVA는 옴니버스 테스트입니다. 즉, 유의미한 테스트는 약간의 차이가 있음을 의미합니다. 어딘가에 , 그러나 그것이 어디에 있는지 알려주지 않습니다. 중요한 ANOVA를 얻으면 각 그룹 쌍을 테스트하여 결과 변수의 차이가 어디에 있는지 확인해야 합니다. 3개 이상의 그룹과 3개 이상의 결과 변수가 있는 유의한 다변량 분산 분석에서 어떤 것이 확실하지 않을 뿐만 아니라 여러 떼 다르지만 어느 결과 변수 그 차이를 책임집니다. MANOVA는 당신에게 거기에 대해 알려줍니다. ~이다 차이가 아니라 어디에 있는지. 이를 위해서는 몇 가지 후속 테스트가 필요합니다. 그러나 나중에 더 자세히 설명합니다.


티 다음은 MANOVA에 대한 많은 테스트 통계입니다. 4가지에 대해 이야기하겠습니다 – 맞습니다. 네 – 가장 일반적입니다.
