MANOVA 検定統計前回は多変量解析…
私の生意気な統計学者のブログでは、 MANOVA は ANOVA とまったく同じであることを学びました…いくつかの調整を加えて。 ANOVA と同様に、MANOVA は分散を部分に分割しますが、分散は 1 次元の数値ではなく行列の形式になります。
分散行列 (二乗和と外積と呼ばれる) を 2 つの行列に分割しました。間」行列は、全体の平均ベクトルを中心としたグループ平均ベクトルの分散を表します。内で」行列は、グループ平均ベクトルの周りのデータ ベクトルの分散を表します。 これらを行列と呼びますHそしてE仮説 (「間」) とエラー (「内」) の場合。
これらの行列を使用して仮説検定を行う方法についてクリフハンガーを残しておきましたが、ここでそれを説明します。

MANOVA での仮説検定について話しましょう。
ANOVA は、分割された 1d (OneDirection ではなく 1 次元) 分散を使用して、グループ間の分散をグループ内の分散と比較する F 比を作成します。 MANOVA も同じことを行いますが、分散と共分散の行列から始めます。
分散分析で 1 次元の分散を比較するのと同じくらい簡単に行列を比較できるように、行列を 1 つの数値に圧縮したいと考えています。 しかし、猫の皮を剥ぐ方法はたくさんあります…つまり…行列を圧縮する方法があり、それらはすべて有効です。 おそらくこの理由から、MANOVA には多くの検定統計量が存在します。 4 つほど話します – そうです、四– 最も一般的なもの。
ウイルクス・ラムダ
まずはウイルクのラムダ。 ウイルクのラムダが使用するもの決定要因行列を 1 次元の数値に圧縮します。 まず、行列式について簡単に復習します。

何かに行列を掛けると、その物が移動したり引き伸ばされたりするため、行列は実際には変換です。 たとえば、マトリックス
ベクトルを取ります

それをベクトルに変更します


行列が行う「伸長」、または逆に「押しつぶす」量は、行列式によって表されます。 物を引き伸ばす行列には大きな行列式があり、物を押しつぶす行列には小さな行列式があります。
ウイルクのラムダは私たちの決定要因ですE行列式を行列式で割ったものH +E 。 これにより、グループ内分散行列が全体分散行列と比較してどの程度「大きい」かがわかります (この例を思い出してください。 H+E = 合計分散) は、行列が物事を引き伸ばす量が行列の大きさを測定する方法であるためです。
データに影響があった場合、次のようになると予想されます。 E分散全体のより小さい部分になる ( H +E ) よりもH 。 行列式は行列がオブジェクトをどれだけ引き伸ばすかを教えてくれるので、ウィルクのラムダは最終的にどれだけ引き伸ばされるかの比率になるからです。 E行列は、行列がどの程度伸びるかに比べて物事を引き伸ばします ( H +E ) 物事を引き伸ばします。 もしE (と比べて物事をほんの少しだけ拡張します) H+E )、より小さなウイルクのラムダが得られます。 ANOVA の F 統計の場合とは異なり、ヌルを拒否する傾向があるため、ウィルクのラムダは次のようになります。小さい。 Wilk のラムダの拒否基準については、ここでは詳しく説明しません。そのため、その特定の計算については統計ソフトウェアに任せることにします。
ホテリング・ローリーとピライの痕跡
次の 2 つの検定統計量は、と呼ばれるものを使用します。痕跡マトリックスについて説明するので、始める前に簡単におさらいしてください。
の痕跡行列の対角要素の合計です。 行列式のような明確な幾何学的解釈はありませんが、2 つは関連しています。 前に述べなかったのは、行列式は行列の固有値の積に等しいということです。 固有値の詳細については、3Blue1Brown をお勧めします。ビデオ件名に。
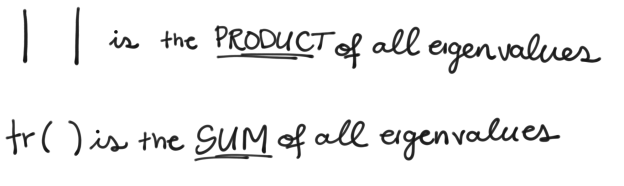
固有値にはそれぞれ対応する固有ベクトルがあります。 マトリックスをオブジェクトを取り込んで引き伸ばす変換として考えると、固有ベクトルはオブジェクトが引き伸ばされる方向 (または軸) を表し、その固有値の友人はオブジェクトがどの程度引き伸ばされたかを示します。 行列式はすべての固有値の積であり、トレースはそれらの合計です。 まったく同じ情報が得られるわけではありませんが、情報源は同じです。
痕跡については十分です。 それらを使用する 2 つの検定統計量を見てみましょう。ホテリング=ローリー・トレース、 そしてそのピライ トレース。 おっと、まだ痕跡について話しているようです。
のホテリング・ローリーバージョンはマトリックスのトレースを取得します

もしHに比べて大きいですEの場合、Wilk のラムダとは異なり、Hotelling-Lawley トレースは大きくなります。そのため、トレースが大幅に大きい場合は拒否されます。大きい。

同様に、ピライバージョンはマトリックスのトレースを取得します

覚えてH+Eは分散の合計量なので、再度、次のようになります。 H総分散行列と比較して大きい ( H+E )、Pillai トレースは次のようになります。大きい。
ロイの最大ルート
4 番目で最後の検定統計量も、(微積分の意味ではなく) 我々の固有値の導関数です。 HそしてE行列ですが、これはもう少し単純です。ロイの最大根の最大固有値です

固有値は行列の特性多項式の「根」です。詳細については、ここ。
Hotelling-Lawley トレースと同様に、

場合は大きくなりますHに比べて大きいですE 。 ただし、すべての固有値を組み合わせたものではなく、最大の固有値のみを使用するため、ロイの最大根は効果を過大評価することがよくあります。 したがって、ロイの根以外の他の検定統計量が有意ではないケースに遭遇した場合は、は、ロイのルートの重要性は誤検知である可能性が高く、無視する必要があります。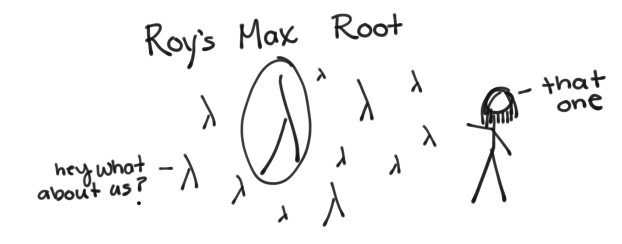
以上です。検定統計量と行列をすべて読み終えて、この記事もほぼ終わりに近づいています。 ここでは p 値について説明していないことに気づいたかもしれませんが、統計ソフトウェアは、各分布に基づいてこれらの検定統計のそれぞれに関連付けられた p 値を提供します。
でJMP MANOVA の実行は、線形モデルを実行するのと同じくらい簡単です。 すべての結果変数を Y ボックスに入力し、予測変数をモデル効果に入力し、パーソナリティを MANOVA に切り替えます。
「実行」をクリックしたら、 JMP MANOVA のウィンドウが開きますが、応答仕様を選択する必要があります。 基本的な MANOVA の場合、JMP は ID オプションを選択することを推奨しますが、次を参照してください。ここ使用できる他のコントラスト マトリックスについては、
 Simple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPJMP での単純な MANOVA
コントラスト マトリックスを選択すると、美しい MANOVA テスト統計がウィンドウにポップアップ表示されます。 ANOVA と同様に、モデル全体の検定、切片、およびモデルに設定した効果ごとに 1 つずつ検定が表示されます (ここではグループが 1 つだけあります)。
切片効果によって F 検定のみが得られ、新しく学習した検定統計が得られないことに注目してください。 JMP は、1 つの自由度を持つあらゆるエフェクトに対してこれを自動的に実行します。 1 つの自由度ではテスト統計は同等であるため、JMP は統合して F テストのみをレポートします。
ANOVA と同様に、MANOVA はオムニバス テストです。つまり、有意なテストは何らかの差があることを意味します。どこかで, しかし、それがどこにあるかは教えてくれません。 有意な ANOVA が得られた場合は、グループの各ペアをテストして、結果変数の違いがどこにあるかを確認する必要があります。 3 つ以上のグループと 2 つ以上の結果変数を含む重要な MANOVA では、どのグループがどれであるかがわからないだけでなく、グループ違いますが、どれ結果変数その違いに責任があるのです。 MANOVA はそこを教えてくれるだけですはどこにあるかではなく、違いです。 そのためには、いくつかの追跡テストが必要です。 しかし、それについては後で詳しく説明します。


Tここに MANOVA の多くの検定統計があります。 4 つほど話します – そうです、四– 最も一般的なもの。
