MANOVA test-statisticheL'ultima volta analisi multivariata…
Nel mio blog Sassy Statistician, abbiamo imparato che il MANOVA è proprio come l'ANOVA …con qualche accorgimento. Proprio come l'ANOVA, il MANOVA suddivide la varianza in parti, ma ora la varianza è sotto forma di matrice invece che di numero unidimensionale.
Abbiamo preso la nostra matrice di varianza (chiamata somma dei quadrati e prodotti incrociati) e l'abbiamo suddivisa in due matrici: fra ” matrice, che rappresenta la varianza dei vettori medi del nostro gruppo attorno al vettore medio complessivo, e la matrice “ entro ” matrice che rappresenta la varianza dei vettori di dati attorno ai loro vettori medi di gruppo. Chiameremo queste matrici H E E per Ipotesi ("tra") ed Errore ("dentro").
Ti ho lasciato con un cliffhanger su come condurre un test di ipotesi con queste matrici, e ora sono qui per consegnare.

Parliamo di test di ipotesi in un MANOVA.
L'ANOVA utilizza la varianza partizionata 1d (unidimensionale, non OneDirection) per creare un rapporto F che confronta la varianza tra i gruppi con la varianza all'interno dei gruppi. Il MANOVA fa la stessa cosa, ma iniziamo con una matrice di varianza e covarianza.
Vogliamo comprimere una matrice in un numero in modo da poterla confrontare con la stessa facilità con cui confrontiamo le varianze 1d in un'ANOVA. Ma ci sono molti modi per scuoiare un gatto... voglio dire... comprimere una matrice, e sono tutti validi. Forse per questo motivo ci sono molte statistiche test per un MANOVA. Parleremo di quattro – è vero, quattro – dei più comuni.
LAMBDA DI WILK
Cominciamo con Lambda di Wilk . Utilizza Lambda di Wilk determinanti per comprimere le matrici in numeri unidimensionali. Innanzitutto, un rapido ripasso sui determinanti.

Una matrice è davvero una trasformazione perché quando moltiplichi qualcosa per una matrice, si sposta e allunga quella cosa. Ad esempio, la matrice
prende il vettore

e lo trasforma nel vettore


La quantità di "allungamento" o, al contrario, "schiacciamento" di una matrice è rappresentata dal suo determinante. Le matrici che allungano le cose hanno grandi determinanti e le matrici che schiacciano le cose hanno piccole determinanti.
La Lambda di Wilk è il determinante del nostro E matrice, divisa per il determinante di H +E . Questo ci dà un'idea di quanto sia "grande" la matrice di varianza all'interno del gruppo rispetto alla matrice di varianza totale (ricorda nel nostro esempio, S+E = varianza totale) perché la quantità di una matrice allunga le cose è un modo per misurare quanto è grande una matrice.
Se ci fosse un effetto nei nostri dati, ci aspetteremmo E essere una parte più piccola della varianza totale ( H +E ) di H . Poiché il determinante ci dice quanto una matrice allunga un oggetto, e il Lambda di Wilk finisce per essere un rapporto di quanto il E matrix allunga le cose, rispetto a quanto matrix ( H +E ) allunga le cose. Se E allunga le cose solo un po' rispetto a ( S+E ), otterremo una Lambda di Wilk più piccola. A differenza della statistica F in un'ANOVA, tendiamo a rifiutare il valore nullo, quindi lo è Lambda di Wilk piccolo . I criteri di rifiuto per il Lambda di Wilk sono un po' più di quanto voglio approfondire qui, quindi lascerò quel particolare calcolo al tuo software statistico.
TRACCE DI HOTELLING-LAWLEY E PILLAI
Le prossime due statistiche test usano qualcosa chiamato the traccia di una matrice, quindi un breve riepilogo prima di iniziare.
IL traccia di una matrice è la somma degli elementi diagonali di una matrice. Non ha una chiara interpretazione geometrica come il determinante, ma i due sono correlati. Quello che non ho detto prima è che il determinante è uguale al prodotto degli autovalori di una matrice. Per ulteriori informazioni sugli autovalori, consiglio 3Blue1Brown's video a questo proposito.
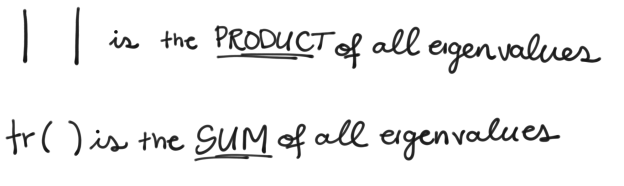
Gli autovalori hanno ciascuno un autovettore corrispondente. Quando pensiamo a una matrice come a una trasformazione che accoglie un oggetto e lo allunga; gli autovettori rappresentano la direzione (o l'asse) in cui l'oggetto è allungato e il suo amico autovalore ti dice quanto è allungato. Il determinante è il prodotto di tutti gli autovalori, la traccia è la loro somma. Anche se non ci danno esattamente le stesse informazioni, la fonte è la stessa.
Va bene per quanto riguarda le tracce. Diamo un'occhiata alle due statistiche-test che le utilizzano: the Hotelling-Lawley Trace , e il Traccia Pillai . Oops, immagino che stiamo ancora parlando di tracce.
IL Hotelling-Lawley version prende la traccia della matrice

Se H è grande rispetto a E , allora la traccia di Hotelling-Lawley sarà GRANDE, a differenza della Lambda di Wilk, quindi rifiutiamo quando la traccia è significativamente grande .

Allo stesso modo, il Pillai version prende la traccia della matrice

Ricordare S+E è l'importo totale della varianza, quindi di nuovo, se H è grande rispetto alla matrice di varianza totale ( S+E ), allora la traccia di Pillai sarà grande .
LA RADICE MASSIMA DI ROY
Anche la quarta e ultima statistica-test è una derivata (non nel senso del calcolo) degli autovalori della nostra H E E matrici, ma questa è un po' più semplice.Radice massima di Roy è il massimo autovalore di

Un autovalore è una "radice" del polinomio caratteristico di una matrice, più su questo Qui .
Proprio come con la traccia Hotelling-Lawley,

sarà grande se H è grande rispetto a E . Ma poiché usiamo solo l'autovalore più grande invece di una combinazione di tutti loro, la radice massima di Roy spesso sopravvaluta un effetto. Quindi, se ti imbatti in un caso in cui nessuna delle altre statistiche dei test è significativa, tranne Roy's Root È , il significato della radice di Roy è molto probabilmente un falso positivo e dovrebbe essere ignorato.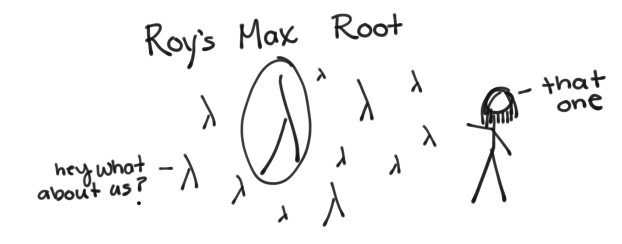
Ecco fatto, hai superato tutte le statistiche e le matrici dei test e siamo quasi arrivati alla fine di questo articolo. Potresti notare che non ho coperto i valori p qui, ma il tuo software statistico ti darà un valore p associato a ciascuna di queste statistiche di test in base a ciascuna delle loro distribuzioni.
In JMP , l'esecuzione di un MANOVA è facile quanto l'esecuzione di qualsiasi modello lineare. Metti tutte le tue variabili di risultato nella casella Y, i tuoi predittori in Effetti del modello e cambia la personalità in MANOVA.
Dopo aver fatto clic su Esegui, JMP si aprirà una finestra per il tuo MANOVA, ma devi ancora scegliere la tua specifica di risposta. Per un MANOVA di base, JMP consiglia di scegliere l'opzione Identità, ma vedere Qui per altre matrici di contrasto è possibile utilizzare.
 Simple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPSemplice MANOVA in JMP
Con la matrice di contrasto scelta, ora vedrai apparire nella finestra le tue bellissime statistiche del test MANOVA. Proprio come con l'ANOVA, vedrai un test per il modello Whole, l'intercettazione e uno per ogni effetto che hai inserito nel tuo modello (qui ne abbiamo solo uno, gruppo).
Nota come l'effetto di intercettazione fornisce solo un test F e non le nostre statistiche di test appena apprese? JMP esegue automaticamente questa operazione per tutti gli effetti che hanno un grado di libertà. Con un grado di libertà, le statistiche del test sono equivalenti, quindi JMP esegue il consolidamento e riporta semplicemente solo il test F.
Proprio come l'ANOVA, il MANOVA è un test omnibus, il che significa che un test significativo significa che c'è qualche differenza in qualche luogo , ma non ci dirà dove si trova. Quando ottieni un ANOVA significativo, dovrai testare ogni coppia di gruppi per vedere dov'è la differenza nella nostra variabile di risultato. In un MANOVA significativo con più di due gruppi e più di due variabili di risultato, non solo non sarai sicuro di quale gruppi sono diversi, ma quali variabili di risultato sono responsabili di tale differenza. Il MANOVA ti dice solo lì È una differenza, non dov'è. Per questo, avremo bisogno di alcuni test di follow-up. Ma ne parleremo più avanti.


T qui ci sono molte statistiche di test per un MANOVA. Parleremo di quattro – è vero, quattro – dei più comuni.
