MANOVA-TeststatistikDas letzte Mal multivariate Analyse…
In meinem Sassy Statistician-Blog: Wir haben gelernt, dass die MANOVA genau wie die ANOVA ist …mit ein paar Änderungen. Genau wie die ANOVA unterteilt die MANOVA die Varianz in Teile, aber jetzt liegt die Varianz in Form einer Matrix statt einer eindimensionalen Zahl vor.
Wir haben unsere Varianzmatrix (Quadratsummen und Kreuzprodukte genannt) genommen und sie in zwei Matrizen aufgeteilt: Die „ zwischen ”-Matrix, die die Varianz unserer Gruppenmittelwertvektoren um den Gesamtmittelwertvektor darstellt, und die „ innerhalb „Matrix, die die Varianz der Datenvektoren um ihre Gruppenmittelvektoren darstellt. Wir nennen diese Matrizen H Und E für Hypothese („zwischen“) und Fehler („innerhalb“).
Ich habe Sie mit einem Cliffhanger darüber zurückgelassen, wie man mit diesen Matrizen einen Hypothesentest durchführt, und jetzt bin ich hier, um es zu liefern.

Lassen Sie uns über das Testen von Hypothesen in einer MANOVA sprechen.
Die ANOVA verwendet die partitionierte 1d-Varianz (eindimensional, nicht OneDirection), um ein F-Verhältnis zu erstellen, das die Varianz zwischen Gruppen mit der Varianz innerhalb von Gruppen vergleicht. Die MANOVA macht das Gleiche, aber wir beginnen mit einer Matrix aus Varianz und Kovarianzen.
Wir möchten eine Matrix in eine Zahl komprimieren, damit wir sie genauso einfach vergleichen können wie 1d-Varianzen in einer ANOVA. Aber es gibt viele Möglichkeiten, eine Katze zu häuten ... ich meine ... eine Matrix zu komprimieren, und alle sind gültig. Vielleicht aus diesem Grund gibt es viele Teststatistiken für eine MANOVA. Wir reden über vier – das stimmt, vier – einer der häufigsten.
WILKS LAMBDA
Wir beginnen mit Wilks Lambda . Wilks Lambda verwendet Determinanten um Matrizen in eindimensionale Zahlen zu komprimieren. Zunächst eine kurze Auffrischung der Determinanten.

Eine Matrix ist eigentlich eine Transformation, denn wenn man etwas mit einer Matrix multipliziert, verschiebt und dehnt es das Ding. Zum Beispiel die Matrix
nimmt den Vektor

und wandelt es in den Vektor um


Das Ausmaß der „Dehnung“ – oder umgekehrt „Stauchung“ – einer Matrix wird durch ihre Determinante dargestellt. Matrizen, die Dinge strecken, haben große Determinanten, und Matrizen, die Dinge stauchen, haben kleine Determinanten.
Wilks Lambda ist die Determinante unseres E Matrix, geteilt durch die Determinante von H +E . Dies gibt uns eine Vorstellung davon, wie „groß“ die Varianzmatrix innerhalb der Gruppe im Vergleich zur Gesamtvarianzmatrix ist (denken Sie in unserem Beispiel daran: H+E = Gesamtvarianz), da der Betrag, um den eine Matrix Dinge streckt, ein Maß dafür ist, wie groß eine Matrix ist.
Wenn es einen Effekt in unseren Daten gäbe, würden wir damit rechnen E ein kleinerer Teil der Gesamtvarianz sein ( H +E ) als H . Da die Determinante uns sagt, um wie viel eine Matrix ein Objekt dehnt, ist Wilks Lambda letztendlich ein Verhältnis davon, um wie viel E Die Matrix streckt die Dinge im Vergleich dazu, wie sehr die Matrix ( H +E ) dehnt die Dinge aus. Wenn E dehnt die Dinge im Vergleich zu ( H+E ), erhalten wir ein kleineres Wilk's Lambda. Anders als bei der F-Statistik in einer ANOVA tendieren wir dazu, die Null abzulehnen, die bei Wilks Lambda der Fall ist klein . Die Ablehnungskriterien für Wilks Lambda sind etwas mehr, als ich hier näher erläutern möchte, daher überlasse ich diese spezielle Berechnung Ihrer Statistiksoftware.
HOTELLING-LAWLEY und PILLAI TRACES
Die nächsten beiden Teststatistiken verwenden etwas namens verfolgen einer Matrix, also eine kurze Zusammenfassung, bevor wir beginnen.
Der verfolgen einer Matrix ist die Summe der Diagonalelemente einer Matrix. Es gibt keine eindeutige geometrische Interpretation wie die Determinante, aber die beiden hängen zusammen. Was ich vorher nicht erwähnt habe, ist, dass die Determinante gleich dem Produkt der Eigenwerte einer Matrix ist. Für weitere Informationen zu Eigenwerten empfehle ich 3Blue1Brown's Video zum Thema.
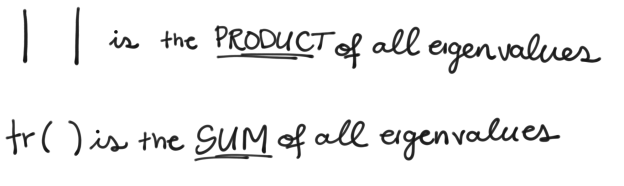
Eigenwerte haben jeweils einen passenden Eigenvektor. Wenn wir uns eine Matrix als eine Transformation vorstellen, die ein Objekt aufnimmt und es dehnt; Die Eigenvektoren stellen die Richtung (oder Achse) dar, in die das Objekt gedehnt wird, und sein Eigenwert Freund sagt Ihnen, wie weit es gedehnt wird. Die Determinante ist das Produkt aller Eigenwerte, die Spur ist deren Summe. Obwohl sie uns nicht genau die gleichen Informationen liefern, ist die Quelle dieselbe.
Alles klar, was die Spuren angeht. Schauen wir uns die beiden Teststatistiken an, die sie verwenden: die Hotelling-Lawley Trace , und das Pillai-Spur . Hoppla, ich schätze, wir reden immer noch über Spuren.
Der Hotelling-Lawley Die Version übernimmt die Spur der Matrix

Wenn H ist groß im Vergleich zu E , dann wird die Hotelling-Lawley-Spur im Gegensatz zu Wilks Lambda GROSS sein, daher lehnen wir sie ab, wenn die Spur signifikant ist groß .

Ebenso die Pillai Die Version übernimmt die Spur der Matrix

Erinnern H+E ist der Gesamtbetrag der Varianz, also noch einmal, wenn H ist groß im Vergleich zur Gesamtvarianzmatrix ( H+E ), dann wird die Pillai-Spur sein groß .
ROY'S MAXIMALE WURZELN
Die vierte und letzte Teststatistik ist ebenfalls eine Ableitung (nicht im Sinne der Analysis) der Eigenwerte von uns H Und E Matrizen, aber diese ist etwas einfacher.Roys maximale Wurzel ist der maximale Eigenwert von

Ein Eigenwert ist eine „Wurzel“ des charakteristischen Polynoms einer Matrix, mehr dazu Hier .
Genau wie bei der Hotelling-Lawley-Spur,

wird groß sein, wenn H ist groß im Vergleich zu E . Da wir jedoch nur den größten Eigenwert anstelle einer Kombination aus allen verwenden, überschätzt Roys Maximum Root häufig einen Effekt. Falls Sie also jemals auf einen Fall stoßen, in dem keine der anderen Teststatistiken außer Roys Wurzel von Bedeutung ist Ist , ist die Bedeutung von Roys Wurzel höchstwahrscheinlich falsch positiv und sollte ignoriert werden.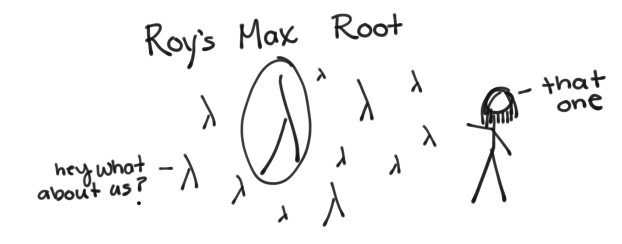
Das war's, Sie haben alle Teststatistiken und Matrizen durchgearbeitet und wir sind fast am Ende dieses Artikels angelangt. Sie werden vielleicht bemerken, dass ich hier nicht auf p-Werte eingegangen bin, aber Ihre Statistiksoftware liefert Ihnen einen p-Wert, der jeder dieser Teststatistiken auf der Grundlage jeder ihrer Verteilungen zugeordnet ist.
In JMP ist das Ausführen einer MANOVA genauso einfach wie das Ausführen eines beliebigen linearen Modells. Sie geben alle Ihre Ergebnisvariablen in das Y-Feld ein, Ihre Prädiktoren in die Modelleffekte und stellen die Persönlichkeit auf MANOVA um.
Sobald Sie auf „Ausführen“ klicken, JMP öffnet ein Fenster für Ihre MANOVA, aber Sie müssen noch Ihre Antwortspezifikation auswählen. Für eine einfache MANOVA empfiehlt JMP die Auswahl der Option „Identität“, aber siehe Hier für andere Kontrastmatrizen können Sie verwenden.
 Simple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPEinfache MANOVA in JMP
Nachdem Sie die Kontrastmatrix ausgewählt haben, werden nun Ihre wunderschönen MANOVA-Teststatistiken im Fenster angezeigt. Genau wie bei der ANOVA sehen Sie einen Test für das gesamte Modell, den Achsenabschnitt und einen für jeden Effekt, den Sie in Ihr Modell eingefügt haben (hier haben wir nur einen, Gruppe).
Beachten Sie, dass der Intercept-Effekt nur einen F-Test ergibt und nicht unsere neu erlernten Teststatistiken? JMP führt dies automatisch für alle Effekte durch, die einen Freiheitsgrad haben. Mit einem Freiheitsgrad sind die Teststatistiken gleichwertig, sodass JMP für Sie konsolidiert und einfach nur den F-Test meldet.
Genau wie die ANOVA ist die MANOVA ein Sammeltest, was bedeutet, dass ein signifikanter Test bedeutet, dass es einen gewissen Unterschied gibt irgendwo , aber es wird uns nicht sagen, wo es ist. Wenn Sie eine signifikante ANOVA erhalten, müssen Sie jedes Gruppenpaar testen, um festzustellen, wo der Unterschied in unserer Ergebnisvariablen liegt. Bei einer signifikanten MANOVA mit mehr als zwei Gruppen und mehr als zwei Ergebnisvariablen sind Sie nicht nur unsicher, welche Gruppen sind unterschiedlich, aber welche Ergebnisvariablen sind für diesen Unterschied verantwortlich. Die MANOVA sagt es Ihnen einfach dort Ist ein Unterschied, nicht dort, wo er ist. Dafür benötigen wir einige Folgetests. Aber dazu später mehr.


T Hier sind viele Teststatistiken für eine MANOVA. Wir reden über vier – das stimmt, vier – einer der häufigsten.
