Statistiques du test MANOVALa dernière fois analyse multivariée…
Sur mon blog Sassy Statisticien, nous avons appris que la MANOVA est comme l'ANOVA …avec quelques ajustements. Tout comme l'ANOVA, la MANOVA divise la variance en parties, mais la variance se présente désormais sous la forme d'une matrice au lieu d'un nombre unidimensionnel.
Nous avons pris notre matrice de variance (appelée sommes des carrés et produits vectoriels) et l'avons divisée en deux matrices : entre ", qui représente la variance des vecteurs moyens de notre groupe autour du vecteur moyen global, et le " dans » matrice qui représente la variance des vecteurs de données autour de leurs vecteurs moyens de groupe. Nous appellerons ces matrices H et E pour l'hypothèse ("entre") et l'erreur ("à l'intérieur").
Je vous ai laissé un cliffhanger sur la façon de réaliser un test d'hypothèse avec ces matrices, et maintenant je suis là pour vous le livrer.

Parlons des tests d'hypothèses dans une MANOVA.
L'ANOVA utilise la variance partitionnée 1D (unidimensionnelle, et non OneDirection) pour créer un rapport F comparant la variance entre les groupes à la variance au sein des groupes. La MANOVA fait la même chose, mais nous commençons par une matrice de variance et de covariances.
Nous voulons compresser une matrice en un seul nombre afin de pouvoir la comparer aussi facilement que nous comparons les variances 1D dans une ANOVA. Mais il existe de nombreuses façons d'écorcher un chat… je veux dire… de compresser une matrice, et toutes sont valables. C'est peut-être pour cette raison qu'il existe de nombreuses statistiques de test pour une MANOVA. Nous parlerons de quatre – c'est vrai, quatre – des plus courants.
LAMBDA DE WILK
Nous commençons par Lambda de Wilk . Le Lambda de Wilk utilise déterminants pour compresser des matrices en nombres unidimensionnels. Tout d’abord, un petit rappel sur les déterminants.

Une matrice est en réalité une transformation car lorsque vous multipliez quelque chose par une matrice, elle déplace et étire cette chose. Par exemple, la matrice
prend le vecteur

et le change en vecteur


Le degré d’« étirement » – ou à l’inverse d’« écrasement » – effectué par une matrice est représenté par son déterminant. Les matrices qui étirent les choses ont de grands déterminants, et les matrices qui écrasent les choses ont de petits déterminants.
Le Lambda de Wilk est le déterminant de notre E matrice, divisée par le déterminant de H +E . Cela nous donne une idée de la « taille » de la matrice de variance intra-groupe par rapport à la matrice de variance totale (rappelez-vous dans notre exemple, H+E = Variance totale) car la mesure dans laquelle une matrice s'étire est une façon de mesurer la taille d'une matrice.
S'il y avait un effet dans nos données, nous nous attendrions E être une plus petite partie de la variance totale ( H +E ) que H . Puisque le déterminant nous indique dans quelle mesure une matrice étire un objet, et que le Lambda de Wilk finit par être un rapport de l'étendue de l'étirement d'un objet. E la matrice étire les choses, par rapport à combien la matrice ( H +E ) étire les choses. Si E n'étire que un peu les choses par rapport à ( H+E ), nous obtiendrons un Lambda de Wilk plus petit. Contrairement à la statistique F dans une ANOVA, nous avons tendance à rejeter la valeur nulle, alors le Lambda de Wilk est petit . Les critères de rejet pour le Lambda de Wilk vont un peu plus loin que ce que je souhaite aborder ici, je vais donc laisser ce calcul particulier à votre logiciel statistique.
TRACES D'HOTELLING-LAWLEY et PILLAI
Les deux statistiques de test suivantes utilisent ce qu'on appelle le tracer d'une matrice, donc un petit récapitulatif avant de commencer.
Le tracer d'une matrice est la somme des éléments diagonaux d'une matrice. Il n’a pas d’interprétation géométrique claire comme le déterminant, mais les deux sont liés. Ce que je n'ai pas mentionné auparavant, c'est que le déterminant est égal au produit des valeurs propres d'une matrice. Pour en savoir plus sur les valeurs propres, je recommande celui de 3Blue1Brown vidéo sur le sujet.
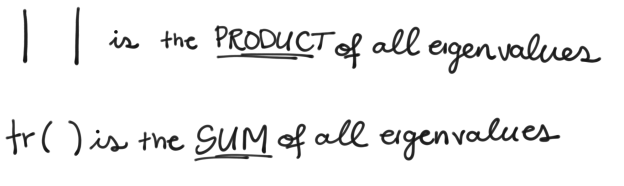
Les valeurs propres ont chacune un vecteur propre correspondant. Lorsque nous considérons une matrice comme une transformation qui englobe un objet et l’étire ; les vecteurs propres représentent la direction (ou l'axe) dans laquelle l'objet est étiré, et sa valeur propre amie vous indique jusqu'où il est étiré. Le déterminant est le produit de toutes les valeurs propres, la trace en est la somme. Même s’ils ne nous donnent pas exactement les mêmes informations, la source est la même.
Très bien pour les traces. Regardons les deux statistiques de test qui les utilisent : le Hotelling-Lawley Trace , et le Trace de Pillai . Oups, je suppose que nous parlons toujours de traces.
Le Hôtelling-Lawley la version prend la trace de la matrice

Si H est grand par rapport à E , alors la trace de Hotelling-Lawley sera GRANDE, contrairement au Lambda de Wilk, donc nous la rejetons lorsque la trace est significativement grand .

De même, le Pillaï la version prend la trace de la matrice

Souviens-toi H+E est le montant total de la variance, donc encore une fois, si H est grand par rapport à la matrice de variance totale ( H+E ), alors la trace Pillai sera grand .
RACINE MAXIMALE DE ROY
La quatrième et dernière statistique de test est également une dérivée (pas au sens du calcul) des valeurs propres de notre H et E matrices, mais celle-ci est un peu plus simple.Racine maximale de Roy est la valeur propre maximale de

Une valeur propre est une « racine » du polynôme caractéristique d’une matrice, plus à ce sujet ici .
Tout comme avec la trace Hotelling-Lawley,

sera grand si H est grand par rapport à E . Mais comme nous utilisons uniquement la plus grande valeur propre au lieu d’une combinaison de toutes, la racine maximale de Roy surestime souvent un effet. Donc, si jamais vous rencontrez un cas où aucune des autres statistiques de test n'est significative à l'exception de la racine de Roy est , la signification de la racine de Roy est très probablement un faux positif et doit être ignorée.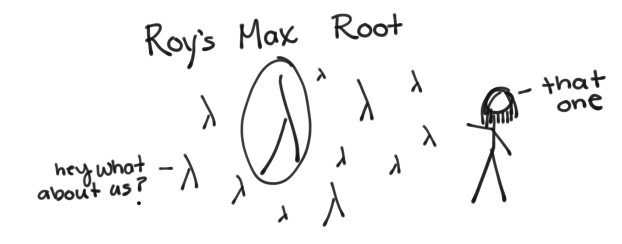
Ça y est, vous avez parcouru toutes les statistiques de test et les matrices, et nous avons presque atteint la fin de cet article. Vous remarquerez peut-être que je n'ai pas abordé les valeurs p ici, mais votre logiciel statistique vous donnera une valeur p associée à chacune de ces statistiques de test en fonction de chacune de leurs distributions.
Dans JMP , exécuter une MANOVA est tout aussi simple que d'exécuter n'importe quel modèle linéaire. Vous placez toutes vos variables de résultat dans la case Y, vos prédicteurs dans les effets du modèle et passez la personnalité sur MANOVA.
Une fois que vous avez cliqué sur Exécuter, JMP ouvrira une fenêtre pour votre MANOVA, mais vous devez toujours choisir votre spécification de réponse. Pour une MANOVA de base, JMP recommande de choisir l'option Identité, mais voir ici pour d'autres matrices de contraste que vous pouvez utiliser.
 Simple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPSimple MANOVA in JMPMANOVA simple dans JMP
Une fois la matrice de contraste choisie, vous verrez maintenant vos magnifiques statistiques de test MANOVA apparaître dans la fenêtre. Tout comme avec l'ANOVA, vous verrez un test pour l'ensemble du modèle, l'interception, et un pour chaque effet que vous avez mis dans votre modèle (ici nous n'en avons qu'un, groupe).
Remarquez comment l'effet d'interception ne donne qu'un test F et non nos statistiques de test nouvellement apprises ? JMP effectue automatiquement cette opération pour tous les effets dotés d'un degré de liberté. Avec un degré de liberté, les statistiques de test sont équivalentes, donc JMP consolide pour vous et rapporte simplement uniquement le test F.
Tout comme l'ANOVA, le MANOVA est un test omnibus, ce qui signifie qu'un test significatif signifie qu'il y a une certaine différence. quelque part , mais il ne nous dira pas où il se trouve. Lorsque vous obtenez une ANOVA significative, vous devrez tester chaque paire de groupes pour voir où se situe la différence dans notre variable de résultat. Dans une MANOVA significative avec plus de deux groupes et plus de deux variables de résultat, vous ne saurez pas seulement laquelle groupes sont différents, mais qui variables de résultat sont responsables de cette différence. Le MANOVA vous le dit juste là est une différence, pas où elle se trouve. Pour cela, nous aurons besoin de tests de suivi. Mais plus là-dessus plus tard.


T voici de nombreuses statistiques de test pour une MANOVA. Nous parlerons de quatre – c'est vrai, quatre – des plus courants.
